
Transformers documentation
Point de contrôle du gradient
Point de contrôle du gradient
Le passage avant met généralement en cache toutes les activations intermédiaires pour les réutiliser lors du passage arrière. Cependant, les activations sont proportionnelles à la taille du lot et à la longueur de la séquence. Le point de contrôle des gradients ne conserve que certaines activations et supprime le reste. Cela oblige le passage arrière à recalculer certaines des activations à la volée au moment où elles sont nécessaires.
Normal training:
  Forward:   [L1]→[L2]→[L3]→[L4]   (save ALL activations)
  Backward:  ←uses cached activations everywhere

Gradient checkpointing:
  Forward:   [L1]→[L2]→[L3]→[L4]   (save only at checkpoints, discard the rest)
  Backward:  ←reaches L2, recomputes L2→L3 from scratch, uses it, discards it
L'entraînement est généralement plus lent car la passe arrière recalcule les activations supprimées, mais le checkpointing réduit la mémoire d'activation.
Définissez gradient_checkpointing=True pour l’activer.
Utilisez avec l'accumulation de gradients pour réduire encore plus l'utilisation de la mémoire.
from transformers import TrainingArguments

args = TrainingArguments(
    ...,
    gradient_checkpointing=True,
)
Point de contrôle partiel
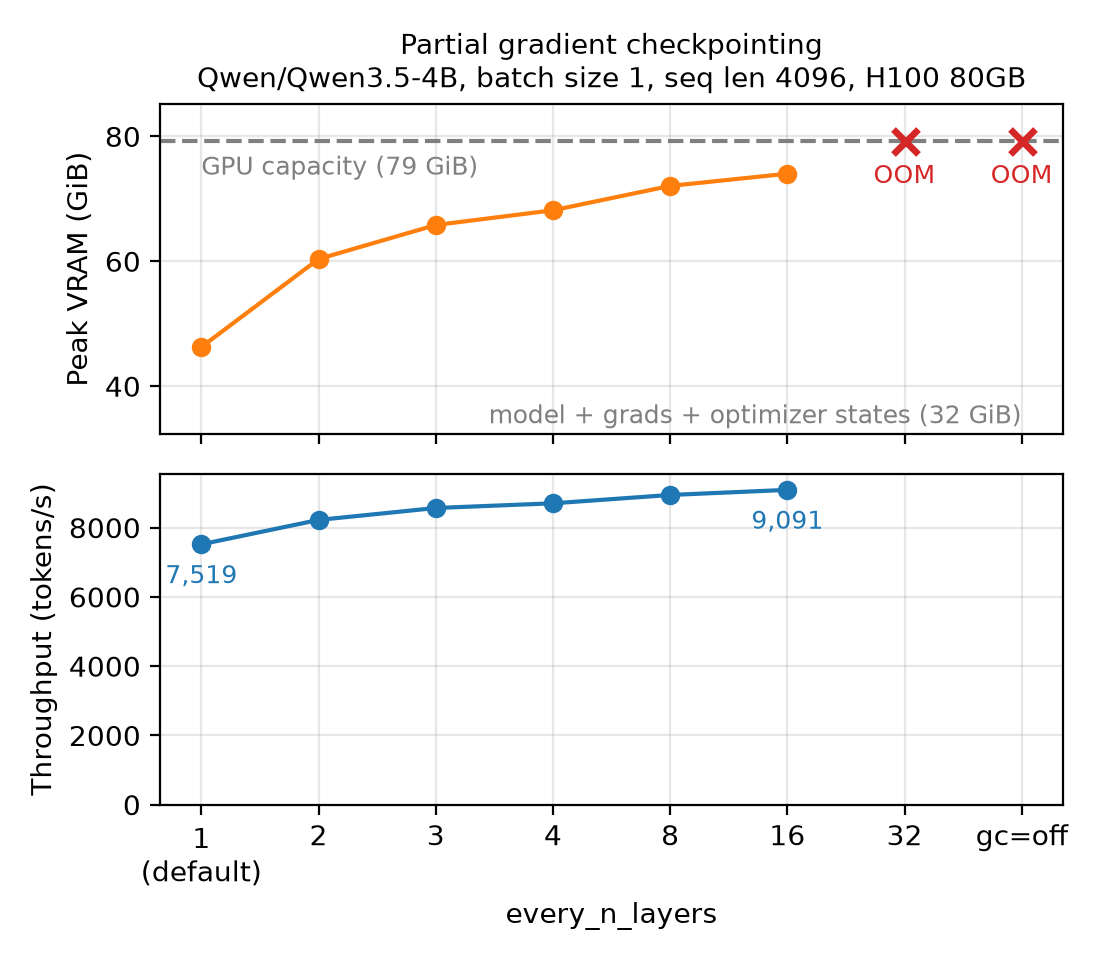
Le checkpointing de gradient complet recalcule chaque couche checkpointable. Si votre exécution dispose d'une marge mémoire, effectuez le checkpointing de moins de couches afin d'échanger une partie des économies de mémoire contre de la vitesse.
Passez every_n_layers à gradient_checkpointing_enable() pour choisir l'intervalle de checkpointing.
every_n_layers=2

Forward:   input  -> [L1] -> [L2] -> [L3] -> [L4] -> [L5] -> [L6]
                      CP     keep     CP     keep     CP     keep

Backward:  output <- [L6] <- [L5] <- [L4] <- [L3] <- [L2] <- [L1]
                     keep   rerun    keep   rerun    keep   rerun
Avec every_n_layers=2, la première couche et chaque couche suivante sur deux sont checkpointées. Les couches checkpointées abandonnent leurs activations pendant le passage avant et les recalculent pendant le passage arrière, tandis que les autres couches conservent leurs activations en mémoire.
model.gradient_checkpointing_enable(every_n_layers=2)Par défaut, every_n_layers=1, chaque couche est checkpointée. Des valeurs plus élevées checkpointent la première couche, puis toutes les n couches suivantes, en laissant les activations des autres couches en mémoire. Par exemple, every_n_layers=2 checkpointe les couches 1, 3, 5, et ainsi de suite. Seuls les modules qui héritent de GradientCheckpointingLayer sont comptés. Les autres modules qui prennent en charge le checkpoint de gradient restent activés.
Pour utiliser le checkpointing partiel des gradients avec Trainer, définissez every_n_layers dans gradient_checkpointing_kwargs.
from transformers import TrainingArguments

args = TrainingArguments(
    ...,
    gradient_checkpointing=True,
    gradient_checkpointing_kwargs={"every_n_layers": 4},
)
Déchargement des activations enregistrées
Le gradient checkpointing conserve une activation par couche checkpointée sur le GPU. Pour de longues longueurs de séquence, cela peut consommer une quantité importante de mémoire (environ layers x sequence x hidden x bytes_per_element). Définissez offload pour stocker ces activations en mémoire hôte épinglée, au prix d’une copie de l’appareil vers l’hôte pendant le passage avant et d’une copie de l’hôte vers l’appareil pendant le passage arrière.
from transformers import TrainingArguments

args = TrainingArguments(
    ...,
    gradient_checkpointing=True,
    gradient_checkpointing_kwargs={"offload": True},
)
Les deux copies s’exécutent sur le flux de calcul, ce qui échange une étape plus lente contre de la mémoire. Utilisez cette approche lorsqu’une exécution ne tient pas autrement, et non pour accélérer une exécution.
Étapes suivantes
- Consultez le document utilisation de la mémoire GPU pour comprendre ce qui entraîne l'utilisation de la mémoire sur le GPU pendant l'entraînement.
- Consultez le guide Entraînement en précision mixte pour apprendre à utiliser des types de données de précision inférieure afin de réduire davantage la mémoire et d’accélérer l’entraînement.
- Consultez le guide Kernels pour apprendre à accélérer l’entraînement à l’aide de noyaux fusionnés personnalisés.