
Transformers documentation
V-JEPA 2
Mô hình này được công bố trên HF papers vào ngày 2025-06-11 và được đóng góp cho Hugging Face Transformers vào ngày 2025-06-11.


V-JEPA 2
V-JEPA 2 (bài đăng trên blog) là một phương pháp tự giám sát để huấn luyện các bộ mã hóa video do FAIR, Meta phát triển. Sử dụng dữ liệu video ở quy mô internet, V-JEPA 2 đạt hiệu suất tiên tiến nhất (state-of-the-art) trên các tác vụ hiểu chuyển động và dự đoán hành động của con người. V-JEPA 2-AC là một mô hình thế giới có điều kiện hành động trong không gian ẩn (latent action-conditioned world model) được huấn luyện bổ sung (post-trained) từ V-JEPA 2 (sử dụng một lượng nhỏ dữ liệu tương tác quỹ đạo robot), giải quyết các tác vụ thao tác robot mà không cần thu thập dữ liệu cụ thể cho môi trường, huấn luyện cụ thể cho tác vụ hay hiệu chuẩn.
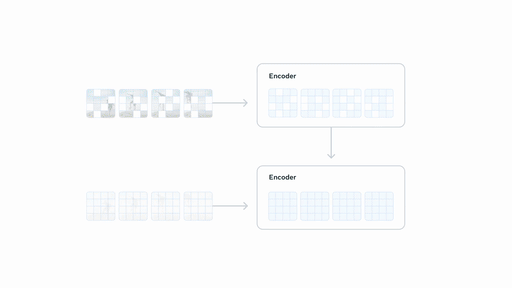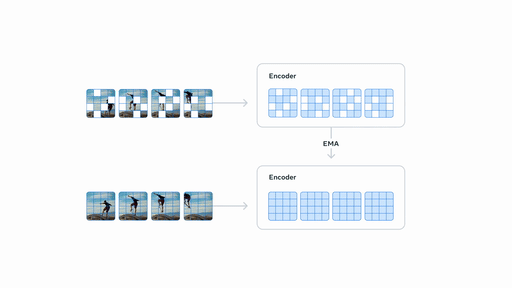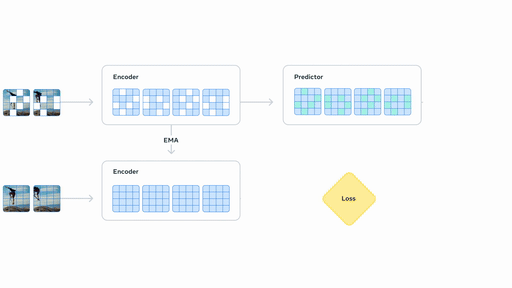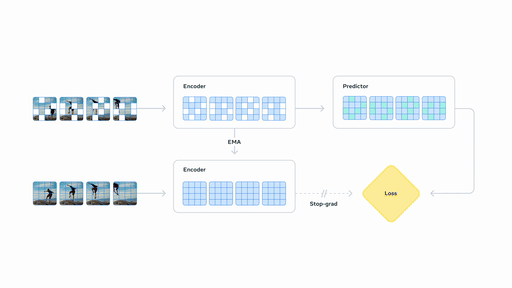
Bạn có thể tìm thấy tất cả các checkpoint gốc của V-JEPA2 trong bộ sưu tập V-JEPA 2.
Mô hình này được đóng góp bởi koustuvs, yonigozlan và qubvel. Mã gốc có thể được tìm thấy tại đây.
Ví dụ sử dụng
Đoạn mã dưới đây cho thấy cách tải mô hình V-JEPA 2 để trích xuất đặc trưng bằng lớp AutoModel.
import numpy as np
from torchcodec.decoders import VideoDecoder


processor = AutoVideoProcessor.from_pretrained("facebook/vjepa2-vitl-fpc64-256")
model = AutoModel.from_pretrained(
    "facebook/vjepa2-vitl-fpc64-256",
    device_map="auto",
    attn_implementation="sdpa"
)

video_url = "https://huggingface.co/datasets/nateraw/kinetics-mini/resolve/main/val/archery/-Qz25rXdMjE_000014_000024.mp4"

vr = VideoDecoder(video_url)
frame_idx = np.arange(0, 64) # choosing some frames. here, you can define more complex sampling strategy
video = vr.get_frames_at(indices=frame_idx).data  # T x C x H x W
video = processor(video, return_tensors="pt").to(model.device)
outputs = model(**video)

# V-JEPA 2 encoder outputs, same as calling `model.get_vision_features()`
encoder_outputs = outputs.last_hidden_state

# V-JEPA 2 predictor outputs
predictor_outputs = outputs.predictor_output.last_hidden_state
V-JEPA 2 cũng có thể được tinh chỉnh cho phân loại video. Trong đoạn mã sau, chúng tôi cho thấy cách sử dụng mô hình phân loại video Something-Something-V2 đã được tinh chỉnh.
import numpy as np
import torch
from torchcodec.decoders import VideoDecoder

from transformers import AutoModelForVideoClassification, AutoVideoProcessor


# Load model and video preprocessor
hf_repo = "facebook/vjepa2-vitl-fpc16-256-ssv2"

model = AutoModelForVideoClassification.from_pretrained(hf_repo, device_map="auto")
processor = AutoVideoProcessor.from_pretrained(hf_repo)

# To load a video, sample the number of frames according to the model.
video_url = "https://huggingface.co/datasets/nateraw/kinetics-mini/resolve/main/val/bowling/-WH-lxmGJVY_000005_000015.mp4"
vr = VideoDecoder(video_url)
frame_idx = np.arange(0, model.config.frames_per_clip, 8) # you can define more complex sampling strategy
video = vr.get_frames_at(indices=frame_idx).data  # frames x channels x height x width

# Preprocess and run inference
inputs = processor(video, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)
logits = outputs.logits

print("Top 5 predicted class names:")
top5_indices = logits.topk(5).indices[0]
top5_probs = torch.softmax(logits, dim=-1).topk(5).values[0]
for idx, prob in zip(top5_indices, top5_probs):
    text_label = model.config.id2label[idx.item()]
    print(f" - {text_label}: {prob:.2f}")
VJEPA2Config
lớp transformers.VJEPA2Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonepatch_size: int | list[int] | tuple[int, int] = 16crop_size: int = 256frames_per_clip: int = 64tubelet_size: int = 2hidden_size: int = 1024in_chans: int = 3num_attention_heads: int = 16num_hidden_layers: int = 24drop_path_rate: float | int = 0.0mlp_ratio: int | float = 4.0layer_norm_eps: float = 1e-06qkv_bias: bool = Trueattention_probs_dropout_prob: float | int = 0.0hidden_act: str = 'gelu'initializer_range: float = 0.02attention_dropout: float | int = 0.0num_pooler_layers: int = 3pred_hidden_size: int = 384pred_num_attention_heads: int = 12pred_num_hidden_layers: int = 12pred_num_mask_tokens: int = 10pred_zero_init_mask_tokens: bool = Truepred_mlp_ratio: int | float = 4.0 )
Tham số
- patch_size (
Union[int, list[int], tuple[int, int]], tùy chọn, mặc định là16) — Kích thước (độ phân giải) của mỗi patch. - crop_size (
int, tùy chọn, mặc định là 256) — Độ phân giải đầu vào của mô hình - frames_per_clip (
int, tùy chọn, mặc định là 64) — Số lượng khung hình mà mô hình đã được tiền huấn luyện. Không ảnh hưởng đến suy luận. - tubelet_size (
int, tùy chọn, mặc định là 2) — Số lượng khung thời gian được sử dụng cho một rastor đơn lẻ, xem bài báo để biết thêm thông tin. - hidden_size (
int, tùy chọn, mặc định là1024) — Kích thước của các biểu diễn ẩn. - in_chans (
int, tùy chọn, mặc định là3) — Số lượng kênh đầu vào. - num_attention_heads (
int, tùy chọn, mặc định là16) — Số lượng đầu attention cho mỗi lớp attention trong bộ giải mã Transformer. - num_hidden_layers (
int, tùy chọn, mặc định là24) — Số lượng lớp ẩn trong bộ giải mã Transformer. - drop_path_rate (
Union[float, int], tùy chọn, mặc định là0.0) — Tỷ lệ drop path cho việc hợp nhất patch. - mlp_ratio (
Union[int, float], tùy chọn, mặc định là4.0) — Tỷ lệ giữa chiều ẩn của MLP và chiều nhúng. - layer_norm_eps (
float, tùy chọn, mặc định là1e-06) — Giá trị epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization). - qkv_bias (
bool, tùy chọn, mặc định làTrue) — Có thêm bias cho queries, keys và values hay không. - attention_probs_dropout_prob (
Union[float, int], tùy chọn, mặc định là0.0) — Tỷ lệ dropout cho các xác suất chú ý. - hidden_act (
str, tùy chọn, mặc định làgelu) — Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ,"gelu","relu","silu", v.v. - initializer_range (
float, tùy chọn, mặc định là0.02) — Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số. - attention_dropout (
Union[float, int], tùy chọn, mặc định là0.0) — Tỷ lệ dropout cho các xác suất chú ý. - num_pooler_layers (
int, tùy chọn, mặc định là 3) — Số lượng lớp self-attention trong pooler. - pred_hidden_size (
int, tùy chọn, mặc định là 384) — Kích thước chiều của các lớp dự đoán - pred_num_attention_heads (
int, tùy chọn, mặc định là 12) — Số lượng đầu chú ý cho mỗi lớp chú ý trong Predictor - pred_num_hidden_layers (
int, tùy chọn, mặc định là 12) — Số lượng lớp ẩn trong Predictor - pred_num_mask_tokens (
int, tùy chọn, mặc định là 10) — Xác định số lượng token mask được sử dụng trong Predictor - pred_zero_init_mask_tokens (
bool, tùy chọn, mặc định làTrue) — Khởi tạo các token mask trong predictor bằng 0. - pred_mlp_ratio (
float, tùy chọn, mặc định là 4.0) — Tỷ lệ kích thước ẩn của các MLP được sử dụng trong Predictor so vớipred_hidden_size.
Đây là lớp cấu hình để lưu trữ cấu hình của một VJEPA2Model. Nó được sử dụng để khởi tạo một mô hình Vjepa2 theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của facebook/vjepa2-vitl-fpc64-256
Các đối tượng cấu hình kế thừa từ PreTrainedConfig và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ PreTrainedConfig để biết thêm thông tin.
Ví dụ:
>>> from transformers import VJEPA2Config, VJEPA2Model

>>> # Initializing a VJEPA2 vjepa2-vitl-fpc64-256 style configuration
>>> configuration = VJEPA2Config()

>>> # Initializing a model (with random weights) from the vjepa2-vitl-fpc64-256  style configuration
>>> model = VJEPA2Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
VJEPA2Model
lớp transformers.VJEPA2Model
< source >( config: VJEPA2Config )
Tham số
- config (VJEPA2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số mô hình.
Mô hình Vjepa2 cơ bản, xuất ra các hidden-states thô mà không có head cụ thể nào ở phía trên.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( pixel_values_videos: Tensorcontext_mask: list[torch.Tensor] | None = Nonetarget_mask: list[torch.Tensor] | None = Noneskip_predictor: bool = False**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → VJEPA2WithMaskedInputModelOutput or tuple(torch.Tensor)
Tham số
- pixel_values_videos (
torch.Tensorcó hình dạng(batch_size, num_frames, num_channels, frame_size, frame_size)) — Các tensor tương ứng với video đầu vào. Giá trị pixel cho video có thể được lấy bằng cách sử dụng VJEPA2VideoProcessor. Xem VJEPA2VideoProcessor.call() để biết chi tiết (processor_classsử dụng VJEPA2VideoProcessor để xử lý video). - context_mask (
torch.Tensorvới shape[batch_size, patch_size, 1], tuỳ chọn) — Các vị trí id của mask chỉ định những patch đầu ra của encoder nào sẽ được đưa cho predictor. Mặc định, mask này được tạo bằng torch.arange(N).unsqueeze(0).repeat(B,1), cho thấy toàn bộ ngữ cảnh có sẵn cho predictor. - target_mask (
torch.Tensorvới shape[batch_size, patch_size, 1], tuỳ chọn) — Các vị trí id của mask chỉ định những patch đầu ra của encoder sẽ được sử dụng làm mục tiêu dự đoán cho predictor. Mặc định, mask này được tạo bằng torch.arange(N).unsqueeze(0).repeat(B,1), cho thấy predictor nên dự đoán tất cả các patch của encoder. - skip_predictor (
bool, tuỳ chọn, mặc định làFalse) — cờ để bỏ qua bước forward của predictor, hữu ích nếu bạn chỉ cần đầu ra của encoder
Trả về
VJEPA2WithMaskedInputModelOutput hoặc tuple(torch.Tensor)
Một VJEPA2WithMaskedInputModelOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (VJEPA2Config) và đầu vào.
Phương thức forward của VJEPA2Model ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
last_hidden_state (
torch.Tensorcó hình dạng(batch_size, sequence_length, hidden_size)) — Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.masked_hidden_state (
torch.Tensorcó hình dạng(batch_size, sequence_length, hidden_size), tùy chọn, được trả về khicontext_maskđược cung cấp, áp dụng lên đầu ra của VJEPA2Encoder) — Trạng thái ẩn đã được che (masked) của mô hình.hidden_states (
tuple[torch.Tensor, ...], tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
attentions (
tuple[torch.Tensor, ...], tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
predictor_output (
VJEPA2WithMaskedInputPredictorOutput, tùy chọn) — Đầu ra từ module Predictor.
VJEPA2ForVideoClassification
lớp transformers.VJEPA2ForVideoClassification
< source >( config: VJEPA2Config )
Tham số
- config (VJEPA2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số mô hình.
Mô hình transformer V-JEPA 2 với đầu phân loại video phía trên (một lớp tuyến tính phía trên bộ pooler chú ý).
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( pixel_values_videos: Tensorlabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → ImageClassifierOutput or tuple(torch.Tensor)
Tham số
- pixel_values_videos (
torch.Tensorcó hình dạng(batch_size, num_frames, num_channels, frame_size, frame_size)) — Các tensor tương ứng với video đầu vào. Giá trị pixel cho video có thể được lấy bằng cách sử dụng VJEPA2VideoProcessor. Xem VJEPA2VideoProcessor.call() để biết chi tiết (processor_classsử dụng VJEPA2VideoProcessor để xử lý video). - labels (
torch.LongTensorcó shape(batch_size,), tùy chọn) — Nhãn để tính loss phân loại/hồi quy ảnh. Các chỉ số phải nằm trong[0, ..., config.num_labels - 1]. Nếuconfig.num_labels == 1, loss hồi quy sẽ được tính (Mean-Square loss). Nếuconfig.num_labels > 1, loss phân loại sẽ được tính (Cross-Entropy).
Trả về
ImageClassifierOutput hoặc tuple(torch.Tensor)
Một ImageClassifierOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (VJEPA2Config) và đầu vào.
Phương thức forward của VJEPA2ForVideoClassification ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
torch.Tensorcó shape(1,), optional, được trả về khilabelsđược cung cấp) — Loss phân loại (hoặc hồi quy nếu config.num_labels==1).logits (
torch.Tensorcó hình dạng(batch_size, config.num_labels)) — Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).hidden_states (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi giai đoạn) có hình dạng(batch_size, sequence_length, hidden_size). Hidden-states (còn được gọi là feature maps) của mô hình tại đầu ra của mỗi giai đoạn.attentions (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, patch_size, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
>>> import torch
>>> import numpy as np
>>> from transformers import AutoVideoProcessor, VJEPA2ForVideoClassification

>>> device = "cuda"

>>> video_processor = AutoVideoProcessor.from_pretrained("facebook/vjepa2-vitl-fpc16-256-ssv2")
>>> model = VJEPA2ForVideoClassification.from_pretrained("facebook/vjepa2-vitl-fpc16-256-ssv2").to(device)

>>> video = np.ones((64, 256, 256, 3))  # 64 frames, 256x256 RGB
>>> inputs = video_processor(video, return_tensors="pt").to(device)

>>> # For inference
>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> logits = outputs.logits

>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])

>>> # For training
>>> labels = torch.ones(1, dtype=torch.long, device=device)
>>> loss = model(**inputs, labels=labels).loss
VJEPA2VideoProcessor
lớp transformers.VJEPA2VideoProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.VideosKwargs'> )
Tham số
- do_convert_rgb (
bool, kwargs, optional) — Có nên chuyển đổi ảnh sang RGB hay không. - do_resize (
bool, kwargs, tuỳ chọn, mặc định làTrue) — Có nên thay đổi kích thước ảnh hay không. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, mặc định là{'shortest_edge' -- 292}): Mô tả kích thước đầu vào tối đa cho mô hình. - default_to_square (
bool, kwargs, tùy chọn, mặc định làTrue) — Có nên mặc định dùng ảnh vuông khi thay đổi kích thước không, nếu size là một số nguyên. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, mặc định là2) — Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) củaPILImageResampling. Chỉ có hiệu lực khido_resizeđược đặt thànhTrue. - do_rescale (
bool, kwargs, tuỳ chọn, mặc định làTrue) — Có nên điều chỉnh lại tỷ lệ ảnh hay không. - rescale_factor (
float, kwargs, optional, mặc định là0.00392156862745098) — Hệ số rescale để rescale ảnh nếudo_rescaleđược đặt thànhTrue. - do_normalize (
bool, kwargs, tuỳ chọn, mặc định làTrue) — Có nên chuẩn hóa hình ảnh hay không. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, mặc định là[0.485, 0.456, 0.406]) — Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếudo_normalizeđược đặt thànhTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, mặc định là[0.229, 0.224, 0.225]) — Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếudo_normalizeđược đặt thànhTrue. - do_center_crop (
bool, kwargs, tuỳ chọn, mặc định làTrue) — Có nên cắt ảnh ở vị trí trung tâm hay không. - do_pad (
bool, kwargs, optional) — Có nên chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, mặc định là256) — Kích thước của ảnh đầu ra sau khi áp dụngcenter_crop. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Chỉ hỗ trợChannelDimension.FIRST. Được thêm vào để tương thích với các bộ xử lý chậm. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, tùy chọn) — Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị:"channels_first"hoặcChannelDimension.FIRST: ảnh ở định dạng (num_channels, height, width)."channels_last"hoặcChannelDimension.LAST: ảnh ở định dạng (height, width, num_channels)."none"hoặcChannelDimension.NONE: ảnh ở định dạng (chiều cao, chiều rộng).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào. - do_sample_frames (
bool, kwargs, tuỳ chọn) — Có lấy mẫu các khung hình từ video trước khi xử lý hay xử lý toàn bộ video hay không. - video_metadata (
Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None], kwargs) — Metadata của video, chứa thông tin về tổng thời lượng, fps và tổng số khung hình. Nó sẽ được sử dụng để lấy mẫu các khung hình từ video hoặc tính toán mốc thời gian. Không truyền bất kỳ metadata nào trừ khi bạn đang cố gắng giải mã video thủ công trước khi xử lý - fps (
Annotated[int | float | None, None], kwargs) — Số khung hình mục tiêu cần lấy mẫu mỗi giây khido_sample_frames=True. - num_frames (
Annotated[int | None, None], kwargs) — Số khung hình tối đa cần lấy mẫu khido_sample_frames=True. - return_metadata (
bool, kwargs, tuỳ chọn, mặc định làFalse) — Có trả về metadata của video hay không. Video metadata là một đối tượng chứa thông tin về thời lượng video, fps, backend giải mã, v.v. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Nếu được đặt, sẽ trả về tensor của một framework cụ thể. Các giá trị chấp nhận được là:'pt': Trả về các đối tượngtorch.Tensorcủa PyTorch.'np': Trả về các đối tượngnp.ndarraycủa NumPy.
- **kwargs (VideosKwargs, optional) — Các tùy chọn xử lý bổ sung cho từng phương thức (text, hình ảnh, video, âm thanh). Các tham số cụ thể của model được liệt kê ở trên; xem lớp TypedDict để biết danh sách đầy đủ các đối số được hỗ trợ.
Tạo một bộ xử lý video VJEPA2VideoProcessor.