
Transformers documentation
Контрольные точки градиентов
Контрольные точки градиентов
Прямой проход обычно кэширует все промежуточные активации для повторного использования в обратном проходе. Однако объём активаций масштабируется с размером батча и длиной последовательности. Градиентный чекпоинтинг сохраняет только определённые активации и отбрасывает остальные. Это заставляет обратный проход пересчитывать часть активаций на лету по мере необходимости.
Normal training:
  Forward:   [L1]→[L2]→[L3]→[L4]   (save ALL activations)
  Backward:  ←uses cached activations everywhere

Gradient checkpointing:
  Forward:   [L1]→[L2]→[L3]→[L4]   (save only at checkpoints, discard the rest)
  Backward:  ←reaches L2, recomputes L2→L3 from scratch, uses it, discards it
Обучение обычно идёт медленнее, так как обратный проход пересчитывает отброшенные активации, но чекпоинтинг снижает потребление памяти на активации.
Установите gradient_checkpointing=True, чтобы включить.
Используйте вместе с накоплением градиентов, чтобы дополнительно снизить потребление памяти.
from transformers import TrainingArguments

args = TrainingArguments(
    ...,
    gradient_checkpointing=True,
)
Частичное сохранение контрольных точек
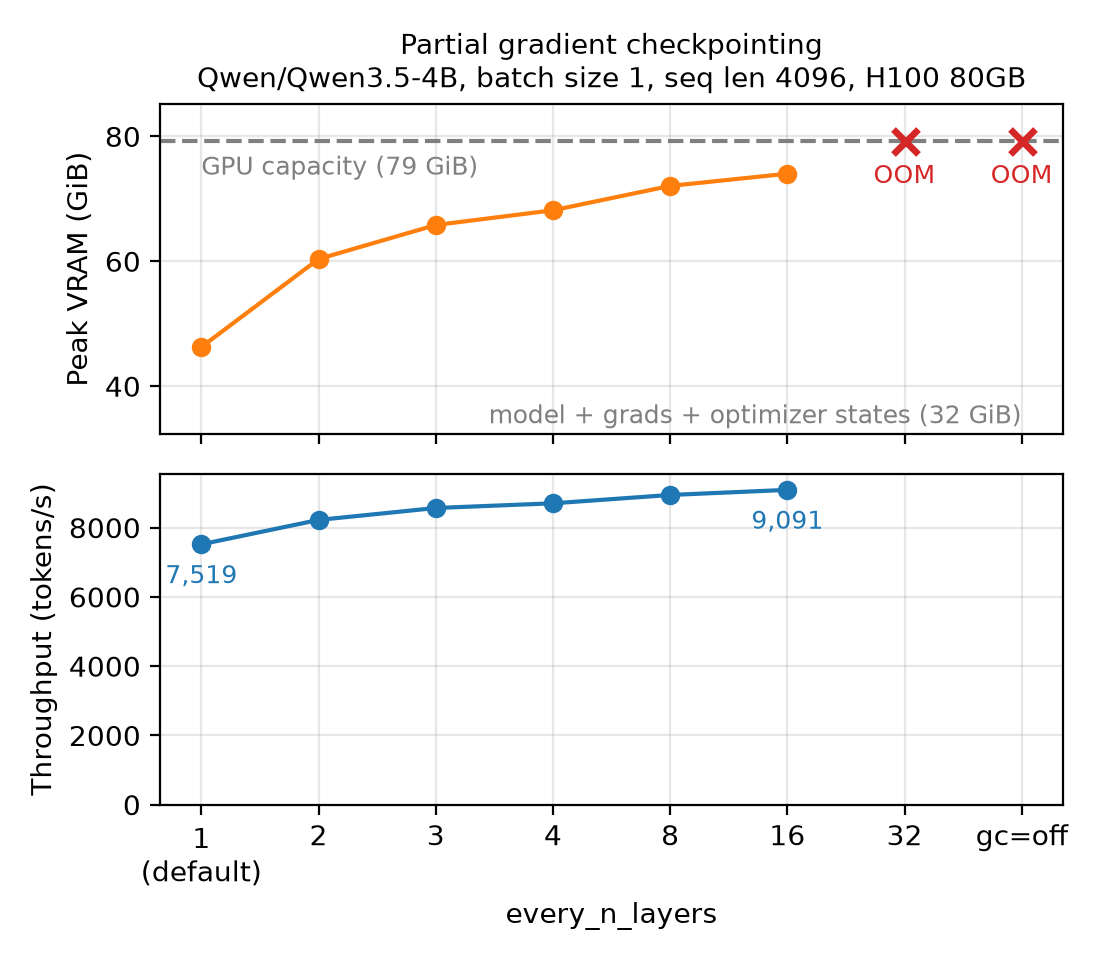
Полное сохранение контрольных точек градиентов (full gradient checkpointing) пересчитывает каждый слой, для которого это возможно. Если в вашем запуске есть запас по памяти, сохраняйте контрольные точки для меньшего числа слоёв, чтобы обменять часть экономии памяти на скорость.
Передайте every_n_layers в gradient_checkpointing_enable(), чтобы задать интервал контрольных точек.
every_n_layers=2

Forward:   input  -> [L1] -> [L2] -> [L3] -> [L4] -> [L5] -> [L6]
                      CP     keep     CP     keep     CP     keep

Backward:  output <- [L6] <- [L5] <- [L4] <- [L3] <- [L2] <- [L1]
                     keep   rerun    keep   rerun    keep   rerun
При every_n_layers=2 чекпоинтируются первый слой и каждый второй слой после него. Слои с чекпоинтами отбрасывают свои активации во время прямого прохода и пересчитывают их во время обратного прохода, тогда как остальные слои сохраняют свои активации в памяти.
model.gradient_checkpointing_enable(every_n_layers=2)По умолчанию, every_n_layers=1, контрольные точки создаются для каждого слоя. Большие значения создают контрольную точку для первого слоя, а затем для каждого n-го слоя после него, оставляя активации остальных слоев в памяти. Например, every_n_layers=2 создает контрольные точки для слоев 1, 3, 5 и так далее. Учитываются только модули, наследующиеся от GradientCheckpointingLayer. Другие модули, поддерживающие градиентный чекпоинтинг, остаются активными.
Чтобы использовать частичное контрольное точечное сохранение градиентов с Trainer, задайте every_n_layers в gradient_checkpointing_kwargs.
from transformers import TrainingArguments

args = TrainingArguments(
    ...,
    gradient_checkpointing=True,
    gradient_checkpointing_kwargs={"every_n_layers": 4},
)
Перенос сохраненных активаций
Gradient checkpointing сохраняет одно активное значение на каждый слой с checkpointing на GPU. При длинных последовательностях это может потребовать значительного объёма памяти (примерно layers x sequence x hidden x bytes_per_element). Установите offload, чтобы хранить эти активные значения в закреплённой памяти хоста, что приведёт к копированию с устройства на хост во время прямого прохода и с хоста на устройство во время обратного прохода.
from transformers import TrainingArguments

args = TrainingArguments(
    ...,
    gradient_checkpointing=True,
    gradient_checkpointing_kwargs={"offload": True},
)
Обе копии выполняются на вычислительном потоке, поэтому этот подход жертвует скоростью шага ради памяти. Используйте его, когда запуск иначе не помещается в память, а не для ускорения.
Дальнейшие шаги
- Ознакомьтесь с документацией Использование памяти GPU, чтобы понять, что влияет на потребление памяти на GPU во время обучения.
- См. руководство Обучение с смешанной точностью, чтобы узнать, как использовать типы данных с меньшей точностью для дальнейшего сокращения потребления памяти и ускорения обучения.
- См. руководство Kernels, чтобы узнать, как ускорить обучение с помощью пользовательских слиянных ядер.