
Transformers documentation
InternVL
Ce modèle a été publié dans HF papers le 2025-04-14 et contribué à Hugging Face Transformers le 2025-04-18.


InternVL
La famille de modèles de langage visuel InternVL3 a été présentée dans InternVL3: Exploring Advanced Training and Test-Time Recipes for Open-Source Multimodal Models.
L'abstract de l'article est le suivant :
Nous présentons InternVL3, une avancée majeure de la série InternVL qui adopte un paradigme de pré-entraînement multimodal natif. Plutôt que d’adapter un grand modèle de langage (LLM) textuel en un grand modèle de langage multimodal (MLLM) capable de traiter des entrées visuelles, InternVL3 acquiert conjointement des capacités multimodales et linguistiques à partir de données multimodales variées et de corpus de texte pur, au cours d’une seule phase de pré-entraînement. Ce paradigme d’entraînement unifié traite efficacement les complexités et les défis d’alignement couramment rencontrés dans les pipelines d’entraînement a posteriori conventionnels pour les MLLM. Pour améliorer davantage les performances et la scalabilité, InternVL3 intègre un encodage de position visuelle variable (V2PE) afin de prendre en charge des contextes multimodaux étendus, met en œuvre des techniques avancées de post-entraînement telles que l’ajustement fin supervisé (SFT) et l’optimisation de préférences mixtes (MPO), et adopte des stratégies de mise à l’échelle au moment du test ainsi qu’une infrastructure d’entraînement optimisée. Des évaluations empiriques approfondies démontrent qu’InternVL3 offre des performances supérieures sur une large gamme de tâches multimodales. En particulier, InternVL3-78B obtient un score de 72,2 sur le benchmark MMMU, établissant un nouvel état de l’art parmi les MLLM open source. Ses capacités restent très compétitives face aux modèles propriétaires de pointe, notamment ChatGPT-4o, Claude 3.5 Sonnet et Gemini 2.5 Pro, tout en maintenant une forte maîtrise du langage pur. Dans l’esprit des principes de la science ouverte, nous publierons à la fois les données d’entraînement et les poids du modèle afin de favoriser la recherche et le développement de MLLM de nouvelle génération.
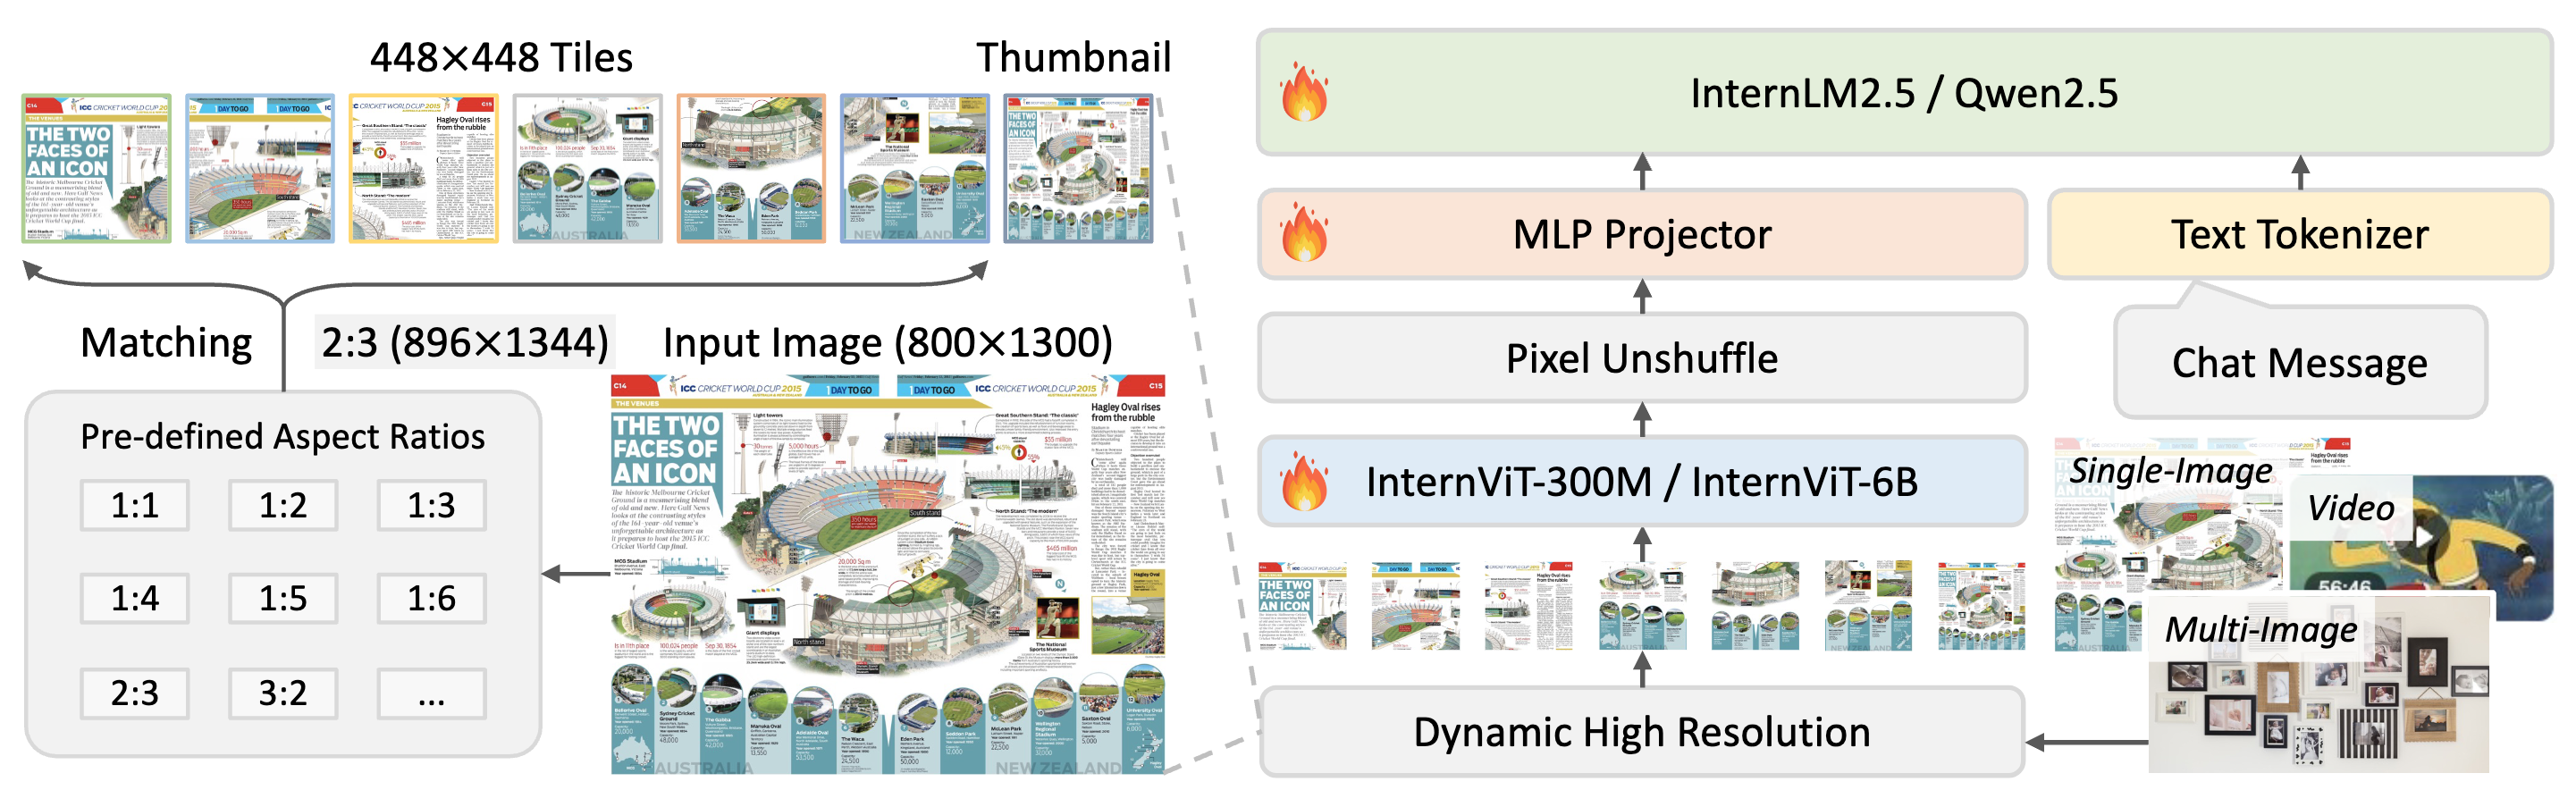 Overview of InternVL3 models architecture, which is the same as InternVL2.5. Taken from the original checkpoint.
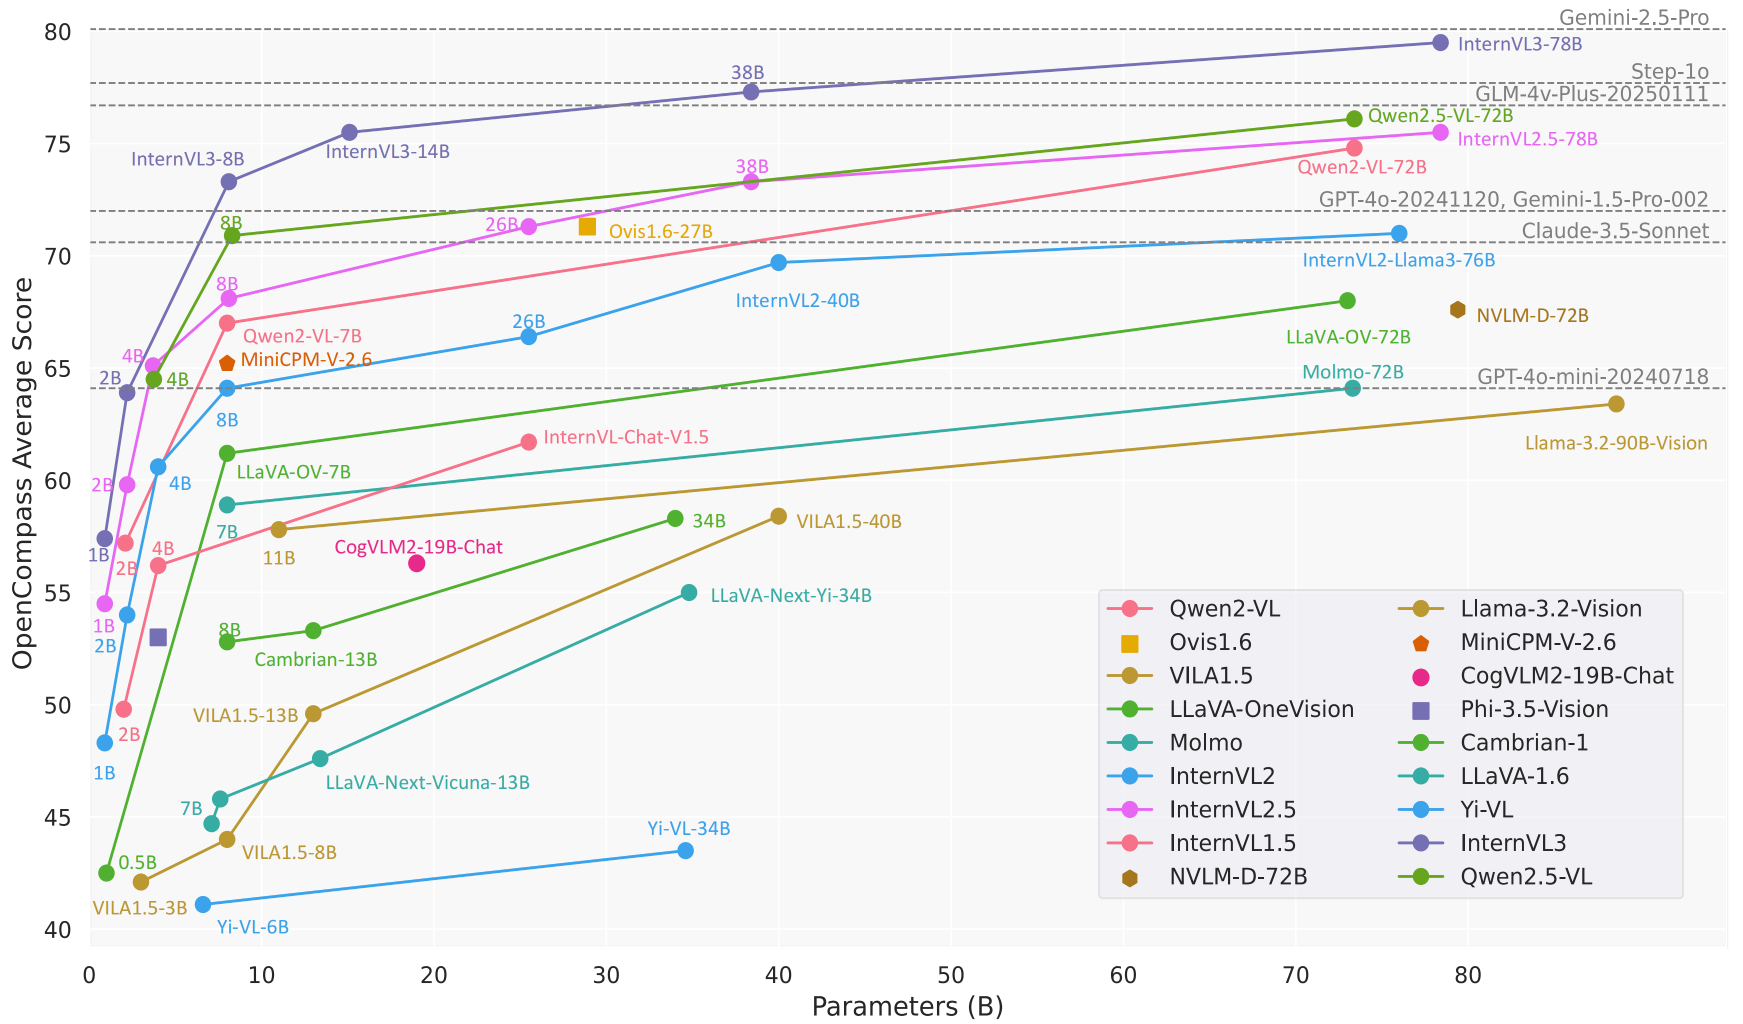 Comparison of InternVL3 performance on OpenCompass against other SOTA VLLMs. Taken from the original checkpoint.
Ce modèle a été contribué par yonigozlan. Le code d'origine peut être trouvé ici.
Définissez
use_kernels=Truedans from_pretrained() pour remplacer les couches prises en charge par des noyaux optimisés du Hub. Consultez Chargement des noyaux pour en savoir plus.
Exemple d'utilisation
Inférence avec Pipeline
Voici comment utiliser le pipeline image-text-to-text pour effectuer de l'inférence avec les modèles InternVL3 en quelques lignes de code :
from transformers import pipeline


messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg",
            },
            {"type": "text", "text": "Describe this image."},
        ],
    },
]

pipe = pipeline("image-text-to-text", model="OpenGVLab/InternVL3-1B-hf")
outputs = pipe(text=messages, max_new_tokens=50, return_full_text=False)
outputs[0]["generated_text"]
'The image showcases a vibrant scene of nature, featuring several flowers and a bee. \n\n1. **Foreground Flowers**: \n   - The primary focus is on a large, pink cosmos flower with a prominent yellow center. The petals are soft and slightly r'
Inférence sur une image unique
Cet exemple montre comment effectuer une inférence sur une image unique avec les modèles InternVL en utilisant des modèles de discussion.
Notez que le modèle a été entraîné avec un format de prompt spécifique pour le chat. Utilisez
processor.apply_chat_template(my_conversation_dict)pour formater correctement vos prompts.
from transformers import AutoModelForImageTextToText, AutoProcessor


model_checkpoint = "OpenGVLab/InternVL3-1B-hf"
processor = AutoProcessor.from_pretrained(model_checkpoint)
model = AutoModelForImageTextToText.from_pretrained(model_checkpoint, device_map="auto")

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "http://images.cocodataset.org/val2017/000000039769.jpg"},
            {"type": "text", "text": "Please describe the image explicitly."},
        ],
    }
]

inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(model.device)

generate_ids = model.generate(**inputs, max_new_tokens=50)
decoded_output = processor.decode(generate_ids[0, inputs["input_ids"].shape[1] :], skip_special_tokens=True)

decoded_output
'The image shows two cats lying on a pink blanket. The cat on the left is a tabby with a mix of brown, black, and white fur, and it appears to be sleeping with its head resting on the blanket. The cat on the'
Génération de texte uniquement
Cet exemple montre comment générer du texte à l'aide du modèle InternVL sans fournir d'image en entrée.
from transformers import AutoModelForImageTextToText, AutoProcessor


model_checkpoint = "OpenGVLab/InternVL3-1B-hf"
processor = AutoProcessor.from_pretrained(model_checkpoint)
model = AutoModelForImageTextToText.from_pretrained(model_checkpoint, device_map="auto")

messages = [
    {
        "role": "user",
        "content": [
            {"type": "text", "text": "Write a haiku"},
        ],
    }
]

inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(model.device)

generate_ids = model.generate(**inputs, max_new_tokens=50)
decoded_output = processor.decode(generate_ids[0, inputs["input_ids"].shape[1] :], skip_special_tokens=True)

print(decoded_output)
"Whispers of dawn,\nSilent whispers of the night,\nNew day's light begins."
Entrées d'images et de texte par lots
Les modèles InternVL prennent également en charge les entrées d'images et de texte par lots.
from transformers import AutoModelForImageTextToText, AutoProcessor


model_checkpoint = "OpenGVLab/InternVL3-1B-hf"
processor = AutoProcessor.from_pretrained(model_checkpoint)
model = AutoModelForImageTextToText.from_pretrained(model_checkpoint, device_map="auto")

messages = [
    [
        {
            "role": "user",
            "content": [
                {"type": "image", "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/llava_view.jpg"},
                {"type": "text", "text": "Write a haiku for this image"},
            ],
        },
    ],
    [
        {
            "role": "user",
            "content": [
                {"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
                {"type": "text", "text": "Describe this image"},
            ],
        },
    ],
]


inputs = processor.apply_chat_template(messages, padding=True, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(model.device)

output = model.generate(**inputs, max_new_tokens=25)

decoded_outputs = processor.batch_decode(output, skip_special_tokens=True)
decoded_outputs
["user\n\nWrite a haiku for this image\nassistant\nSilky lake,  \nWooden pier,  \nNature's peace.",
 'user\n\nDescribe this image\nassistant\nThe image shows a street scene with a traditional Chinese archway, known as a "Chinese Gate" or "Chinese Gate of']
Entrée multi-images par lots
Cette implémentation des modèles InternVL prend en charge des entrées texte-images par lots avec un nombre d'images différent pour chaque texte.
from transformers import AutoProcessor, AutoModelForImageTextToText
import torch

model_checkpoint = "OpenGVLab/InternVL3-1B-hf"
processor = AutoProcessor.from_pretrained(model_checkpoint)
model = AutoModelForImageTextToText.from_pretrained(model_checkpoint, device_map="auto")

messages = [
    [
        {
            "role": "user",
            "content": [
                {"type": "image", "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/llava_view.jpg"},
                {"type": "text", "text": "Write a haiku for this image"},
            ],
        },
    ],
    [
        {
            "role": "user",
            "content": [
                {"type": "image", "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/statue_of_liberty.jpg"},
                {"type": "image", "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/dreamstime_golden_gate_flowers.jpg"},
                {"type": "text", "text": "These images depict two different landmarks. Can you identify them?"},
            ],
        },
    ],
]

inputs = processor.apply_chat_template(messages, padding=True, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(model.device)

output = model.generate(**inputs, max_new_tokens=25)

decoded_outputs = processor.batch_decode(output, skip_special_tokens=True)
decoded_outputs
["user\n\nWrite a haiku for this image\nassistant\nSilky lake,  \nWooden pier,  \nNature's peace.",
 'user\n\n\nThese images depict two different landmarks. Can you identify them?\nassistant\nYes, these images depict the Statue of Liberty and the Golden Gate Bridge.']
Entrée vidéo
Les modèles InternVL peuvent également traiter des entrées vidéo. Voici un exemple de la façon d'effectuer une inférence sur une entrée vidéo à l'aide de modèles de discussion.
from transformers import AutoModelForImageTextToText, AutoProcessor, BitsAndBytesConfig


model_checkpoint = "OpenGVLab/InternVL3-8B-hf"
quantization_config = BitsAndBytesConfig(load_in_4bit=True)
processor = AutoProcessor.from_pretrained(model_checkpoint)
model = AutoModelForImageTextToText.from_pretrained(model_checkpoint, quantization_config=quantization_config, device_map="auto")

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "video",
                "url": "https://huggingface.co/datasets/hf-internal-testing/fixtures_videos/resolve/main/tennis.mp4",
            },
            {"type": "text", "text": "What type of shot is the man performing?"},
        ],
    }
]
inputs = processor.apply_chat_template(
    messages,
    return_tensors="pt",
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    num_frames=8,
).to(model.device)

output = model.generate(**inputs, max_new_tokens=25)

decoded_output = processor.decode(output[0, inputs["input_ids"].shape[1] :], skip_special_tokens=True)
decoded_output
'The man is performing a forehand shot.'
Entrées d'images et de vidéos entrelacées
Cet exemple montre comment traiter un lot de conversations de chat avec des entrées d'images et de vidéos entremêlées à l'aide d'un modèle de chat.
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig
import torch

model_checkpoint = "OpenGVLab/InternVL3-1B-hf"
processor = AutoProcessor.from_pretrained(model_checkpoint)
model = AutoModelForImageTextToText.from_pretrained(model_checkpoint, device_map="auto")

messages = [
    [
        {
            "role": "user",
            "content": [
                {"type": "image", "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/statue_of_liberty.jpg"},
                {"type": "image", "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/dreamstime_golden_gate_flowers.jpg"},
                {"type": "text", "text": "These images depict two different landmarks. Can you identify them?"},
            ],
        },
    ],
    [
        {
            "role": "user",
            "content": [
                {"type": "video", "url": "https://huggingface.co/datasets/hf-internal-testing/fixtures_videos/resolve/main/tennis.mp4"},
                {"type": "text", "text": "What type of shot is the man performing?"},
            ],
        },
    ],
    [
        {
            "role": "user",
            "content": [
                {"type": "image", "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/llava_view.jpg"},
                {"type": "text", "text": "Write a haiku for this image"},
            ],
        },
    ],
]
inputs = processor.apply_chat_template(
    messages,
    padding=True,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

outputs = model.generate(**inputs, max_new_tokens=25)

decoded_outputs = processor.batch_decode(outputs, skip_special_tokens=True)
decoded_outputs
['user\n\n\nThese images depict two different landmarks. Can you identify them?\nassistant\nThe images depict the Statue of Liberty and the Golden Gate Bridge.',
 'user\nFrame1: \nFrame2: \nFrame3: \nFrame4: \nFrame5: \nFrame6: \nFrame7: \nFrame8: \nWhat type of shot is the man performing?\nassistant\nA forehand shot',
 "user\n\nWrite a haiku for this image\nassistant\nSilky lake,  \nWooden pier,  \nNature's peace."]
InternVLVisionConfig
classe transformers.InternVLVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 1024num_hidden_layers: int = 24num_attention_heads: int = 16attention_bias: bool = Falseuse_qk_norm: bool = Falseintermediate_size: int = 4096hidden_act: str = 'gelu'hidden_dropout_prob: float | int = 0.0attention_dropout: float | int = 0.0projection_dropout: float | int = 0.0initializer_range: float = 0.02norm_type: str = 'layer_norm'layer_norm_eps: float = 1e-06image_size: int | list[int] | tuple[int, ...] = (448, 448)patch_size: int | list[int] | tuple[int, ...] = (14, 14)num_channels: int = 3use_mask_token: bool = Falseuse_absolute_position_embeddings: bool = Truelayer_scale_init_value: float = 0.1use_mean_pooling: bool = True )
Paramètres
- hidden_size (
int, facultatif, par défaut1024) — Dimension des représentations cachées. - num_hidden_layers (
int, facultatif, par défaut24) — Nombre de couches cachées dans le décodeur Transformer. - num_attention_heads (
int, facultatif, valeur par défaut16) — Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer. - attention_bias (
bool, facultatif, par défautFalse) — Indique s'il faut utiliser un biais dans les couches de projection des requêtes, des clés, des valeurs et de la sortie lors de l'auto-attention. - use_qk_norm (
bool, facultatif, valeur par défautFalse) — Indique s'il faut utiliser la normalisation des requêtes et des clés dans l'attention. - intermediate_size (
int, facultatif, par défaut4096) — Dimension des représentations du MLP. - hidden_act (
str, facultatif, par défautgelu) — La fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple,"gelu","relu","silu", etc. - hidden_dropout_prob (
Union[float, int], facultatif, par défaut0.0) — La probabilité de dropout pour toutes les couches entièrement connectées des embeddings, de l'encodeur et du pooler. - attention_dropout (
Union[float, int], facultatif, valeur par défaut0.0) — Le taux de dropout appliqué aux probabilités d'attention. - projection_dropout (
float, facultatif, valeur par défaut 0.0) — Probabilité de dropout pour la couche de projection. - initializer_range (
float, facultatif, par défaut0.02) — L'écart-type de la truncated_normal_initializer utilisé pour initialiser toutes les matrices de poids. - norm_type (
str, facultatif, par défaut"layer_norm") — Le type de normalisation à utiliser dans l'encodeur. Peut être"layer_norm"ou"rms_norm". - layer_norm_eps (
float, facultatif, valeur par défaut1e-06) — L'épsilon utilisé par les couches de normalisation de couche. - image_size (
Union[int, list[int], tuple[int, ...]], facultatif, par défaut(448, 448)) — La taille (résolution) de chaque image. - patch_size (
Union[int, list[int], tuple[int, ...]], facultatif, par défaut(14, 14)) — La taille (résolution) de chaque patch. - num_channels (
int, facultatif, par défaut3) — Le nombre de canaux d'entrée. - use_mask_token (
bool, facultatif, par défautFalse) — Indique s'il faut utiliser un jeton de masque pour le modélisation d'images masquées - use_absolute_position_embeddings (
bool, facultatif, par défautTrue) — Indique s'il faut utiliser des embeddings de position absolus. - layer_scale_init_value (
float, facultatif, valeur par défaut0.1) — Échelle à utiliser dans les couches d'auto-attention. 0.1 pour les modèles de base, 1e-6 pour les grands modèles. Définir 0 pour désactiver l'échelle de couche. - use_mean_pooling (
bool, facultatif, par défautTrue) — Indique s'il faut effectuer un pooling moyen sur les états cachés finaux des patches plutôt que d'utiliser l'état caché final du jeton CLS, avant d'appliquer la tête de classification.
Ceci est la classe de configuration destinée à stocker la configuration d'un InternVLModel. Elle est utilisée pour instancier un modèle Internvl en fonction des arguments spécifiés, définissant ainsi l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de OpenGVLab/InternVL3-1B-hf
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
Exemple :
>>> from transformers import InternVLVisionConfig, InternVLVisionModel

>>> # Initializing a InternVLVisionModel OpenGVLab/InternVL3-1B-hf style configuration
>>> configuration = InternVLVisionConfig()

>>> # Initializing a model (with random weights) from the OpenGVLab/InternVL3-1B-hf configuration
>>> model = InternVLVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
InternVLConfig
classe transformers.InternVLConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneimage_token_id: int = 151667image_seq_length: int = 256downsample_ratio: float = 0.5projector_hidden_act: str = 'gelu'vision_feature_layer: int | list[int] = -1vision_feature_select_strategy: str = 'default'tie_word_embeddings: bool = True )
Paramètres
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], facultatif) — L'objet de configuration ou le dictionnaire du backbone visuel. - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig], facultatif) — L'objet de configuration ou le dictionnaire du backbone de texte. - image_token_id (
int, facultatif, par défaut151667) — L’index du jeton d’image utilisé comme espace réservé pour les images d’entrée. - image_seq_length (
int, facultatif, par défaut256) — Longueur de séquence d'un embedding d'image. - downsample_ratio (
float, facultatif, valeur par défaut 0.5) — Facteur de réduction de la taille de l'image. - projector_hidden_act (
str, facultatif, par défautgelu) — La fonction d'activation utilisée par le projecteur multimodal. - vision_feature_layer (
Union[int, list[int]], facultatif, par défaut-1) — L'indice de la couche à partir de laquelle extraire les caractéristiques visuelles. Si plusieurs indices sont fournis, les caractéristiques visuelles des indices correspondants sont concaténées pour former les caractéristiques visuelles. - vision_feature_select_strategy (
str, facultatif, par défautdefault) — Stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle issue du socle visuel. - tie_word_embeddings (
bool, facultatif, par défautTrue) — Indique s'il faut lier les embeddings de poids selon la correspondancetied_weights_keysdu modèle.
Ceci est la classe de configuration destinée à stocker la configuration d'un InternVLModel. Elle est utilisée pour instancier un modèle Internvl en fonction des arguments spécifiés, définissant ainsi l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de OpenGVLab/InternVL3-1B-hf
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
Exemple :
>>> from transformers import InternVLForConditionalGeneration, InternVLConfig

>>> # Initializing a InternVL style configuration
>>> configuration = InternVLConfig()

>>> # Initializing a model (with random weights) from the OpenGVLab/InternVL3-1B-hf configuration
>>> model = InternVLForConditionalGeneration(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
InternVLVisionModel
classe transformers.InternVLVisionModel
< source >( config: InternVLVisionConfig )
Paramètres
- config (InternVLVisionConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Le modèle Internvl brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( pixel_values: Tensorbool_masked_pos: typing.Optional[torch.BoolTensor] = None**kwargs ) → InternVLVisionModelOutputWithPooling or tuple(torch.Tensor)
Paramètres
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size)) — Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de GotOcr2ImageProcessor. Voir GotOcr2ImageProcessor.call() pour plus de détails (InternVLProcessor utilise GotOcr2ImageProcessor pour le traitement des images). - bool_masked_pos (
torch.BoolTensorde forme(batch_size, num_patches), facultatif) — Positions masquées booléennes. Indique quels patches sont masqués (1) et lesquels ne le sont pas (0).
Retourne
InternVLVisionModelOutputWithPooling ou tuple(torch.Tensor)
Un InternVLVisionModelOutputWithPooling ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (InternVLConfig) et des entrées.
La méthode forward du modèle InternVLVisionModel surcharge la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
last_hidden_state (
torch.Tensorde forme(batch_size, sequence_length, hidden_size)) — Séquence d'états cachés à la sortie de la dernière couche du modèle.pooler_output (
torch.Tensorde forme(batch_size, hidden_size)) — Moyenne des états cachés de la dernière couche des jetons de patch (en excluant le jeton [CLS]) si config.use_mean_pooling est défini sur True. S'il est défini sur False, l'état caché final du jeton [CLS] sera renvoyé.hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
InternVLModel
classe transformers.InternVLModel
< source >( config: InternVLConfig )
Paramètres
- config (InternVLConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Le modèle InternVL, qui se compose d'un backbone visuel et d'un modèle de langage, sans tête de modélisation du langage.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonevision_feature_layer: int | list[int] | None = Nonevision_feature_select_strategy: str | None = Nonemm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → InternVLModelOutputWithPast or tuple(torch.Tensor)
Paramètres
- input_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut.Les indices peuvent être obtenus à l'aide de AutoTokenizer. Consultez PreTrainedTokenizer.encode() et PreTrainedTokenizer.call() pour plus de détails.
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size), facultatif) — Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de GotOcr2ImageProcessor. Voir GotOcr2ImageProcessor.call() pour plus de détails (InternVLProcessor utilise GotOcr2ImageProcessor pour le traitement des images). - attention_mask (
torch.Tensorde forme(batch_size, sequence_length), facultatif) — Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans[0, 1]:- 1 pour les jetons qui ne sont pas masqués,
- 0 pour les jetons masqués.
- position_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, facultatif) — États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Cela consiste généralement en lapast_key_valuesretournée par le modèle à une étape antérieure du décodage, lorsqueuse_cache=Trueouconfig.use_cache=True.Seule une instance de Cache est autorisée en entrée, consultez notre guide du cache kv. Si aucun
past_key_valuesn'est transmis, DynamicCache sera initialisé par défaut.Le modèle produira le même format de cache qui est fourni en entrée.
Si
past_key_valuessont utilisés, l’utilisateur doit fournir uniquement lesinput_idsnon traités (ceux pour lesquels les états de clés et de valeurs passées n’ont pas été fournis à ce modèle) de forme(batch_size, unprocessed_length)au lieu de tous lesinput_idsde forme(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forme(batch_size, sequence_length, hidden_size), facultatif) — Facultativement, au lieu de passerinput_ids, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indicesinput_idsen vecteurs associés que la matrice de recherche d’intégration interne du modèle. - vision_feature_layer (
Union[int, list[int]], facultatif) — L'indice de la couche à partir de laquelle extraire la caractéristique visuelle. Si plusieurs indices sont fournis, les caractéristiques visuelles des indices correspondants sont concaténées pour former les caractéristiques visuelles. - vision_feature_select_strategy (
str, facultatif) — Stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle à partir du backbone visuel. Peut être"default"ou"full". - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], facultatif) — Dictionnaire dont les clés sont les modalités prises en charge et les valeurs sont les sorties encodées pour cette modalité. Chaque sortie encodée est un tuple composé de (pooler_output, facultatif :last_hidden_states, facultatif :hidden_states, facultatif :attentions)pooler_outputde forme(batch_size, sequence_length, hidden_size), facultatif) est une séquence de fonctions multimodales de l'encodeur fusionnées dans les embeddings de texte.
Retourne
InternVLModelOutputWithPast ou tuple(torch.Tensor)
Un InternVLModelOutputWithPast ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (InternVLConfig) et des entrées.
La méthode forward de InternVLModel redéfinit la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
last_hidden_state (
torch.Tensorde forme(batch_size, sequence_length, hidden_size)) — Séquence d'états cachés à la sortie de la dernière couche du modèle.Si
past_key_valuesest utilisé, seule la dernière hidden-state des séquences de forme(batch_size, 1, hidden_size)est renvoyée.past_key_values (
Cache, facultatif, renvoyé lorsqueuse_cache=Trueest passé ou lorsqueconfig.use_cache=True) — Il s’agit d’une instance de Cache. Pour plus de détails, consultez notre guide sur le cache kv.Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention) qui peuvent être utilisés (voir l'entrée
past_key_values) pour accélérer le décodage séquentiel.hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
image_hidden_states (
torch.Tensor, facultatif) — Untorch.Tensorde taille(batch_size, num_images, sequence_length, hidden_size). image_hidden_states du modèle produit par l’encodeur visuel et après projection de l’état caché final.
get_image_features
< source >( pixel_values: Tensorvision_feature_layer: int | list[int] | None = Nonevision_feature_select_strategy: str | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
Paramètres
- pixel_values (
torch.Tensorde forme(batch_size, channels, height, width)) — Les tenseurs correspondant aux images d'entrée. - vision_feature_layer (
intoulist[int]) — Index de couche ou liste d'indices de couches à partir desquels extraire les caractéristiques. - vision_feature_layer (
Union[int, list[int]], facultatif) — L'indice de la couche à partir de laquelle extraire la caractéristique visuelle. Si plusieurs indices sont fournis, les caractéristiques visuelles des indices correspondants sont concaténées pour former les caractéristiques visuelles. - vision_feature_select_strategy (
str, facultatif) — Stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle à partir du backbone visuel. Peut être"default"ou"full".
Retourne
BaseModelOutputWithPooling ou tuple(torch.Tensor)
Un BaseModelOutputWithPooling ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (InternVLConfig) et des entrées.
Obtient les derniers états cachés de l'image depuis la tour de vision et applique la projection multimodale.
last_hidden_state (
torch.Tensorde forme(batch_size, sequence_length, hidden_size)) — Séquence d'états cachés à la sortie de la dernière couche du modèle.pooler_output (
torch.Tensorde forme(batch_size, hidden_size)) — État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
InternVLForConditionalGeneration
classe transformers.InternVLForConditionalGeneration
< source >( config: InternVLConfig )
Paramètres
- config (InternVLConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Le modèle INTERNVL, qui se compose d'un backbone visuel et d'un modèle de langage.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonevision_feature_layer: int | list[int] | None = Nonevision_feature_select_strategy: str | None = Nonelabels: typing.Optional[torch.LongTensor] = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0image_sizes: typing.Optional[torch.Tensor] = Nonemm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → InternVLCausalLMOutputWithPast or tuple(torch.Tensor)
Paramètres
- input_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut.Les indices peuvent être obtenus à l'aide de AutoTokenizer. Consultez PreTrainedTokenizer.encode() et PreTrainedTokenizer.call() pour plus de détails.
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size), facultatif) — Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de GotOcr2ImageProcessor. Voir GotOcr2ImageProcessor.call() pour plus de détails (InternVLProcessor utilise GotOcr2ImageProcessor pour le traitement des images). - attention_mask (
torch.Tensorde forme(batch_size, sequence_length), facultatif) — Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans[0, 1]:- 1 pour les jetons qui ne sont pas masqués,
- 0 pour les jetons masqués.
- position_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, facultatif) — États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Cela consiste généralement en lapast_key_valuesretournée par le modèle à une étape antérieure du décodage, lorsqueuse_cache=Trueouconfig.use_cache=True.Seule une instance de Cache est autorisée en entrée, consultez notre guide du cache kv. Si aucun
past_key_valuesn'est transmis, DynamicCache sera initialisé par défaut.Le modèle produira le même format de cache qui est fourni en entrée.
Si
past_key_valuessont utilisés, l’utilisateur doit fournir uniquement lesinput_idsnon traités (ceux pour lesquels les états de clés et de valeurs passées n’ont pas été fournis à ce modèle) de forme(batch_size, unprocessed_length)au lieu de tous lesinput_idsde forme(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forme(batch_size, sequence_length, hidden_size), facultatif) — Facultativement, au lieu de passerinput_ids, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indicesinput_idsen vecteurs associés que la matrice de recherche d’intégration interne du modèle. - vision_feature_layer (
Union[int, list[int]], facultatif) — L'indice de la couche à partir de laquelle extraire la caractéristique visuelle. Si plusieurs indices sont fournis, les caractéristiques visuelles des indices correspondants sont concaténées pour former les caractéristiques visuelles. - vision_feature_select_strategy (
str, facultatif) — Stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle à partir du backbone visuel. Peut être"default"ou"full". - labels (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Étiquettes pour le calcul de la perte de modélisation de langage masquée. Les indices doivent être dans[0, ..., config.vocab_size]ou -100 (voir la docstring deinput_ids). Les jetons dont l'indice est défini sur-100sont ignorés (masqués), la perte n'est calculée que pour les jetons dont l'étiquette est dans[0, ..., config.vocab_size]. - logits_to_keep (
Union[int, torch.Tensor], facultatif, valeur par défaut0) — Si c'est unint, calcule les logits pour leslogits_to_keepderniers jetons. Si0, calcule les logits pour tous lesinput_ids(cas particulier). Seuls les logits du dernier jeton sont nécessaires pour la génération, et les calculer uniquement pour ce jeton peut économiser de la mémoire, ce qui devient assez significatif pour les séquences longues ou les tailles de vocabulaire importantes. Si c'est untorch.Tensor, il doit être 1D et correspondre aux indices à conserver dans la dimension de la longueur de la séquence. Cela est utile lors de l'utilisation du format de tenseurs empilés (une seule dimension pour le lot et la longueur de la séquence). - image_sizes (
torch.Tensorde forme(batch_size, 2), facultatif) — Les dimensions des images du lot, sous la forme (hauteur, largeur) pour chaque image. - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], facultatif) — Dictionnaire dont les clés sont les modalités prises en charge et les valeurs sont les sorties encodées pour cette modalité. Chaque sortie encodée est un tuple composé de (pooler_output, facultatif :last_hidden_states, facultatif :hidden_states, facultatif :attentions)pooler_outputde forme(batch_size, sequence_length, hidden_size), facultatif) est une séquence de fonctions multimodales de l'encodeur fusionnées dans les embeddings de texte.
Retourne
InternVLCausalLMOutputWithPast ou tuple(torch.Tensor)
Un InternVLCausalLMOutputWithPast ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (InternVLConfig) et des entrées.
La méthode forward de InternVLForConditionalGeneration surcharge la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
loss (
torch.Tensorde forme(1,), facultatif, renvoyé lorsquelabelsest fourni) — Perte de modélisation du langage (pour la prédiction du jeton suivant).logits (
torch.Tensorde forme(batch_size, sequence_length, config.vocab_size)) — Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).past_key_values (
Cache, facultatif, renvoyé lorsqueuse_cache=Trueest passé ou lorsqueconfig.use_cache=True) — Il s’agit d’une instance de Cache. Pour plus de détails, consultez notre guide sur le cache kv.Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention) qui peuvent être utilisés (voir l'entrée
past_key_values) pour accélérer le décodage séquentiel.hidden_states (
tuple[torch.Tensor], facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple[torch.Tensor], facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
image_hidden_states (
torch.Tensor, facultatif) — Untorch.Tensorde taille(batch_size, num_images, sequence_length, hidden_size). image_hidden_states du modèle produit par l’encodeur visuel et après projection de l’état caché final.
Exemple :
>>> import torch
>>> from transformers import AutoProcessor, AutoModelForImageTextToText

>>> torch_device = "cuda"
>>> processor = AutoProcessor.from_pretrained("OpenGVLab/InternVL3-1B-hf")
>>> model = AutoModelForImageTextToText.from_pretrained(
...     "OpenGVLab/InternVL3-1B-hf", dtype=torch.bfloat16, device_map=torch_device
... )

>>> messages = [
...     {
...         "role": "user",
...         "content": [
...             {
...                 "type": "image",
...                 "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/statue_of_liberty.jpg",
...             },
...             {
...                 "type": "image",
...                 "url": "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/dreamstime_golden_gate_flowers.jpg",
...             },
...             {"type": "text", "text": "These images depict two different landmarks. Can you identify them?"},
...         ],
...     },
... ]

>>> inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(torch_device)
>>> generate_ids = model.generate(**inputs, max_new_tokens=200)
>>> print(processor.decode(generate_ids[0, inputs["input_ids"].shape[1] :], skip_special_tokens=True))
The images depict the Statue of Liberty and the Golden Gate Bridge.
get_image_features
< source >( pixel_values: Tensorvision_feature_layer: int | list[int] | None = Nonevision_feature_select_strategy: str | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
Paramètres
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size)) — Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de GotOcr2ImageProcessor. Voir GotOcr2ImageProcessor.call() pour plus de détails (InternVLProcessor utilise GotOcr2ImageProcessor pour le traitement des images). - vision_feature_layer (
Union[int, list[int]], facultatif) — L'indice de la couche à partir de laquelle extraire la caractéristique visuelle. Si plusieurs indices sont fournis, les caractéristiques visuelles des indices correspondants sont concaténées pour former les caractéristiques visuelles. - vision_feature_select_strategy (
str, facultatif) — Stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle à partir du backbone visuel. Peut être"default"ou"full".
Retourne
BaseModelOutputWithPooling ou tuple(torch.Tensor)
Un BaseModelOutputWithPooling ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (InternVLConfig) et des entrées.
last_hidden_state (
torch.Tensorde forme(batch_size, sequence_length, hidden_size)) — Séquence d'états cachés à la sortie de la dernière couche du modèle.pooler_output (
torch.Tensorde forme(batch_size, hidden_size)) — État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
>>> from PIL import Image
>>> from transformers import AutoProcessor, InternVLForConditionalGeneration

>>> model = InternVLForConditionalGeneration.from_pretrained("OpenGVLab/InternVL3-1B-hf")
>>> processor = AutoProcessor.from_pretrained("OpenGVLab/InternVL3-1B-hf")

>>> messages = [
...     {
...         "role": "user", "content": [
...             {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
...             {"type": "text", "text": "Where is the cat standing?"},
...         ]
...     },
... ]

>>> inputs = processor.apply_chat_template(
...     messages,
...     tokenize=True,
...     return_dict=True,
...     return_tensors="pt",
...     add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
InternVLProcessor
classe transformers.InternVLProcessor
< source >( image_processor = Nonetokenizer = Nonevideo_processor = Noneimage_seq_length: int = 256chat_template = None**kwargs )
Paramètres
- image_processor (
GotOcr2ImageProcessor) — Le processeur d’images est une entrée obligatoire. - tokenizer (
Qwen2Tokenizer) — Le tokenizer est une entrée obligatoire. - video_processor (
InternVLVideoProcessor) — Le processeur vidéo est une entrée obligatoire. - image_seq_length (
int, facultatif, par défaut 256) — Le nombre de jetons d’image à utiliser par patch d’image. Il doit être défini de manière à ce que : image_seq_length = (config.image_size // config.patch_size) 2 * (config.scale_factor2) - chat_template (
str) — Un modèle Jinja pour convertir des listes de messages d'une conversation en une chaîne tokenisable.
Construit un InternVLProcessor qui encapsule un processeur d’images, un tokeniseur et un processeur de vidéos en un seul processeur.
InternVLProcessor offre toutes les fonctionnalités de GotOcr2ImageProcessor, Qwen2Tokenizer et InternVLVideoProcessor. Consultez ~GotOcr2ImageProcessor, ~Qwen2Tokenizer et ~InternVLVideoProcessor pour plus d’informations.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = Nonevideos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None**kwargs: *<class 'transformers.models.internvl.processing_internvl.InternVLProcessorKwargs'> ) → BatchFeature
Paramètres
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], facultatif) — Image à prétraiter. S'attend à une image unique ou à un lot d'images dont les valeurs de pixels vont de 0 à 255. Si vous passez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissezdo_rescale=False. - text (
Union[str, list[str], list[list[str]]], facultatif) — La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes de caractères (chaînes pré-tokenisées). Si vous passez une entrée pré-tokenisée, définissezis_split_into_words=Truepour éviter toute ambiguïté avec les entrées en lot. - videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]], facultatif) — Vidéo à prétraiter. S’attend à une vidéo unique ou à un lot de vidéos dont les valeurs de pixels vont de 0 à 255. Si vous passez des vidéos dont les valeurs de pixels sont comprises entre 0 et 1, définissezdo_rescale=False. - return_tensors (
strou TensorType, facultatif) — Si défini, renvoie des tenseurs d'un framework particulier. Les valeurs acceptées sont :'pt': Renvoie des objetstorch.Tensorde PyTorch.'np': Renvoie des objets NumPynp.ndarray.
- **kwargs (ProcessingKwargs, facultatif) — Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
Retourne
Un BatchFeature avec les champs suivants :
- input_ids — Liste des identifiants de jetons à fournir à un modèle. Renvoyé lorsque
textn'est pasNone. - attention_mask — Liste d’indices spécifiant les jetons auxquels le modèle doit prêter attention (lorsque
return_attention_mask=Trueou si “attention_mask” est présent dansself.model_input_nameset sitextn’est pasNone). - pixel_values — Valeurs des pixels à fournir à un modèle. Renvoyé lorsque
imagesn'est pasNone.
InternVLVideoProcessor
classe transformers.InternVLVideoProcessor
< source >( **kwargs: *<class 'transformers.models.internvl.video_processing_internvl.InternVLVideoProcessorInitKwargs'> )
Paramètres
Construit un processeur vidéo InternVLVideoProcessor.
sample_frames
< source >( metadata: VideoMetadatanum_frames: int | None = Nonefps: int | float | None = Noneinitial_shift: bool | float | int | None = None**kwargs ) → torch.Tensor
Paramètres
- metadata (
VideoMetadata) — Métadonnées de la vidéo contenant des informations sur la durée totale, le fps et le nombre total d’images. - num_frames (
int, facultatif) — Nombre maximal de frames à échantillonner. Valeur par défaut :self.num_frames. - fps (
intoufloat, facultatif) — Nombre de cibles d'images à échantillonner par seconde. La valeur par défaut estself.fps. - initial_shift (
bool,floatouint, par défautself.initial_shift) — Le décalage initial à appliquer lors de l'échantillonnage des images. SiTrue, le décalage est défini de manière à ce que les images soient échantillonnées à partir du milieu de la vidéo.
Retourne
torch.Tensor
Indices pour échantillonner les images vidéo.
Fonction d'échantillonnage par défaut qui échantillonne uniformément le nombre de frames souhaité entre 0 et le nombre total de frames.
Si fps est transmis avec les métadonnées, fps frames par seconde sont échantillonnées uniformément. Les arguments num_frames et fps sont mutuellement exclusifs.