
LeRobot documentation
LIBERO
LIBERO
LIBERO 是一个旨在研究机器人终身学习的基准——其核心理念是机器人需要随着时间推移与用户持续学习和适应,而不仅仅是进行一次预训练。它提供了一组标准化的操作任务,重点关注知识迁移:即机器人将已掌握的知识应用于新情境的能力。通过在 LIBERO 上进行评估,可以公平地比较不同的算法,研究人员也能在此基础上相互借鉴、推进工作。
- 论文:面向终身机器人学习的知识迁移基准测试
- GitHub: Lifelong-Robot-Learning/LIBERO
- 项目网站:libero-project.github.io
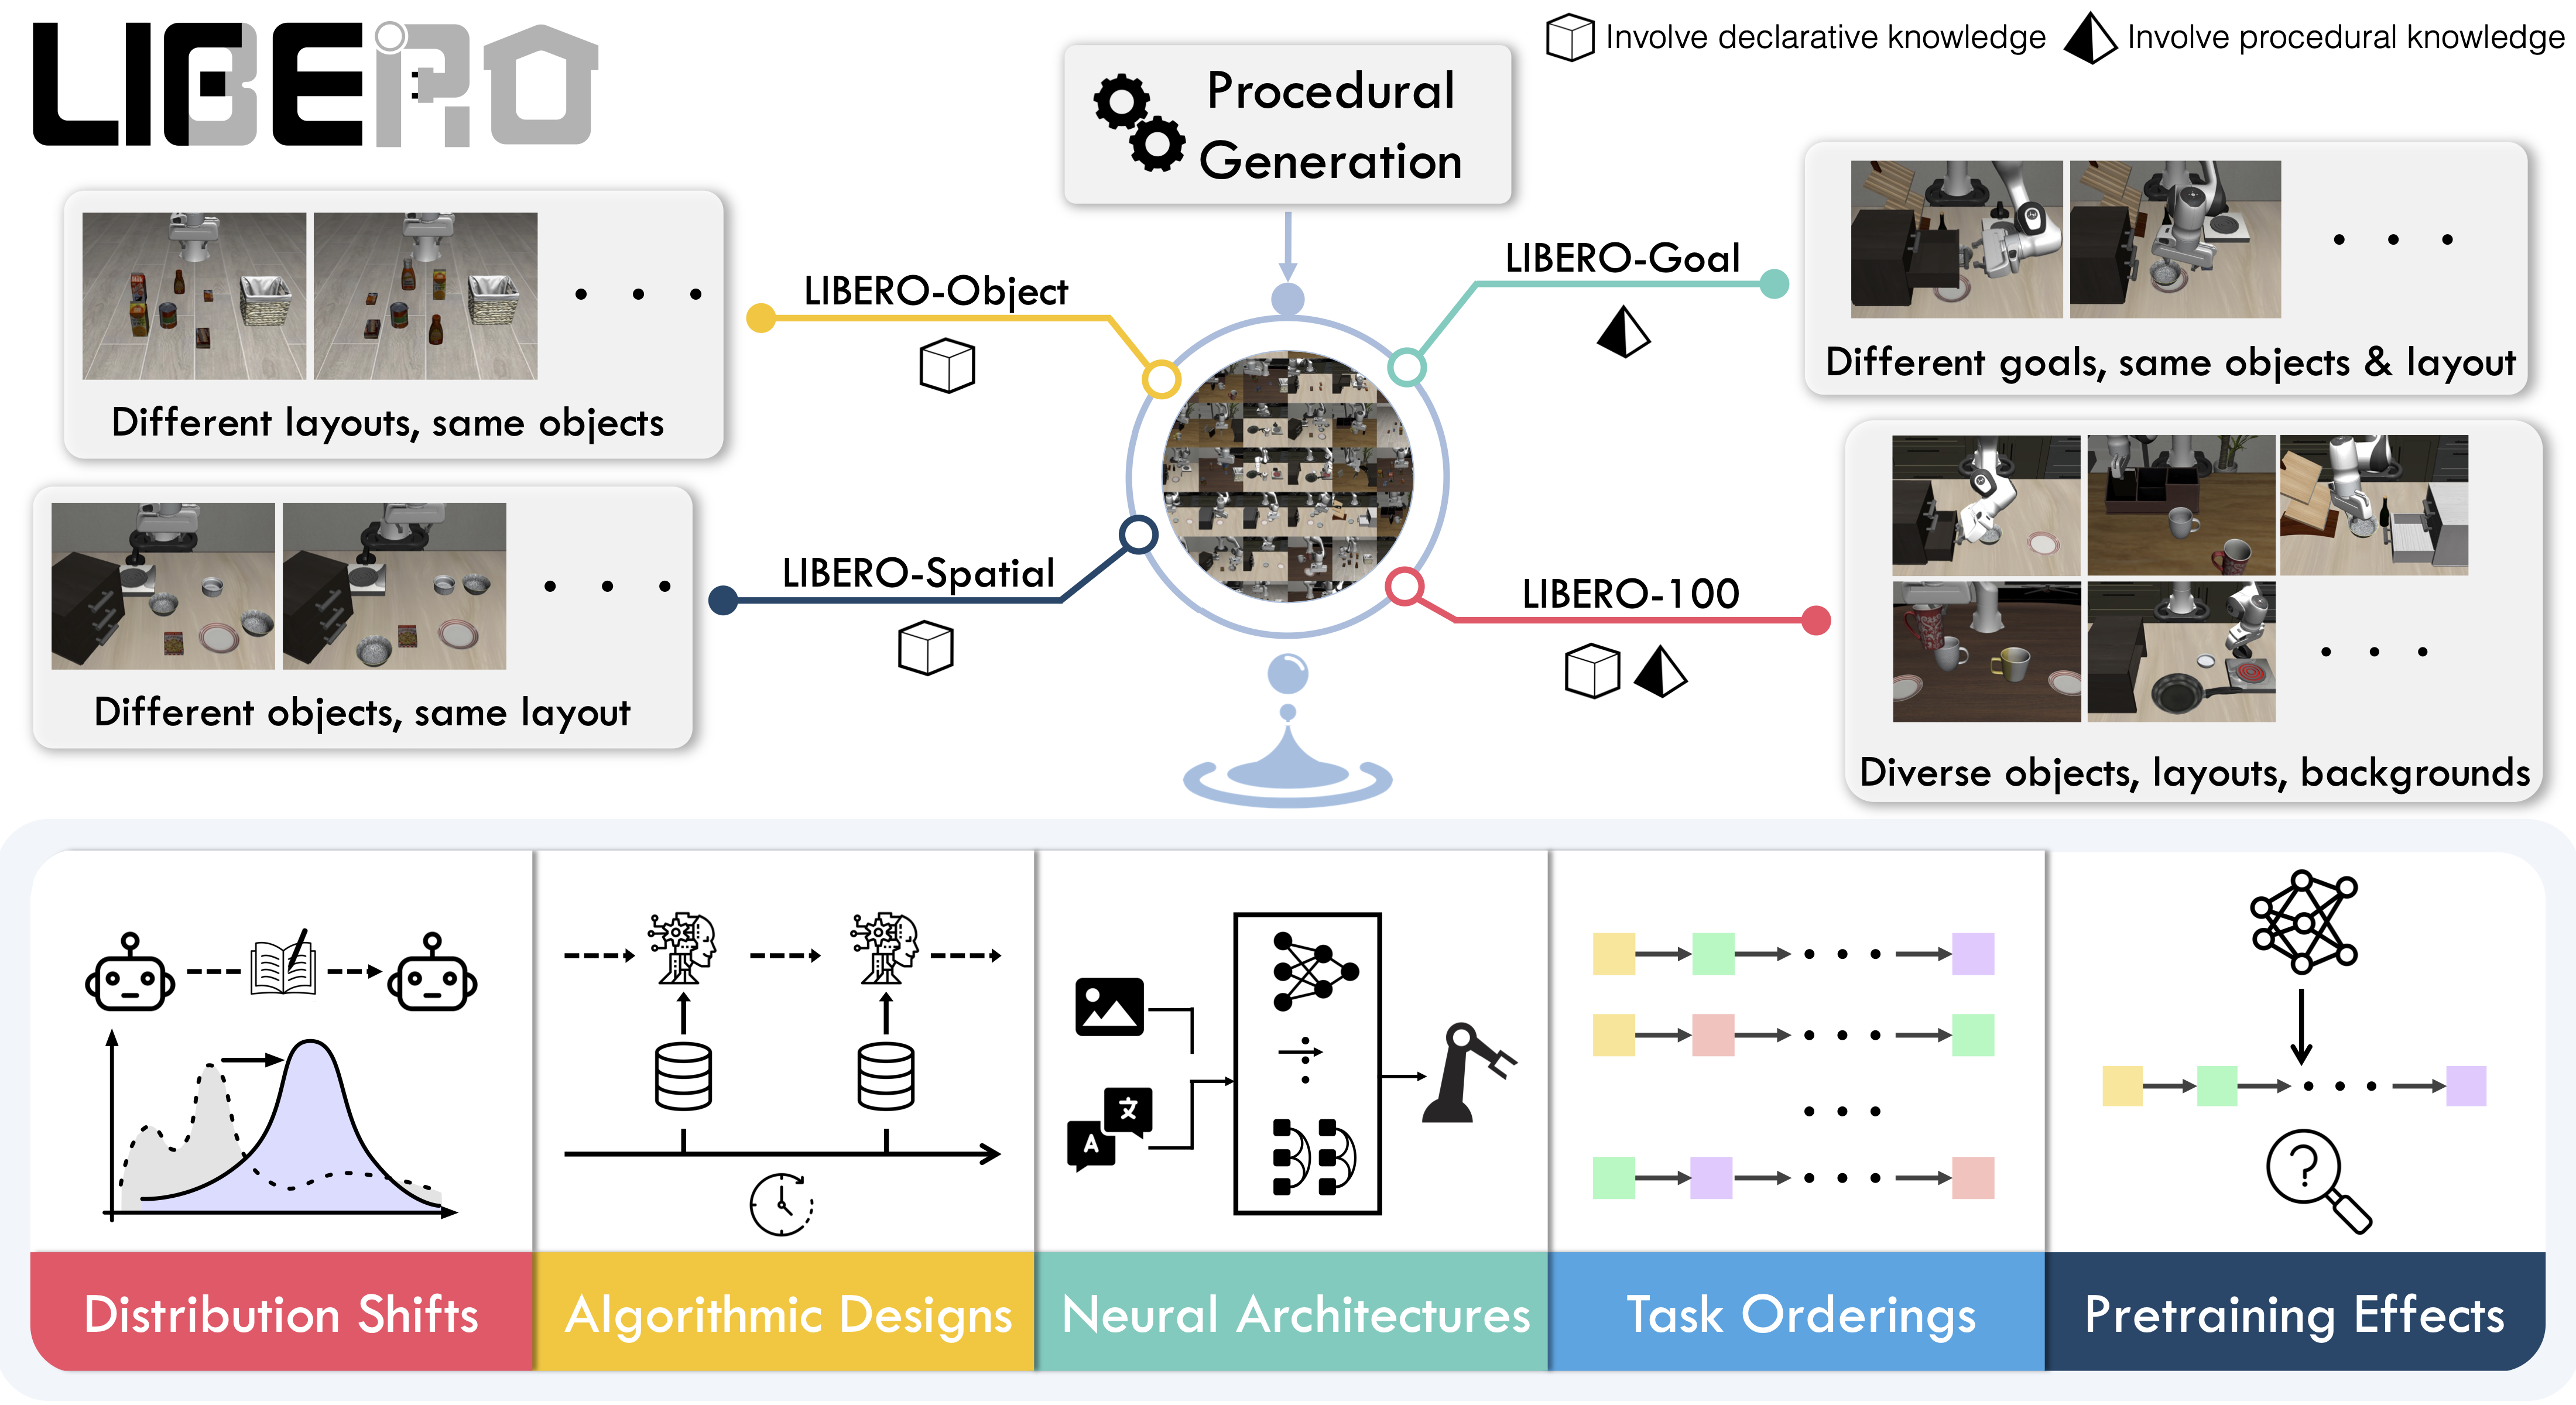
可用任务
LIBERO 包含 五个任务套件,涵盖 130 个任务,从简单的物体操作到复杂的多步骤场景:
| 套件 | CLI 名称 | 任务 | 描述 |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | 需要推理空间关系的任务 |
| LIBERO-Object | libero_object | 10 | 以操作不同对象为中心的任务 |
| LIBERO-Goal | libero_goal | 10 | 目标条件任务,目标会发生变化 |
| LIBERO-90 | libero_90 | 90 | 来自 LIBERO-100 数据集的短期任务 |
| LIBERO-Long | libero_10 | 10 | 来自 LIBERO-100 数据集的长时程任务 |
安装
按照 LeRobot 安装说明操作后:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
评估
默认评估(推荐)
在四个标准测试套件上评估(每个任务 10 个回合):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
单套件评估
在单个 LIBERO 套件上评估:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.task用于选择测试套件(libero_object、libero_spatial等)。--env.task_ids用于限制为特定的任务索引([0]、[1,2,3]等)。省略该参数将运行套件中的所有任务。--eval.batch_size控制并行运行的环境数量。--eval.n_episodes设置每个任务运行的回合数。
多套件评估
通过传入逗号分隔的列表,一次性在多个测试套件上对策略进行基准测试:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
控制模式
LIBERO 支持两种控制模式——relative(默认)和 absolute。不同的 VLA 检查点采用不同的动作参数化方式训练,因此请确保所选模式与您的策略相匹配:
--env.control_mode=relative # or "absolute"重置性能
默认情况下,LeRobot 会保留 LIBERO 的硬重置行为。在启用固定初始状态后,您可以选择使用软重置,以跳过在每个 episode 中重建模拟器模型和渲染器:
--env.init_states=true --env.hard_reset=false软重置速度更快,但在环境稳定步骤之后,其结果与硬重置并非逐位一致,因此相机观测值和策略结果可能存在细微差异。在复现基准测试结果时,请使用硬重置。
策略输入和输出
观察:
observation.state— 8 维本体感觉特征(末端执行器位置、轴角姿态、夹爪 qpos)observation.images.image— 主摄像头视图(agentview_image),HWC uint8observation.images.image2— 手腕相机视角(robot0_eye_in_hand_image),HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
操作:
Box(-1, 1, shape=(7,))中的连续控制 — 6 维末端执行器增量 + 1 维夹爪
推荐的评估回合
为了进行可复现的基准测试,请在所有四个标准套件(Spatial、Object、Goal、Long)中每个任务使用 10 个回合。这总共包含 400 个回合,并与已发布结果所使用的协议保持一致。由于成功率在不同评估种子之间可能会有几个百分点的差异,我们建议对 3 个种子取平均值。
lerobot-eval 会在每个成功率旁边报告 95% 威尔逊区间(pc_success_ci95)。在 10 个回合中,某任务得分为 9/10 时,其区间大约为 60% 到 98%;而在 400 个回合的测试套件中,总成功率为 80% 时,其区间大约为 76% 到 84%。如果两个策略在某任务上的区间存在重叠,则表明该次运行未能证明这两个策略在该任务上存在差异。该区间涵盖的是所抽取的回合,而不涵盖策略的训练随机种子,后者需要多次训练运行才能进行测量。
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
训练
数据集
两个经过预处理的 LIBERO 数据集与 LeRobot 完全兼容。它们包含相同的演示数据,具有相同的模式,区别仅在于相机帧的存储方式:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| episodes / frames / tasks | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| cameras | 2× 256×256×3 | 2× 256×256×3 |
| 状态 / 动作维度 | 8 / 7 | 8 / 7 |
| 数据集格式 | v3.0 | v3.0 |
| 相机编码 | MP4 视频 | parquet 中的 PNG |
| 下载大小 | 1.9 GB | 69.9 GB |
| 额外依赖 | 视频后端(torchcodec 或 pyav) | none |
我们推荐 lerobot/libero:下载体积缩小 37 倍,且加载速度相当(每个 worker 约 330 samples/s)。视频重新编码会引入轻微损失;如果无法安装视频解码后端,请使用基于图像的变体。
供参考,Physical Intelligence 发布的原始数据集:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
示例训练命令
在推荐的数据集上训练 SmolVLA:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
要在 Hub 上共享结果,请将 --policy.push_to_hub=false 替换为 --policy.repo_id=${HF_USER}/libero-smolvla。按照 评估 部分所示,使用 lerobot-eval 评估已保存的检查点。
复现已发表的结果
我们在 LIBERO 基准上复现了 Pi0.5 的结果。我们采用 Physical Intelligence 的 LIBERO 基础模型(pi05_libero),使用 HuggingFace LIBERO 数据集,在 8 块 H100 GPU 上以 bfloat16 精度、批大小 256 进行额外 6k 步的微调。
微调后的模型:lerobot/pi05_libero_finetuned
评估命令
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
我们将 n_action_steps=10 设置为 10,以匹配原始 OpenPI 实现。
结果
| 模型 | LIBERO 空间 | LIBERO 对象 | LIBERO 目标 | LIBERO 10 | 平均 |
|---|---|---|---|---|---|
| Pi0.5(LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
这些结果与 Physical Intelligence 报告的原始结果一致:
| 模型 | LIBERO 空间 | LIBERO 对象 | LIBERO 目标 | LIBERO 10 | 平均 |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |