
LeRobot documentation
LIBERO
LIBERO
LIBERO est un benchmark conçu pour étudier l'apprentissage robotique à vie — l’idée que les robots doivent continuer à apprendre et à s’adapter avec leurs utilisateurs au fil du temps, et ne pas simplement être pré-entraînés une seule fois. Il fournit un ensemble de tâches de manipulation standardisées qui se concentrent sur le transfert de connaissances : à quel point un robot peut appliquer ce qu’il a déjà appris à de nouvelles situations. En évaluant sur LIBERO, différents algorithmes peuvent être comparés de manière équitable et les chercheurs peuvent s’appuyer sur le travail des autres.
- Article : Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub : Lifelong-Robot-Learning/LIBERO
- Site web du projet : libero-project.github.io
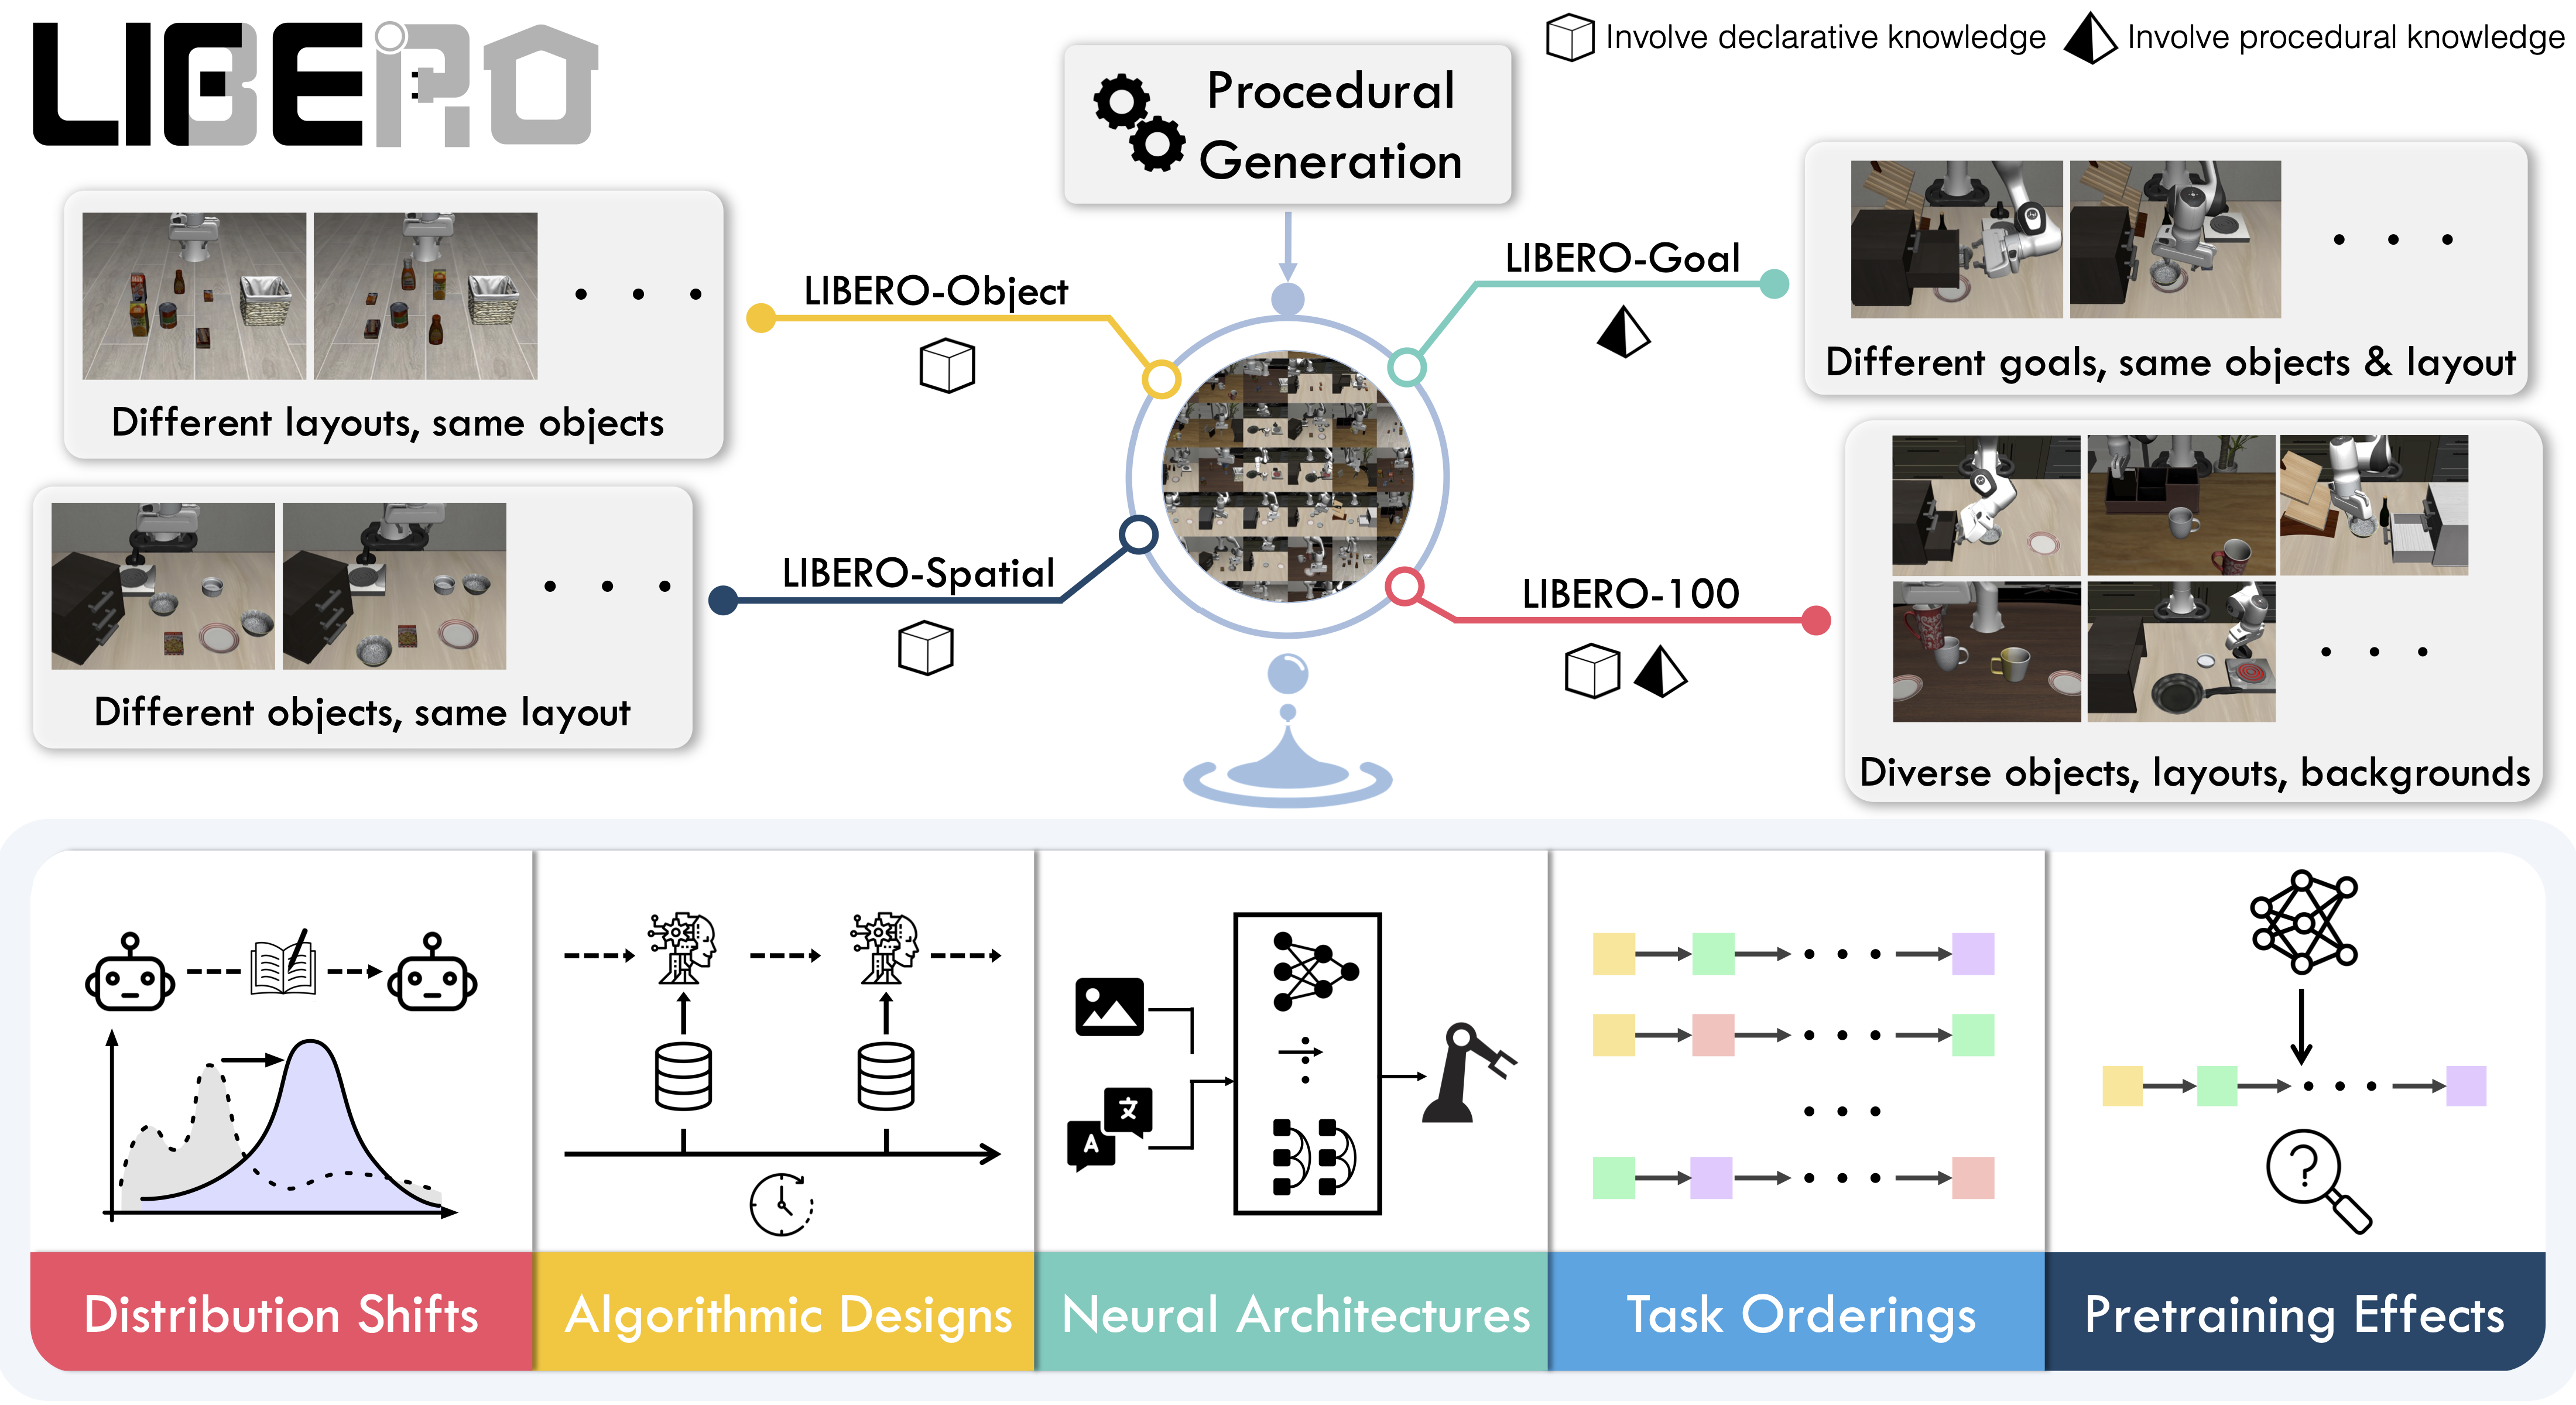
Tâches disponibles
LIBERO comprend cinq suites de tâches couvrant 130 tâches, allant de simples manipulations d'objets à des scénarios complexes multi-étapes :
| Suite | Nom de la CLI | Tâches | Description |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | Tâches nécessitant un raisonnement sur les relations spatiales |
| LIBERO-Object | libero_object | 10 | Tâches centrées sur la manipulation d'objets différents |
| LIBERO-Goal | libero_goal | 10 | Tâches conditionnées par un objectif avec des cibles changeantes |
| LIBERO-90 | libero_90 | 90 | Tâches à horizon court de la collection LIBERO-100 |
| LIBERO-Long | libero_10 | 10 | Tâches à long horizon de la collection LIBERO-100 |
Installation
Après avoir suivi les instructions d'installation de LeRobot :
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
Évaluation
Évaluation par défaut (recommandée)
Évaluer sur les quatre suites standard (10 épisodes par tâche) :
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
Évaluation sur une seule suite
Évaluer sur une seule suite LIBERO :
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.tasksélectionne la suite (libero_object,libero_spatial, etc.).--env.task_idsrestreint l’exécution à des indices de tâches spécifiques ([0],[1,2,3], etc.). Omettez ce paramètre pour exécuter toutes les tâches de la suite.--eval.batch_sizecontrôle le nombre d'environnements exécutés en parallèle.--eval.n_episodesdéfinit le nombre d'épisodes à exécuter par tâche.
Évaluation multi-suite
Évaluez une politique sur plusieurs suites à la fois en passant une liste séparée par des virgules :
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
Mode de contrôle
LIBERO prend en charge deux modes de contrôle — relative (par défaut) et absolute. Les différents points de contrôle VLA sont entraînés avec des paramétrisations d’actions différentes, assurez-vous donc que le mode correspond à votre politique :
--env.control_mode=relative # or "absolute"Réinitialiser les performances
Par défaut, LeRobot conserve le comportement de réinitialisation dure de LIBERO. Avec les états initiaux fixes activés, vous pouvez opter pour des réinitialisations douces afin d’éviter de reconstruire le modèle du simulateur et le moteur de rendu à chaque épisode :
--env.init_states=true --env.hard_reset=falseLes réinitialisations douces sont plus rapides, mais elles ne sont pas identiques au bit près aux réinitialisations dures après les étapes de stabilisation de l’environnement, de sorte que les observations de la caméra et les résultats de la politique peuvent différer légèrement. Utilisez des réinitialisations dures pour reproduire les résultats des benchmarks.
Entrées et sorties de la politique
Observations :
observation.state— 8 caractéristiques proprioceptives (position de l'effecteur, orientation en axe-angle, qpos de la pince)observation.images.image— vue de la caméra principale (agentview_image), HWC uint8observation.images.image2— vue de la caméra au poignet (robot0_eye_in_hand_image), HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
Actions :
- Contrôle continu dans
Box(-1, 1, shape=(7,))— delta de l'effecteur final 6D + pince 1D
Épisodes d'évaluation recommandés
Pour un benchmarking reproductible, utilisez 10 épisodes par tâche sur les quatre suites standard (Spatial, Object, Goal, Long). Cela représente 400 épisodes au total et correspond au protocole utilisé pour les résultats publiés. Les taux de réussite peuvent varier de quelques points de pourcentage d'un seed d'évaluation à l'autre, nous recommandons donc de faire la moyenne sur 3 seeds.
lerobot-eval affiche un intervalle de Wilson à 95 % (pc_success_ci95) à côté de chaque taux de réussite. Pour 10 épisodes, une tâche notée 9/10 a un intervalle d’environ 60 % à 98 %, et un total de suite de 400 épisodes à 80 % a un intervalle d’environ 76 % à 84 %. Deux politiques dont les intervalles se chevauchent sur une tâche n’ont pas été démontrées comme différentes sur cette tâche par cette exécution. L’intervalle couvre les épisodes tirés ; il ne couvre pas la graine d’entraînement de la politique, qui nécessite plus d’une exécution d’entraînement pour être mesurée.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
Entraînement
Jeu de données
Deux jeux de données LIBERO prétraités sont entièrement compatibles avec LeRobot. Ils contiennent les mêmes démonstrations avec le même schéma et diffèrent par la manière dont les images des caméras sont stockées :
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| épisodes / images / tâches | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| caméras | 2× 256×256×3 | 2× 256×256×3 |
| dimensions de l'état / de l'action | 8 / 7 | 8 / 7 |
| format de jeu de données | v3.0 | v3.0 |
| encodage de caméra | Vidéo MP4 | PNG dans parquet |
| taille du téléchargement | 1,9 Go | 69,9 Go |
| dépendance supplémentaire | backend vidéo (torchcodec ou pyav) | none |
Nous recommandons lerobot/libero : téléchargement 37 fois plus petit avec une vitesse de chargement équivalente (~330 échantillons/s par worker). La réencodage vidéo est légèrement dégradé ; utilisez la variante basée sur les images si vous ne pouvez pas installer un backend de décodage vidéo.
Pour référence, le jeu de données original publié par Physical Intelligence :
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
Exemple de commande d'entraînement
Entraîner SmolVLA sur le jeu de données recommandé :
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Pour partager le résultat sur le Hub, remplacez --policy.push_to_hub=false par --policy.repo_id=${HF_USER}/libero-smolvla. Évaluez les points de contrôle enregistrés avec lerobot-eval comme indiqué dans la section Évaluation.
Reproduire des résultats publiés
Nous reproduisons les résultats de Pi0.5 sur le benchmark LIBERO. Nous prenons le modèle de base LIBERO de Physical Intelligence (pi05_libero) et l’affinons pendant 6 000 étapes supplémentaires en bfloat16, avec une taille de lot de 256 sur 8 GPU H100 en utilisant le jeu de données LIBERO de HuggingFace.
Le modèle affiné : lerobot/pi05_libero_finetuned
Commande d'évaluation
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
Nous définissons n_action_steps=10, conformément à l'implémentation originale d'OpenPI.
Résultats
| Modèle | LIBERO Spatial | LIBERO Object | Objectif LIBERO | LIBERO 10 | Moyenne |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
Ces résultats sont cohérents avec les résultats originaux rapportés par Physical Intelligence :
| Modèle | LIBERO Spatial | LIBERO Object | Objectif LIBERO | LIBERO 10 | Moyenne |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |