Hub documentation
Widgets
Widgets
O que é um widget?
Muitos repositórios de modelos possuem um widget que permite a qualquer pessoa executar inferências diretamente no navegador. Esses widgets são impulsionados por Inference Providers, que oferecem aos desenvolvedores acesso simplificado e unificado a centenas de modelos de machine learning, com o suporte de nossos parceiros de inferência serverless.
Aqui estão alguns exemplos de modelos populares atuais:
- DeepSeek V3 - Modelo conversacional de pesos abertos com o estado da arte
- Flux Kontext - Modelo de transformer de pesos abertos para edição de imagens
- Deteção de NSFW do Falconsai - Moderação de conteúdo de imagem
- Chatterbox da ResembleAI - Modelo de texto para fala de código aberto de nível de produção.
Você pode explorar mais modelos e seus widgets na página de modelos ou experimentá-los interativamente no Inference Playground.
Ativando um widget
Os widgets são exibidos quando o modelo é hospedado por pelo menos um Inference Provider, garantindo desempenho e confiabilidade ideais para a inferência do modelo. Os provedores escolhem e controlam autonomamente quais modelos implantam.
O tipo de widget exibido (texto para imagem, reconhecimento automático de fala, etc.) é inferido a partir do pipeline_tag do modelo, uma tag especial que o Hub tenta calcular automaticamente para todos os modelos. A única exceção é o widget conversational, que é exibido em todos os modelos com pipeline_tag igual a text-generation ou image-text-to-text. Optamos por expor apenas um widget por modelo, por simplicidade.
Para algumas bibliotecas, como transformers, o tipo de modelo pode ser inferido automaticamente com base nos arquivos de configuração (config.json). A arquitetura pode determinar o tipo: por exemplo, AutoModelForTokenClassification corresponde a token-classification. Se você tiver interesse nisso, pode ver o pseudocódigo em este gist.
Para a maioria dos outros casos de uso, usamos as tags do modelo para determinar o tipo de tarefa do modelo. Por exemplo, se houver tag: text-classification no metadados do cartão do modelo, a pipeline_tag inferida será text-classification.
Você pode sempre sobrescrever manualmente o tipo do seu pipeline com pipeline_tag: xxx no seu metadados do cartão do modelo. (Você também pode usar o editor de interface gráfica de metadados para fazer isso).
Como posso controlar a entrada de exemplo do widget do meu modelo?
Você pode especificar a entrada do widget na seção de metadados do cartão do modelo:
widget:
  - text: "This new restaurant has amazing food and great service!"
    example_title: "Positive Review"
  - text: "I'm really disappointed with this product. Poor quality and overpriced."
    example_title: "Negative Review"
  - text: "The weather is nice today."
    example_title: "Neutral Statement"
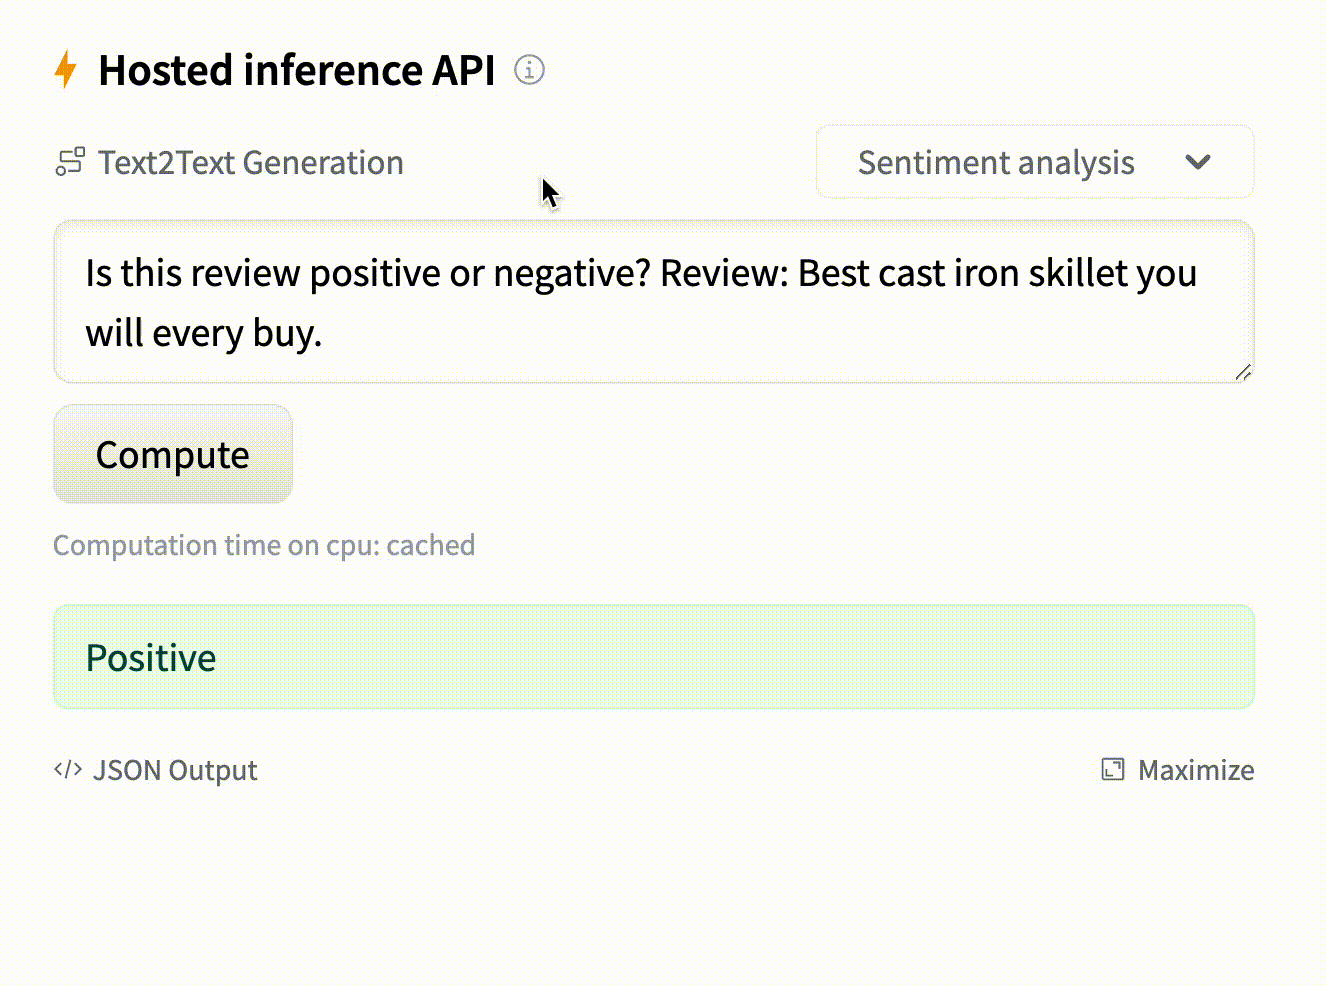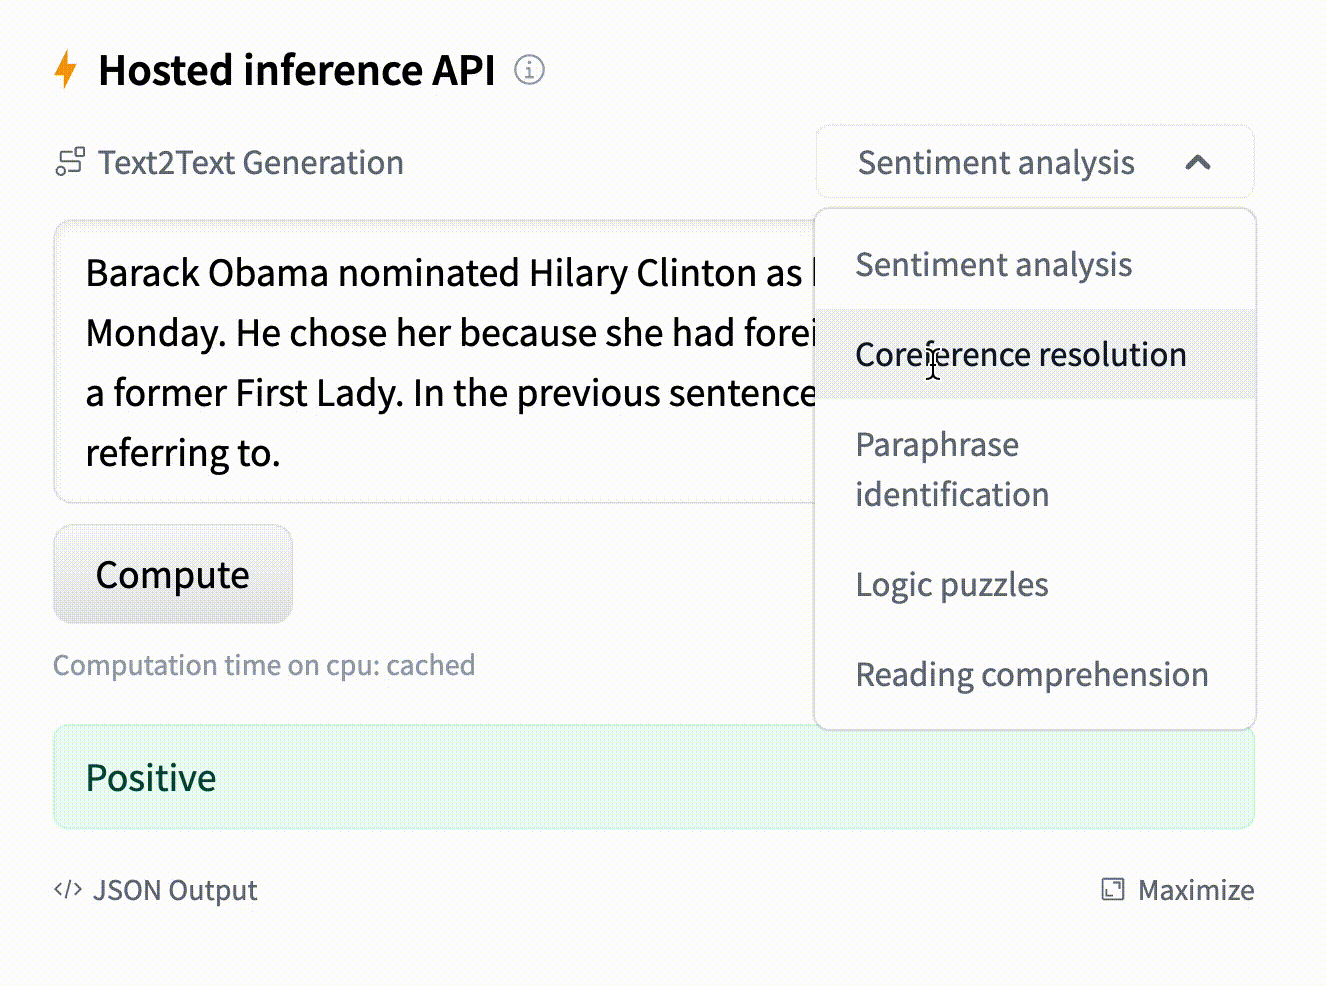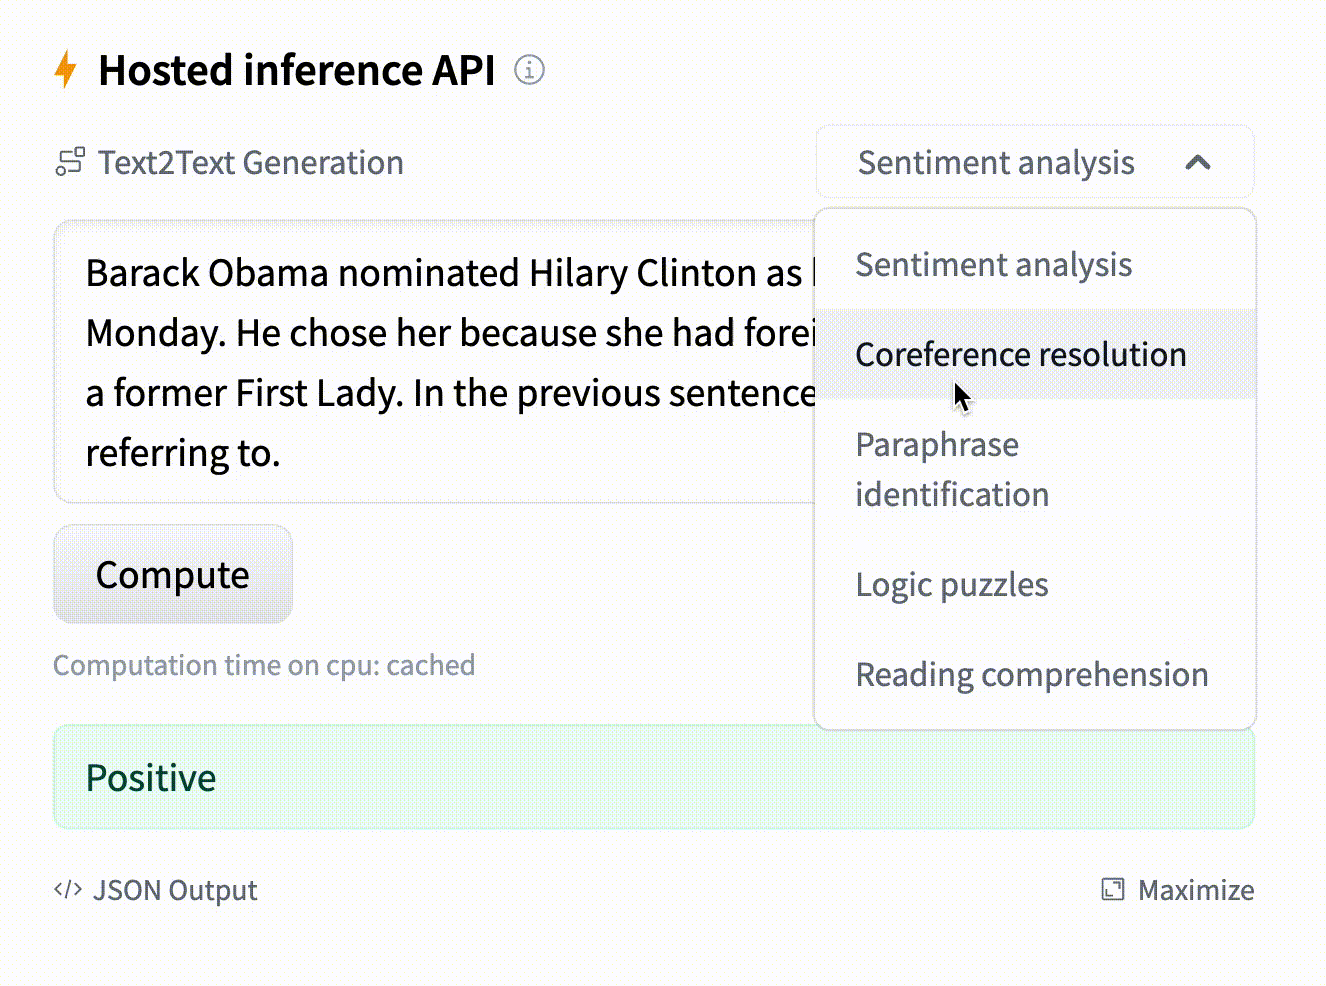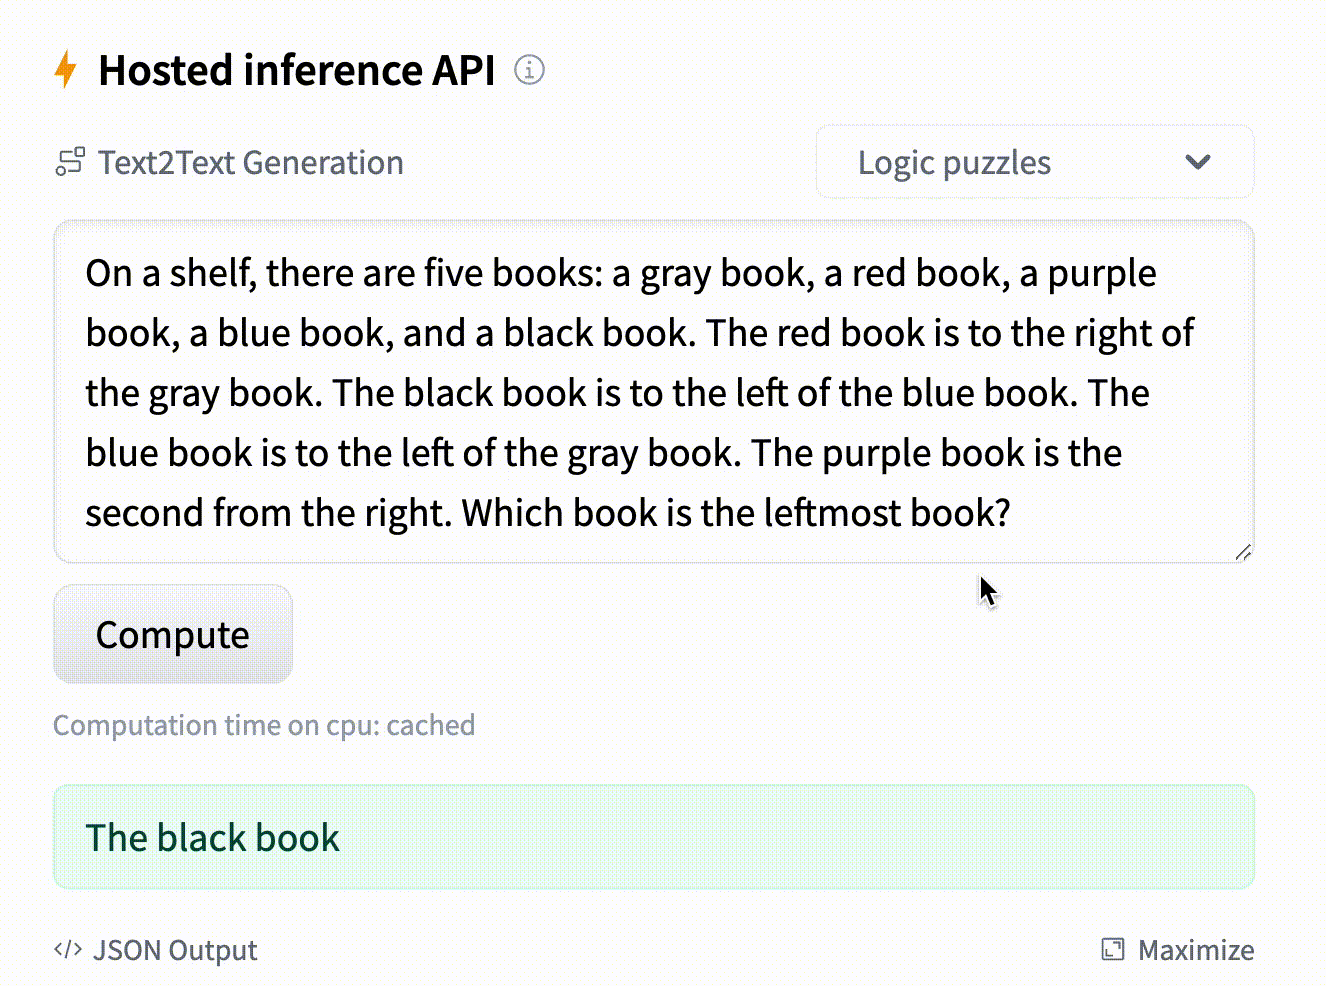
Você pode fornecer mais de uma entrada de exemplo. No menu suspenso de exemplos do widget, eles aparecerão como Example 1, Example 2, etc. Opcionalmente, você também pode fornecer example_title.
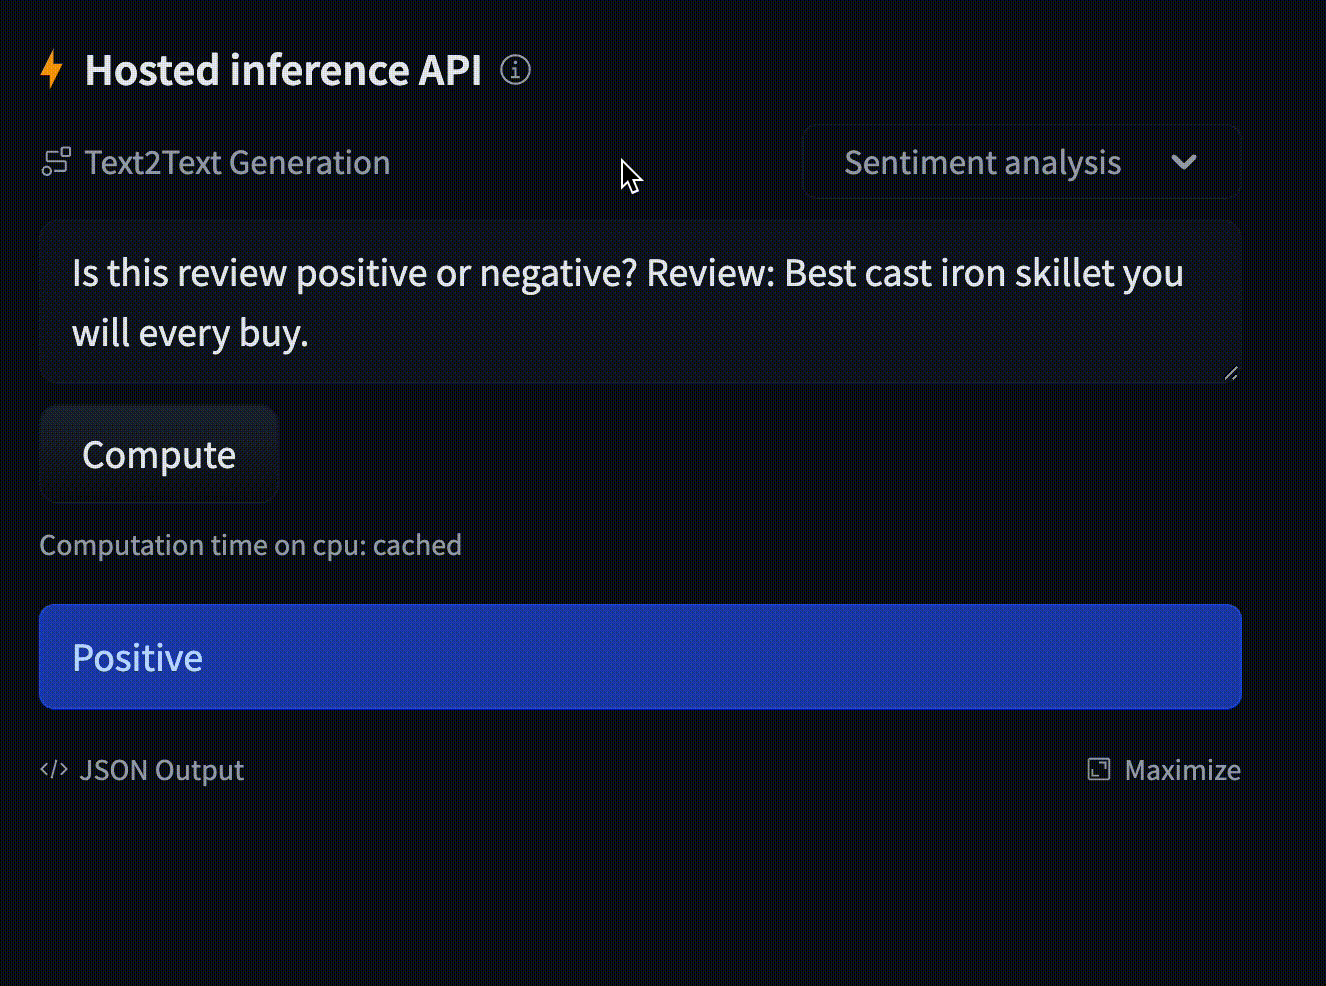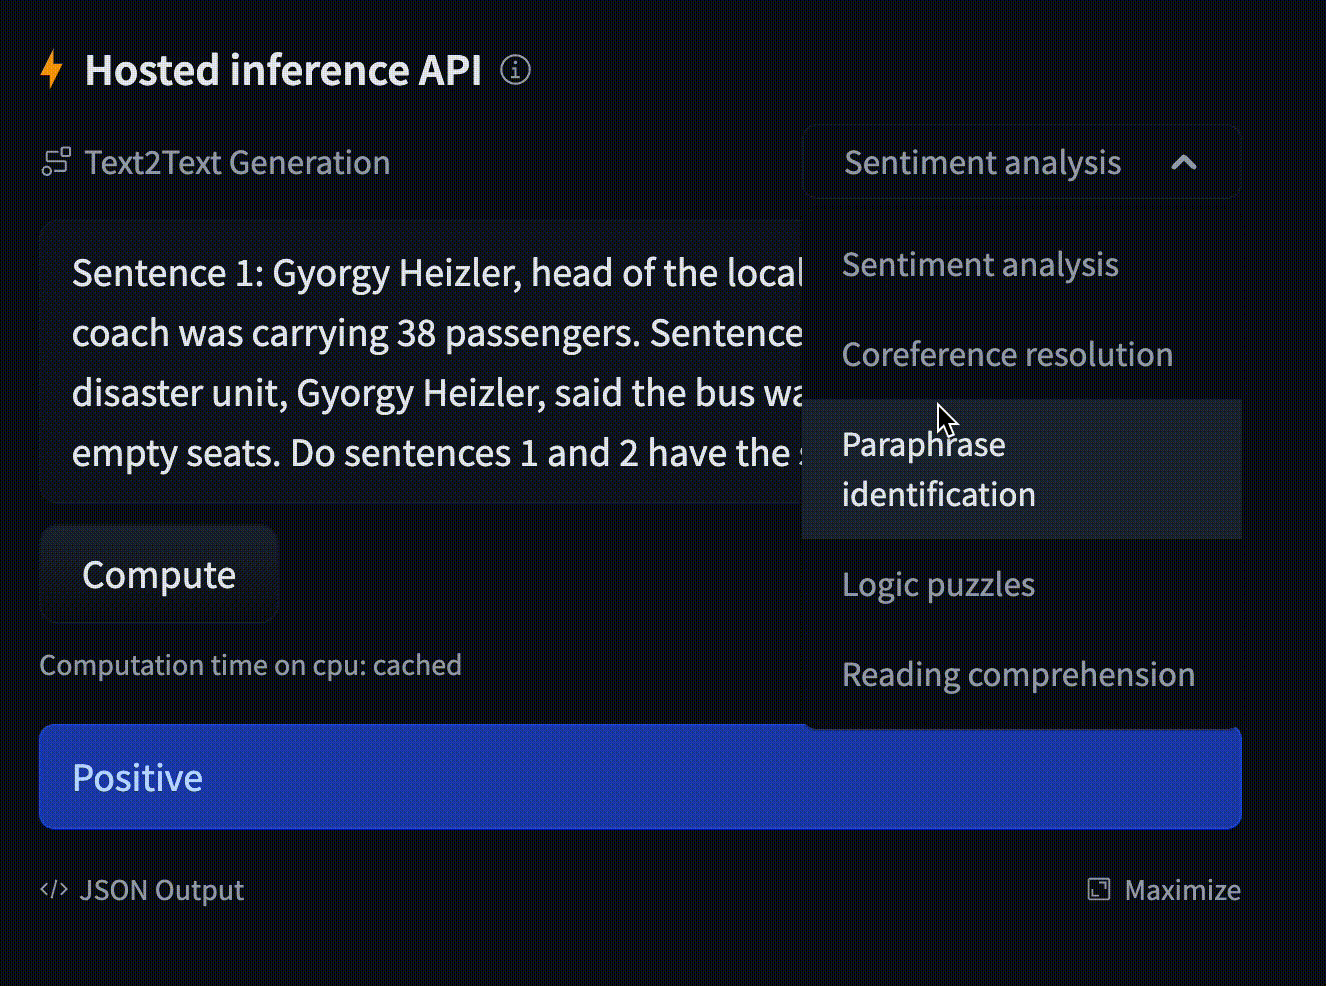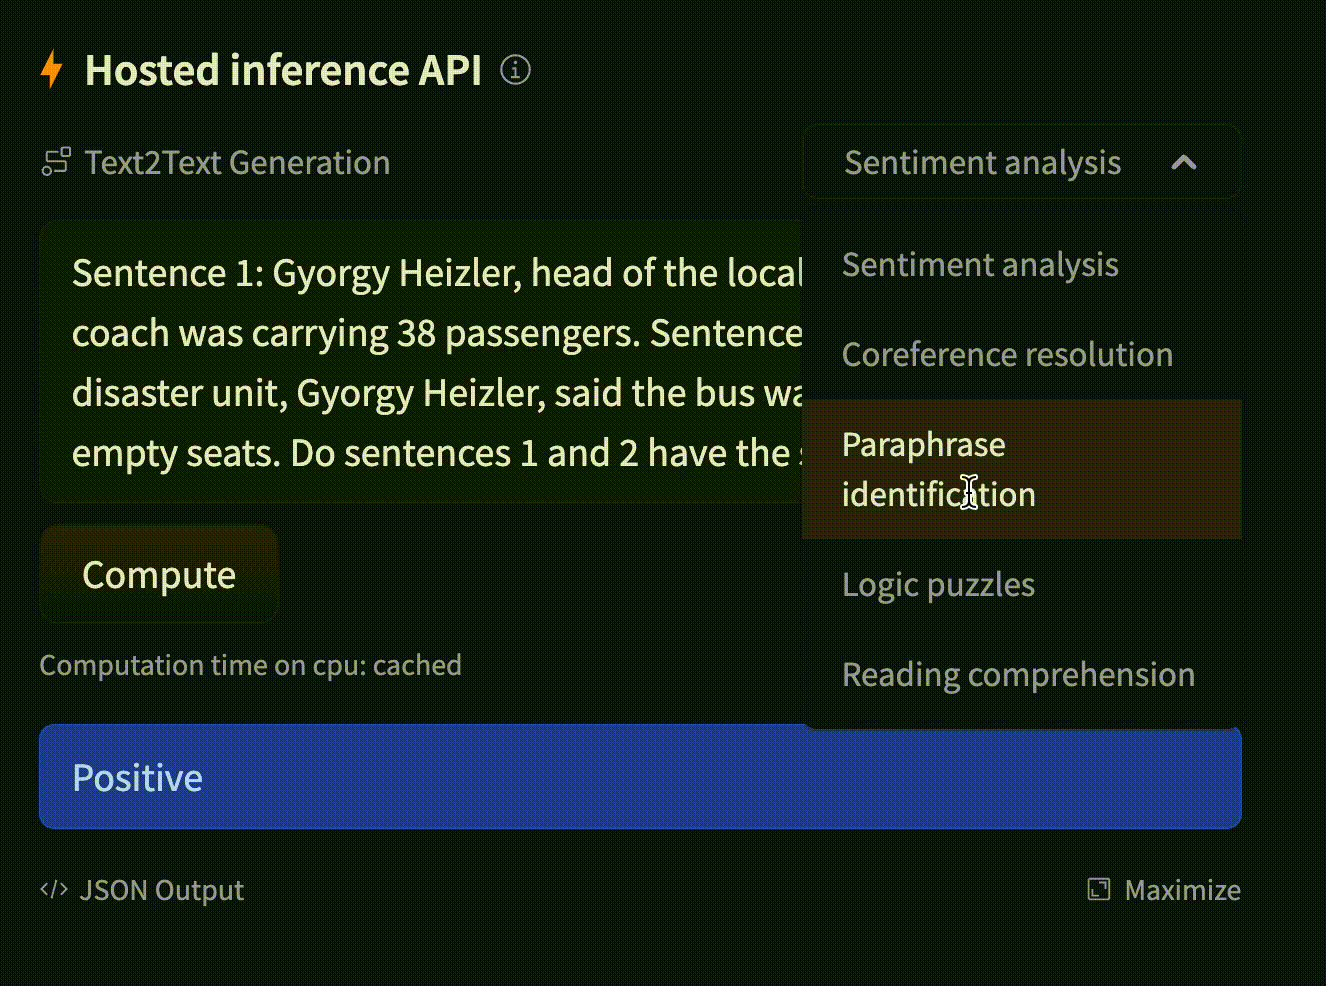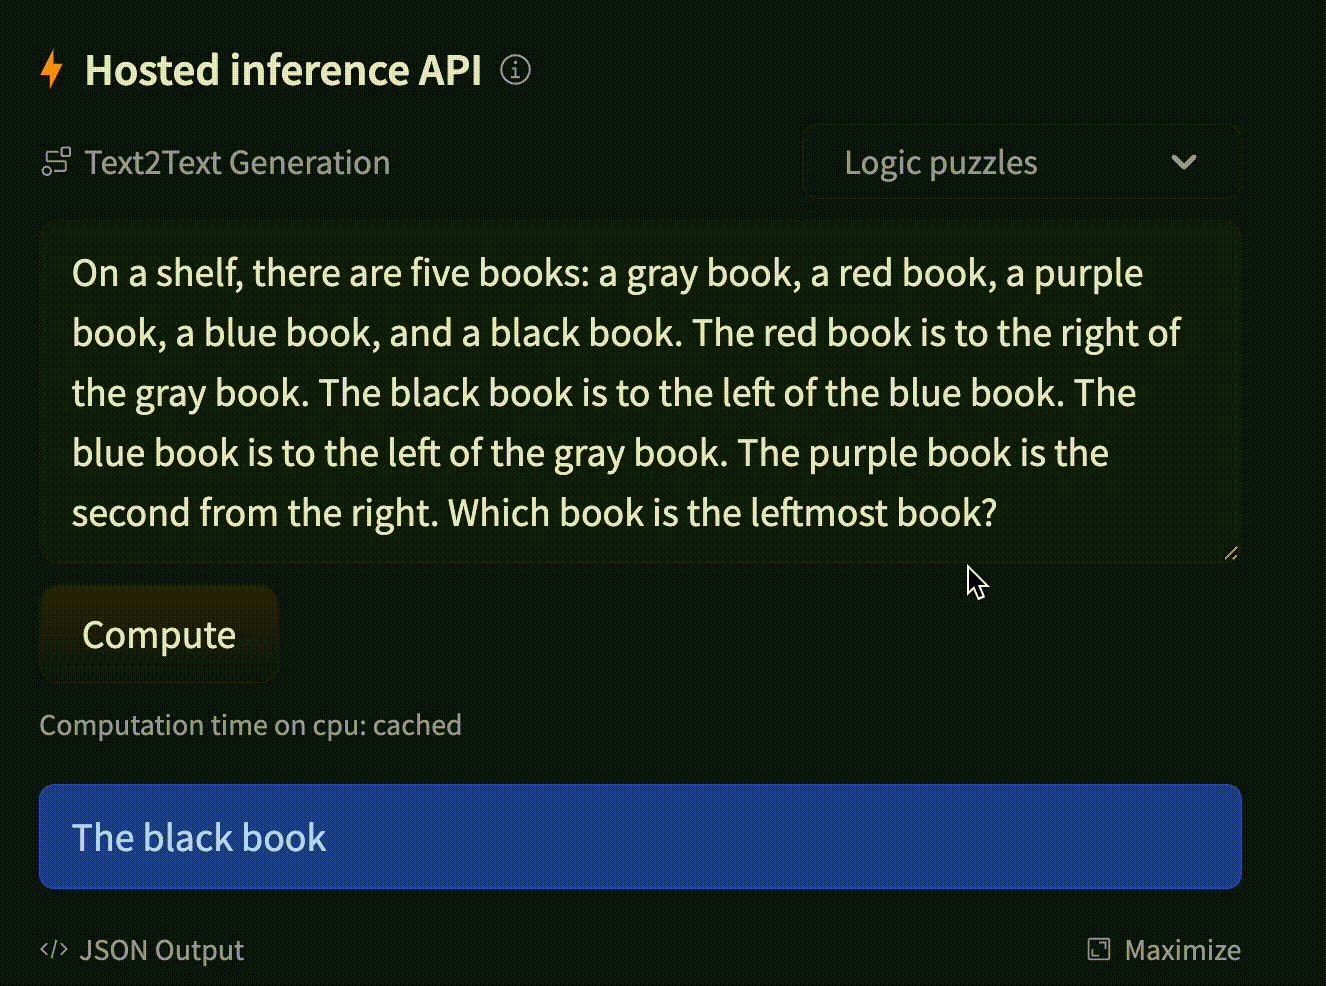
widget:
  - text: "Is this review positive or negative? Review: Best cast iron skillet you will ever buy."
    example_title: "Sentiment analysis"
  - text: "Barack Obama nominated Hilary Clinton as his secretary of state on Monday. He chose her because she had ..."
    example_title: "Coreference resolution"
  - text: "On a shelf, there are five books: a gray book, a red book, a purple book, a blue book, and a black book ..."
    example_title: "Logic puzzles"
  - text: "The two men running to become New York City's next mayor will face off in their first debate Wednesday night ..."
    example_title: "Reading comprehension"
Além disso, você pode especificar exemplos de entrada não textuais nos metadados do cartão do modelo. Consulte aqui para uma lista completa dos formatos de entrada de exemplo para todos os tipos de widget. Para os tipos de widget de visão & áudio, forneça exemplos de entrada com src em vez de text.
Por exemplo, permita que os usuários escolham entre dois arquivos de áudio de exemplo para tarefas de reconhecimento automático de fala, da seguinte forma:
widget:
  - src: https://example.org/somewhere/speech_samples/sample1.flac
    example_title: Speech sample 1
  - src: https://example.org/somewhere/speech_samples/sample2.flac
    example_title: Speech sample 2
Observe que você também pode incluir arquivos de exemplo em seu repositório de modelo e usá-los como:
widget:
  - src: https://huggingface.co/username/model_repo/resolve/main/sample1.flac
    example_title: Custom Speech Sample 1
Mas, de forma ainda mais conveniente, se o arquivo estiver no repositório correspondente do modelo, você pode simplesmente usar o nome do arquivo ou o caminho do arquivo dentro do repositório:
widget:
  - src: sample1.flac
    example_title: Custom Speech Sample 1
ou se estava aninhado dentro do repositório:
widget:
  - src: nested/directory/sample1.flac
Fornecemos exemplos de entradas para alguns idiomas e a maioria dos tipos de widgets no arquivo default-widget-inputs.ts. Se alguns exemplos estiverem ausentes, aceitamos PRs da comunidade para adicioná-los!
Exemplos de saída
Como extensão para os exemplos de entrada, para cada exemplo de widget, você também pode descrever opcionalmente a saída correspondente do modelo, diretamente na propriedade output.
Isso é útil quando o modelo ainda não é suportado pelos Inference Providers, para que a página do modelo ainda possa demonstrar como o modelo funciona e quais resultados ele produz.
Por exemplo, para um modelo de automatic-speech-recognition:
widget:
  - src: sample1.flac
    output:
      text: "Hello my name is Julien"

A propriedade output deve ser um dicionário YAML que representa o formato de saída dos Inference Providers.
Para um modelo que gera texto, veja o exemplo acima.
Para um modelo que gera rótulos (como um modelo de text-classification, por exemplo), a saída deve ser assim:
widget:
  - text: "I liked this movie"
    output:
      - label: POSITIVE
        score: 0.8
      - label: NEGATIVE
        score: 0.2

Por fim, para um modelo que gera uma imagem, áudio ou qualquer outro tipo de ativo, a saída deve incluir uma propriedade url que aponte para um nome de arquivo ou caminho dentro do repositório ou para uma URL remota. Por exemplo, para um modelo de texto para imagem:
widget:
  - text: "picture of a futuristic tiger, artstation"
    output:
      url: images/tiger.jpg

Também podemos exibir os exemplos de saída na interface do Hugging Face, por exemplo, para um modelo de texto para imagem, a fim de exibir uma galeria de gerações de imagens impressionantes.

Disponibilidade de widgets e suporte de provedores
Nem todos os modelos têm widgets disponíveis. A disponibilidade de widgets depende de:
- Suporte de tarefa: a tarefa do modelo deve ser suportada por pelo menos um provedor na rede de Inference Providers
- Disponibilidade de provedores: Pelo menos um provedor deve estar servindo o modelo específico
- Configuração do modelo: O modelo deve ter metadados e arquivos de configuração adequados
Para ver a lista completa de tarefas suportadas, consulte nossa página de documentação dedicada.
A lista de todos os provedores e as tarefas que eles suportam está disponível em esta página da documentação.
Para modelos sem suporte de provedor, você ainda pode demonstrar a funcionalidade usando exemplos de saída no cartão do seu modelo.
Você também pode clicar em Solicitar suporte do provedor diretamente na página do modelo para incentivar os provedores a oferecer o modelo, desde que haja interesse suficiente da comunidade.
Explorando modelos com o Inference Playground
Antes de integrar modelos em seus aplicativos, você pode testá-los interativamente com o Inference Playground. O playground permite que você:
- Teste diferentes modelos de conclusão de chat com prompts personalizados
- Compare respostas entre diferentes modelos
- Experimente com parâmetros de inferência, como temperatura, tokens máximos e mais
- Encontre o modelo perfeito para o seu caso de uso específico
O playground utiliza a mesma infraestrutura de Inference Providers que alimenta os widgets, portanto, você pode esperar desempenho e capacidades semelhantes ao integrar os modelos em seus próprios aplicativos.