
Hub documentation
Hugging Faceでの🤗 transformersの使用方法
Hugging Faceでの🤗 transformersの使用方法
🤗 transformers は、Hugging Face とコミュニティによってメンテナンスされているライブラリで、PyTorch、TensorFlow、JAX 向けの最先端の機械学習を提供します。テキスト、ビジョン、オーディオなどの異なるモダリティでのタスクを実行するために、数千の事前学習済みモデルを提供しています。少し偏見があるかもしれませんが、私たちは本当に 🤗 transformers が大好きです!
Hubで🤗 transformersを探る
Hubには63万を超えるtransformersモデルがあり、モデルページの左側でフィルタリングすることで検索できます。
さまざまなタスク向けのモデルを見つけることができます:
- コンテキストから回答を抽出する(質問応答)。
- 大規模なテキストから要約を作成する(summarization)。
- テキストを分類します(スパムかどうかの判定など、text-classification)。
- GPTなどのモデルで新しいテキストを生成します(text-generation)。
- 文の中で品詞(動詞、主語など)やエンティティ(国、組織など)を特定します(トークン分類)。
- 音声ファイルをテキストに書き起こします(automatic-speech-recognition)。
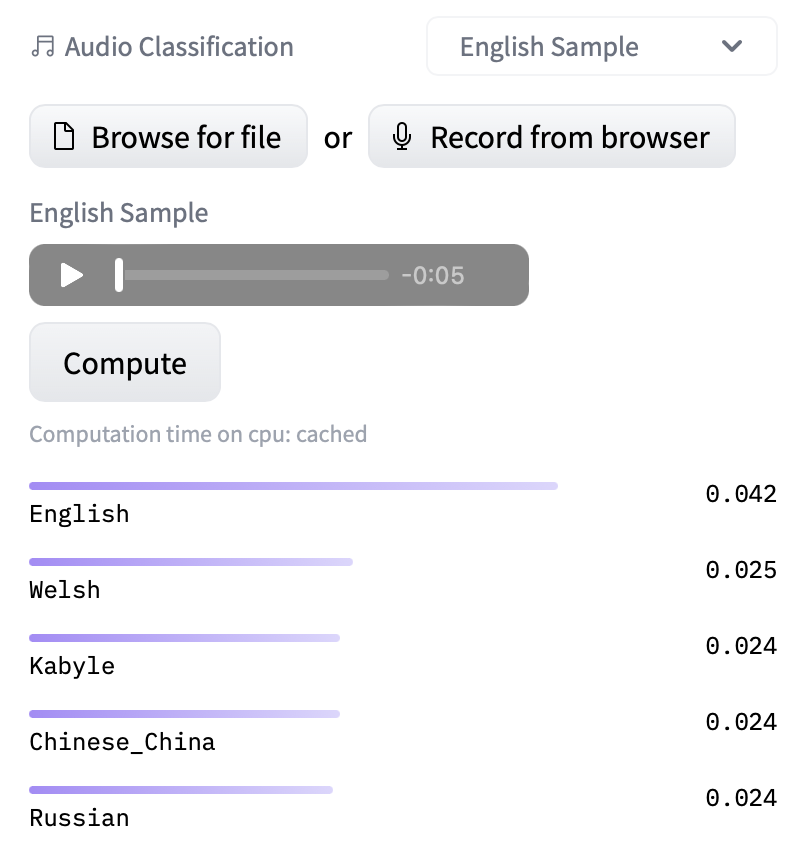
- 音声ファイルのスピーカーまたは言語を分類します(audio-classification)。
- 画像内のオブジェクトを検出します(object-detection)。
- 画像をセグメンテーション(image-segmentation)します。
- 強化学習(reinforcement-learning)を実装しましょう!
ブラウザ内ウィジェットのおかげで、モデルをダウンロードせずにブラウザ上で直接試すことができます。

Transformersリポジトリのファイル
Transformersのモデルリポジトリには、一般的にモデルファイルとプリプロセッサファイルが含まれます。

モデル
config.jsonファイルには、隠れ層の数、語彙サイズ、アテンションヘッドの数、各ヘッドの次元など、モデルアーキテクチャの詳細が保存されています。このメタデータは、モデルの設計図です。model.safetensorsファイルには、モデルの事前学習済みレイヤーと重みが保存されています。大規模なモデルの場合、読み込みに必要なメモリ量を制限するために、safetensors ファイルはシャード化されています。モデルの重みがどの safetensors ファイルから読み込まれるかを確認するには、model.safetensors.index.jsonファイルを参照してください。{ "metadata": { "total_size": 16060522496 }, "weight_map": { "lm_head.weight": "model-00004-of-00004.safetensors", "model.embed_tokens.weight": "model-00001-of-00004.safetensors", ... } }モデルカード上の↗ボタンをクリックすることでも、このマッピングを視覚化できます。

Safetensors は、モデルの重みを保存するための、pickle と比較してより安全で高速なシリアライズ形式です。
bin、pth、またはckptなどの形式でピクルス化された重みに遭遇する場合がありますが、safetensorsはより優れた代替手段として、モデルエコシステムにおいてますます採用されています。モデルには、テキスト生成の詳細(サンプリングを行うかどうか、サンプリング対象の上位トークン、温度、生成の開始と停止に使用する特殊トークンなど)を保存する
generation_config.jsonファイルが含まれている場合もあります。
Preprocessor
tokenizer_config.jsonファイルには、モデルによって追加される特殊トークンが保存されています。これらの特殊トークンは、文の開始、チャットテンプレートの特定のフォーマット、画像の指示など、モデルに対して多くの情報を伝えます。このファイルには、モデルが受け入れられる最大入力シーケンス長、プリプロセッサクラス、および返される出力も示されています。tokenizer.jsonファイルには、モデルが学習した語彙が保存されています。special_tokens_map.jsonは、特殊トークンのマッピングです。例えば、Llama 3.1-8B-Instruct では、文字列の開始トークンは"<|begin_of_text|>"です。
その他のモダリティでは、
tokenizer_config.jsonファイルの代わりにpreprocessor_config.jsonが使用されます。
既存のモデルを使用する
すべてのtransformerモデルは、1行のコードで利用できます! 利用方法に応じて、pipeline関数による高レベルAPIを使用するか、より詳細な制御のためにAutoModelを使用できます。
# With pipeline, just specify the task and the model id from the Hub.
from transformers import pipeline
pipe = pipeline("text-generation", model="distilbert/distilgpt2")

# If you want more control, you will need to define the tokenizer and model.
from transformers import AutoTokenizer, AutoModelForCausalLM
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilgpt2")
model = AutoModelForCausalLM.from_pretrained("distilbert/distilgpt2")
また、コミットハッシュ、タグ名、またはブランチに基づいて、特定のバージョンからモデルを読み込むこともできます。
model = AutoModel.from_pretrained(
    "julien-c/EsperBERTo-small", revision="v2.0.1"  # tag name, or branch name, or commit hash
)特定のモデルの読み込み方法を確認したい場合は、Use in Transformers をクリックすると、そのモデルを読み込める動作するスニペットが表示されます。モデルアーキテクチャに関する追加情報が必要な場合は、スニペットの下部にある「Read model documentation」をクリックすることもできます。


モデルの共有
transformersでのモデル共有に関する詳細については、公式ドキュメントのモデルの共有ガイドをご覧ください。
transformersの多くのクラス、例えばモデルやトークナイザーには、ファイルをリポジトリに簡単にアップロードできるpush_to_hubメソッドがあります。
# Pushing model to your own account
model.push_to_hub("my-awesome-model")

# Pushing your tokenizer
tokenizer.push_to_hub("my-awesome-model")

# Pushing all things after training
trainer.push_to_hub()さらに多くのことが可能なので、モデルの共有ガイドを確認することをお勧めします。