
Diffusers documentation
رؤية الحاسوب في Marigold
رؤية الحاسوب في Marigold
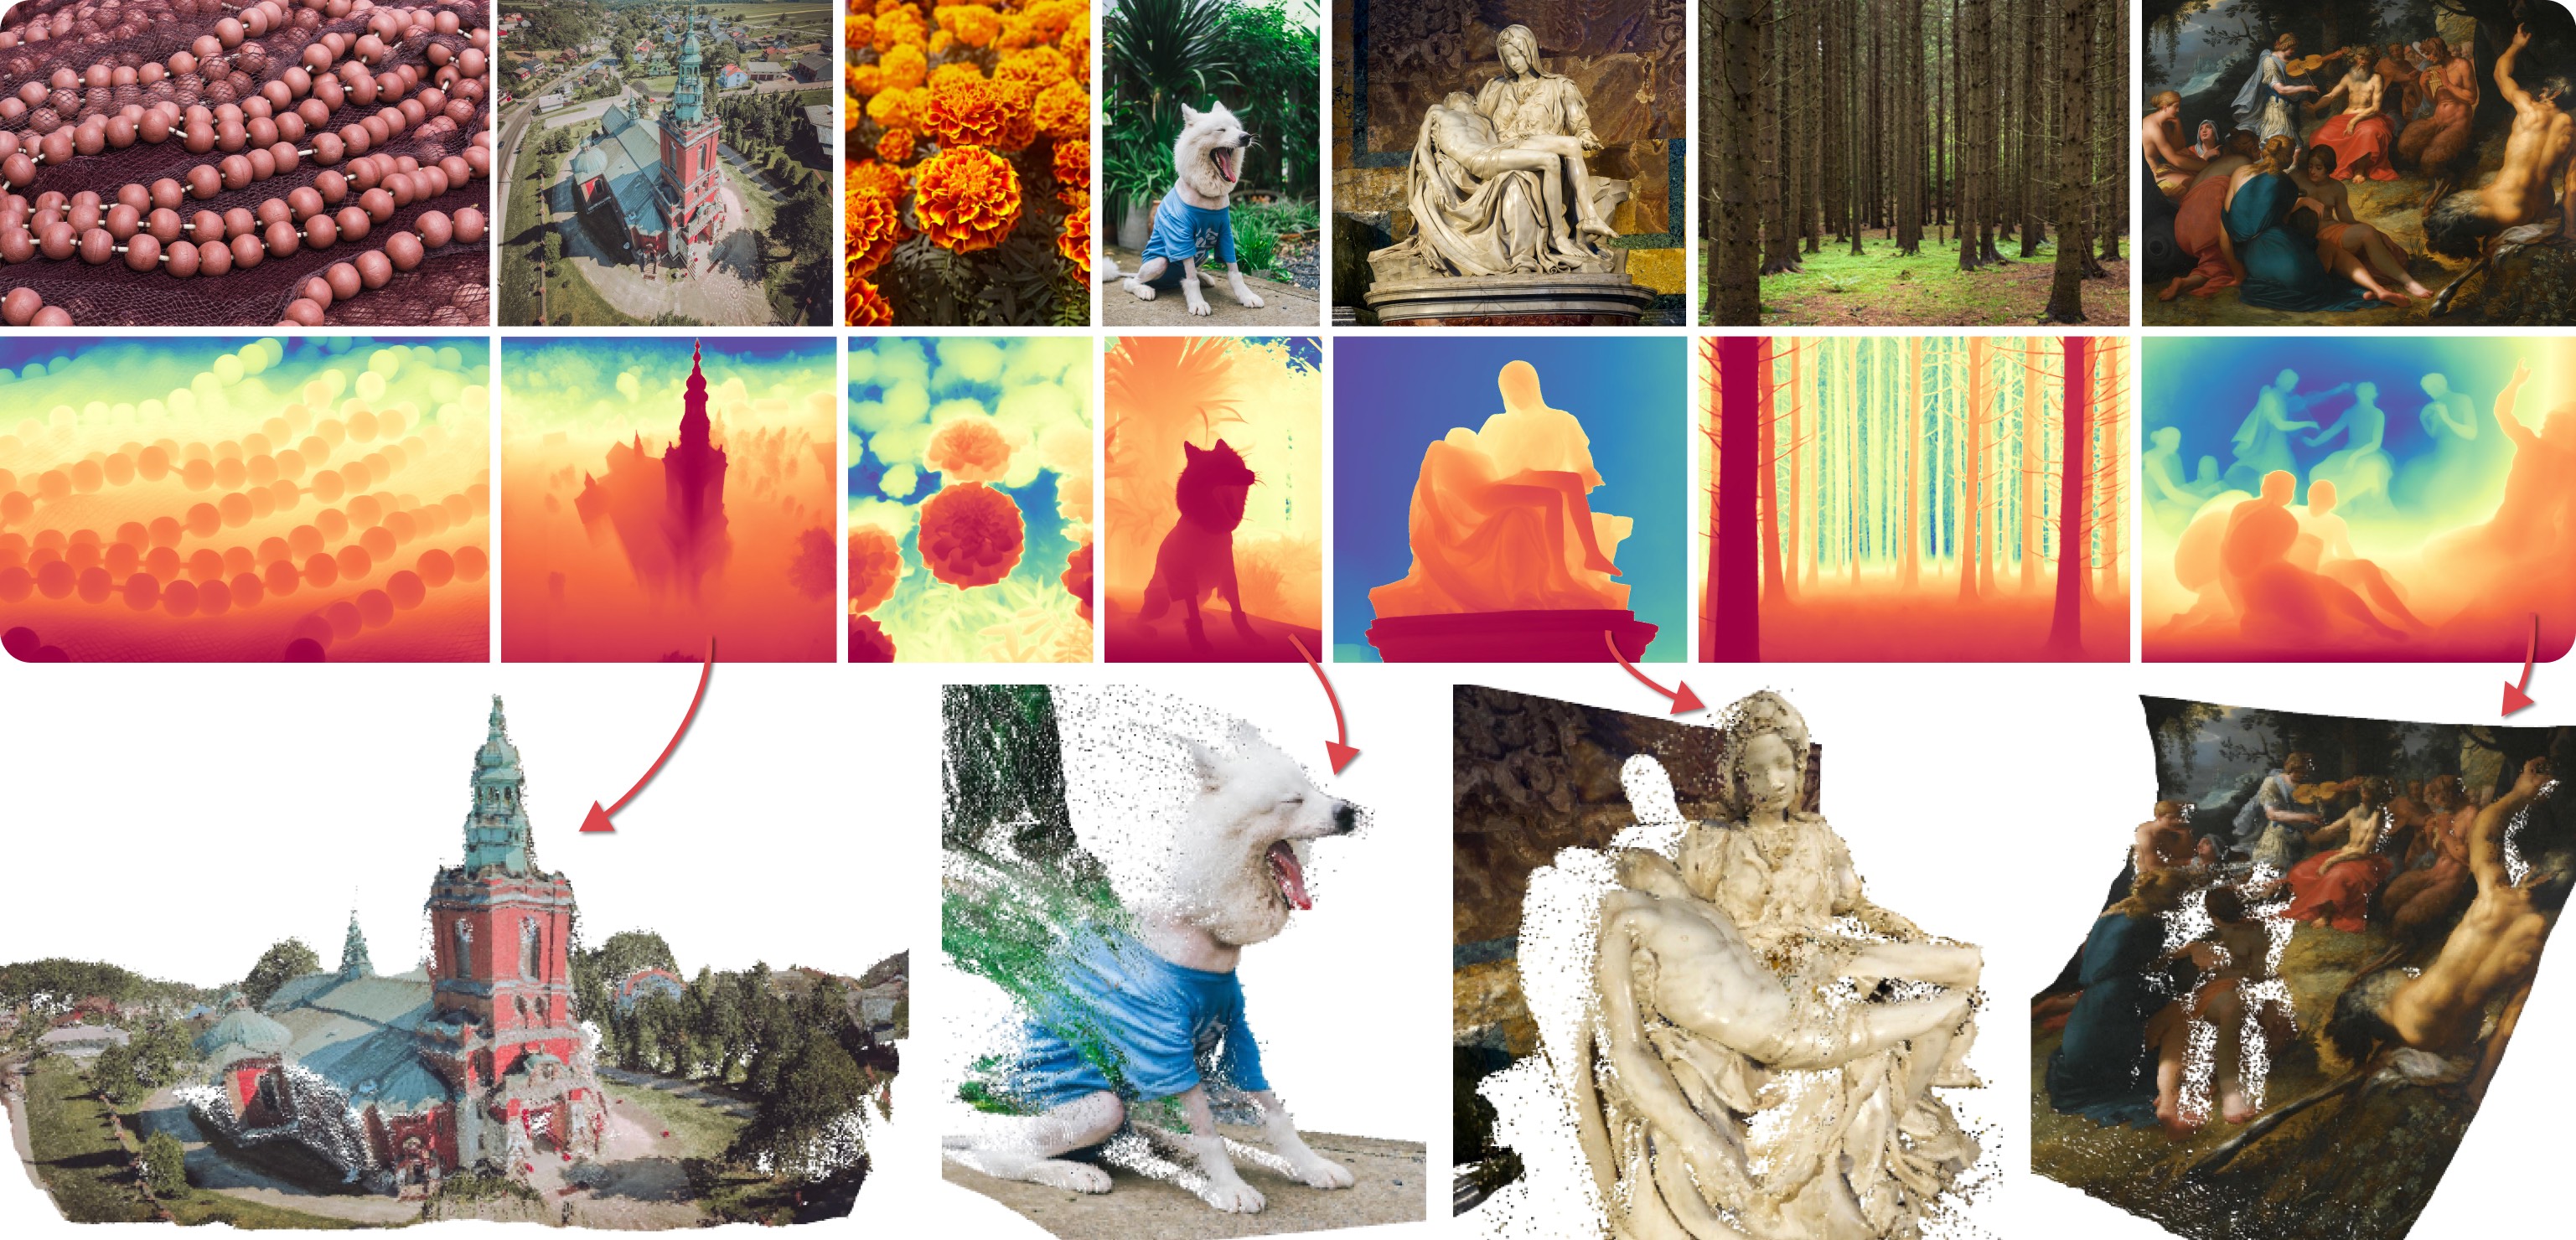
قُدمت Marigold في Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation، وهو ورقة فموية في مؤتمر CVPR 2024 من إعداد Bingxin Ke وAnton Obukhov وShengyu Huang وNando Metzger وRodrigo Caye Daudt وKonrad Schindler. الفكرة الجوهرية هي إعادة توظيف المسبق التوليدي لنماذج الانتشار الكامنة من النص إلى الصورة (LDMs) لمهام الرؤية الحاسوبية التقليدية. وقد استُكشفت هذه المنهجية من خلال ضبط دقيق لنموذج Stable Diffusion لمهمة Monocular Depth Estimation، كما هو موضح في الصورة التوضيحية أعلاه.
تم توسيع Marigold لاحقًا في الورقة اللاحقة Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis، والتي كتبها Bingxin Ke وKevin Qu وTianfu Wang وNando Metzger وShengyu Huang وBo Li وAnton Obukhov وKonrad Schindler. وسّع هذا العمل Marigold لدعم أنماط جديدة مثل Surface Normals وIntrinsic Image Decomposition (IID)، وقدم بروتوكول تدريب لـ Latent Consistency Models (LCM)، وأثبت قدرة المعالجة High-Resolution (HR).
تم تحسين النماذج المبكرة من Marigold (
v1-0وما قبلها) للحصول على أفضل النتائج مع 10 خطوات استدلال على الأقل. تم تطوير نماذج LCM لاحقًا لتمكين الاستدلال عالي الجودة في 1 إلى 4 خطوات فقط. تستخدم نماذج Marigoldv1-1وما بعدها مجدول DDIM لتحقيق نتائج مثالية في 1 إلى 4 خطوات فقط.
الخطوط الأنابيب المتاحة
كل خط أنابيب مصمّم لمهمة محددة في مجال الرؤية الحاسوبية، حيث يعالج صورة RGB مدخلة ويولّد تنبؤًا مطابقًا لها. حاليًا، تم تنفيذ مهام الرؤية الحاسوبية التالية:
| خط أنابيب | نقاط التفتيش الموصى بها للنماذج | المساحات (التطبيقات التفاعلية) | الأنماط المتوقعة |
|---|---|---|---|
| MarigoldDepthPipeline | prs-eth/marigold-depth-v1-1 | تقدير العمق | العمق، الفرق |
| MarigoldNormalsPipeline | prs-eth/marigold-normals-v1-1 | تقدير العواطف السطحية | المعادلات السطحية |
| MarigoldIntrinsicsPipeline | prs-eth/marigold-iid-appearance-v1-1، prs-eth/marigold-iid-lighting-v1-1 | التحليل الداخلي للصور | الانعكاسية، المواد، الإضاءة |
نقاط التفتيش المتاحة
جميع نقاط التفتيش الأصلية متاحة تحت منظمة PRS-ETH على Hugging Face. تم تصميمها للاستخدام مع خطوط أنابيب diffusers وقاعدة الكود الأصلية، والتي يمكن أيضًا استخدامها لتدريب نقاط تفتيش جديدة للنماذج. ما يلي هو ملخص لنقاط التفتيش الموصى بها، والتي تنتج جميعها نتائج موثوقة بخطوة إلى أربع خطوات.
| نقطة التفتيش | الوسيط | تعليق |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | العمق | يُسند التنبؤ بالعمق غير المعتمد على التحويلات الخطية (Affine-invariant) لكل بكسل قيمة بين 0 (السترة القريبة) و1 (السترة البعيدة)، حيث يحدد النموذج كلا من هاتين المستويين أثناء الاستدلال. |
| prs-eth/marigold-normals-v0-1 | المُتَّجَهات | تتكون تنبؤات العواطف السطحية من متجهات ثلاثية الأبعاد بطول وحدة في مساحة الكاميرا على الشاشة، بقيم تتراوح من -1 إلى 1. |
| prs-eth/marigold-iid-appearance-v1-1 | الخصائص الجوهرية | يتكون تفكيك InteriorVerse من خاصية Albedo وخاصيتين ماديتين BRDF: خاصية Roughness وخاصية Metallicity. |
| prs-eth/marigold-iid-lighting-v1-1 | الخصائص الجوهرية | تحليل HyperSim لصورة يتكون من ألبيدو $A$، والتظليل الانتشاري $S$، والباقي غير الانتشاري $R$: $I = A*S+R$. |
تأكد من الاطلاع على دليل المجدولين (Schedulers) لمعرفة كيفية استكشاف التوازن بين سرعة المجدول وجودة النتائج، واطلع على قسم إعادة استخدام المكونات عبر خطوط الأنابيب لمعرفة كيفية تحميل نفس المكونات بكفاءة في خطوط أنابيب متعددة. كما أن الاطلاع على قسم [“تقليل استهلاك الذاكرة”] هنا سيوفر لك مزيدًا من المعلومات حول تقليل استهلاك الذاكرة في خط الأنابيب هذا.
صُمِّمت خطوط أنابيب Marigold واختُبرت مع جدولة مدمجة في نقطة الفحص النموذجية. يختلف العدد الأمثل لخطوات الاستدلال حسب الجدولة، ولا توجد قيمة عالمية واحدة تكون الأفضل في جميع الحالات. لاستيعاب ذلك، فإن معامل
num_inference_stepsفي طريقة__call__الخاصة بخط الأنابيب يكون افتراضيًاNone(انظر مرجع الواجهة البرمجية). ما لم يُضبط صراحةً، فإنه يرث القيمة من حقلdefault_denoising_stepsفي ملف إعدادات نقطة الفحص (model_index.json). يضمن ذلك تنبؤات عالية الجودة عند استدعاء خط الأنابيب بحجةimageفقط.
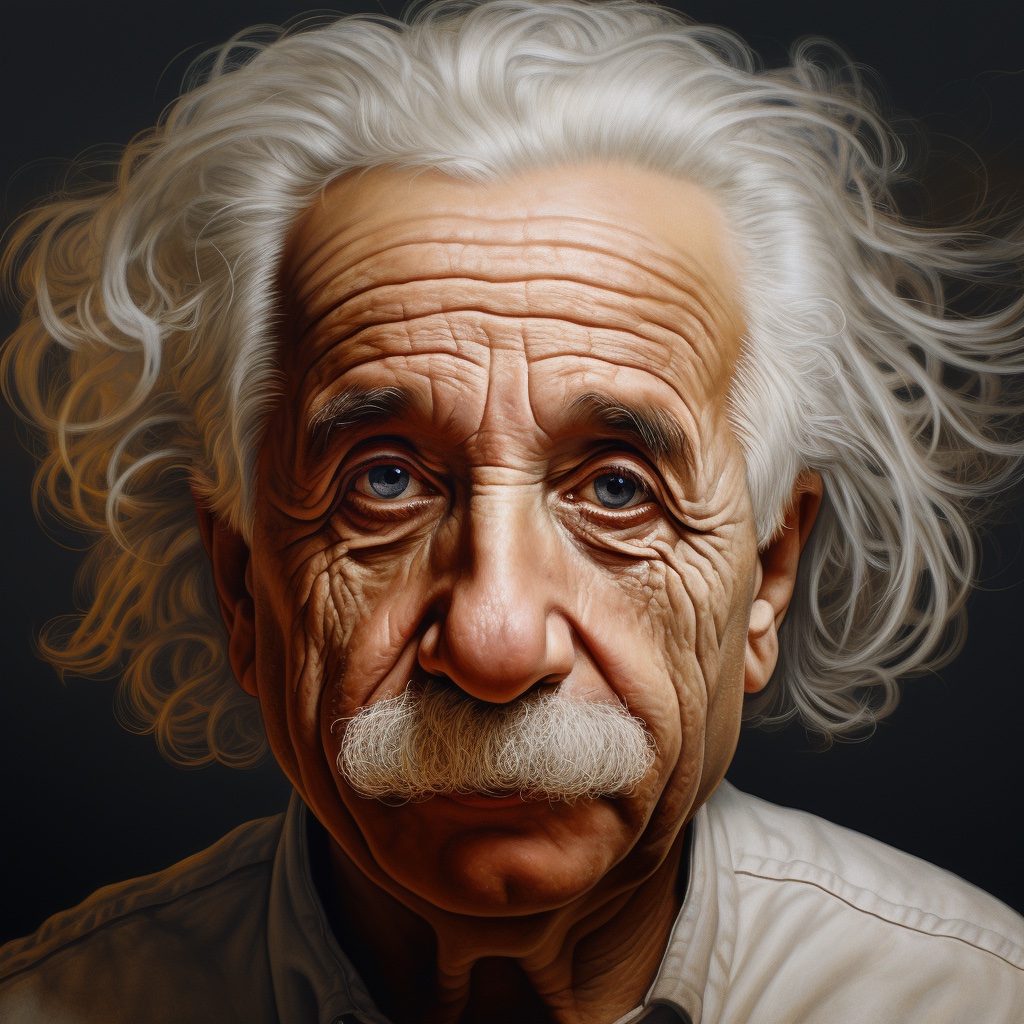
تُقدَّم الأمثلة أدناه بشكلٍ رئيسي للتنبؤ بالعمق، لكنها قابلة للتطبيق بشكلٍ عام على الأنماط المدعومة الأخرى. نعرض التنبؤات باستخدام صورة مدخلاتٍ واحدة لألبرت أينشتاين تم توليدها بواسطة Midjourney. يُسهّل ذلك مقارنة تصورات التنبؤات عبر الأنماط ونقاط التفتيش المختلفة.
توقع العمق
للحصول على تنبؤ بالعمق، حمّل نقطة التفتيش prs-eth/marigold-depth-v1-1 في MarigoldDepthPipeline،
مرّر الصورة عبر خط الأنابيب، واحفظ التنبؤات:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
تطبّق الدالة visualize_depth() أحد خرائط ألوان matplotlib (افتراضيًا Spectral) لربط قيم البكسلات المتنبأ بها من نطاق عمق أحادي القناة [0, 1] بصورة RGB.
مع خريطة الألوان Spectral، تُرسم البكسلات ذات العمق القريب باللون الأحمر، والبكسلات البعيدة باللون الأزرق.
تخزّن ملف PNG بدقة 16 بت قيم القناة الواحدة المُربوطة خطيًا من النطاق [0, 1] إلى [0, 65535].
فيما يلي التنبؤات الخام والتنبؤات المُصوَّرة. تكون المناطق الداكنة والأقرب (الشوارب) أسهل في التمييز في
التصوير.


تقدير العواطف السطحية
حمّل نقطة التفتيش prs-eth/marigold-normals-v1-1 في MarigoldNormalsPipeline، ومرّر الصورة عبر خط الأنابيب، واحفظ التنبؤات:
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
يُحوّل visualize_normals() التنبؤ ثلاثي الأبعاد ذي قيم البكسل في المدى [-1, 1] إلى صورة RGB.
تدعم دالة التصور عكس محاور العواطف السطحية لجعل التصور متوافقًا مع اختيارات أخرى لنظام الإحداثيات المرجعي.
مفاهيميًا، يُرسم كل بكسل وفقًا لمتجه العاطفة السطحية في نظام الإحداثيات المرجعي، حيث يشير محور X إلى اليمين، ومحور Y إلى الأعلى، ومحور Z إلى المشاهد.
فيما يلي التنبؤ المُصوَّر:

في هذا المثال، من شبه المؤكد أن طرف الأنف يحتوي على نقطة على السطح، يتجه فيها متجه العمودي على السطح مباشرةً نحو المشاهد، مما يعني أن إحداثياته هي [0, 0, 1].
يُخضع هذا المتجه إلى قيم RGB [128, 128, 255]، والتي تتوافق مع اللون البنفسجي الأزرق.
وبالمثل، فإن العمودي على السطح على الخد في الجزء الأيمن من الصورة يحتوي على مكوّن X كبير، مما يزيد من درجة اللون الأحمر.
أما النقاط على الكتفين الموجهة للأعلى مع مكوّن Y كبير فتعزز اللون الأخضر.
التحليل الجوهري للصورة
توفر Marigold نموذجين لتفكيك الصورة الجوهرية (IID): “Appearance” و “Lighting”. ينتج كل نموذج خرائط Albedo، مشتقة من تسميات InteriorVerse و Hypersim على التوالي.
- يقوم نموذج “Appearance” أيضاً بتقدير خصائص المادة: الخشونة والمعدنية.
- ينشئ نموذج “Lighting” كلًا من التظليل المنتشر (Diffuse Shading) والباقي غير المنتشر (Non-diffuse Residual).
فيما يلي رمز العينة الذي يحفظ التنبؤات التي أجراها نموذج “Appearance”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
مثال آخر يوضح التنبؤات التي يقدمها نموذج “Lighting”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
تشارك كلا النموذجين نفس خط المعالجة مع دعم أنواع تفكيك مختلفة.
يُخزَّن تمثيل معامل التفكيك الدقيق (مثل sRGB مقابل الفضاء الخطي) في قاموس pipe.target_properties، الذي يُمرَّر إلى دالة visualize_intrinsics().
فيما يلي بعض الأمثلة التي تُظهر مخرجات التفكيك المتوقعة. يمكن فحص جميع الأنماط في مساحة تفكيك الصورة الجوهرية.


تسريع الاستدلال
المقاطع السريعة المذكورة أعلاه مُحسَّنة بالفعل من حيث الجودة والسرعة، حيث تُحمِّل نقطة التفتيش (checkpoint)، وتستخدم متغير fp16 للأوزان والحسابات، وتنفذ العدد الافتراضي (4) من خطوات إزالة الضوضاء الانتشارية.
الخطوة الأولى لتسريع الاستدلال، على حساب جودة التنبؤ، هي تقليل خطوات إزالة الضوضاء الانتشارية إلى الحد الأدنى:
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)
مع هذا التغيير، يكتمل استدعاء pipe في 280 مللي ثانية على بطاقة RTX 3090.
داخليًا، يتم ترميز الصورة المدخلة أولًا باستخدام مُرمِّز VAE الخاص بـ Stable Diffusion، يليه خطوة إزالة ضوضاء واحدة يقوم بها U-Net.
أخيرًا، يتم فك ترميز الكامن للتنبؤ باستخدام مُفك ترميز VAE إلى فضاء البكسلات.
في هذا الإعداد، يُخصص اثنان من استدعاءات الوحدات الثلاثة لتحويل البيانات بين فضاء البكسلات وفضاء الكامن في LDM.
بما أن فضاء الكامن الخاص بـ Marigold متوافق مع Stable Diffusion 2.0، يمكن تسريع الاستدلال بأكثر من 3 أضعاف،
وتقليل زمن الاستدعاء إلى 85 مللي ثانية على RTX 3090، من خلال استخدام بديل خفيف لـ SD VAE.
يُرجى ملاحظة أن استخدام VAE خفيف قد يُقلل من الجودة البصرية للتنبؤات بشكل طفيف.
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
حتى الآن، قمنا بتحسين عدد خطوات الانتشار ومكونات النموذج. وتشكل عمليات الانتباه الذاتي (Self-attention) جزءًا كبيرًا من العمليات الحسابية. ويمكن تحقيق تسريعها من خلال استخدام معالج انتباه (attention processor) أكثر كفاءة:
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
أخيرًا، كما هو موصى به في التحسينات، يمكن لتفعيل torch.compile تعزيز الأداء بشكل أكبر اعتمادًا على العتاد المستهدف.
ومع ذلك، فإن التجميع يستلزم عبئًا كبيرًا أثناء أول استدعاء للخط الأنابيب، مما يجعله مفيدًا فقط عندما يُستدعى نفس مثيل الخط الأنابيب بشكل متكرر، مثل ما يحدث داخل حلقة.
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
تعظيم الدقة والتجميع
تتميز خطوط أنابيب Marigold بآلية تجميع مدمجة تجمع بين تنبؤات متعددة ناتجة عن كامنات عشوائية مختلفة.
يُعد هذا نهجًا قسريًا لتحسين دقة التنبؤات، بالاستفادة من الطبيعة التوليدية للانتشار.
تُفعَّل مسار التجميع تلقائيًا عند ضبط معامل ensemble_size بقيمة أكبر من أو تساوي 3.
عند السعي لتحقيق أقصى دقة، من المنطقي ضبط num_inference_steps بالتزامن مع ensemble_size.
تختلف القيم الموصى بها بين نقاط التفتيش، لكنها تعتمد بشكل أساسي على نوع المجدول.
يظهر تأثير التجميع بوضوح خاص عند التعامل مع الأطوال السطحية:
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 
كما هو واضح، أصبحت جميع المناطق ذات البنى الدقيقة، مثل الشعر، أكثر تحفظاً وأدق في التنبؤات بشكل متوسط. هذا النوع من النتائج أكثر ملاءمة للمهام اللاحقة الحساسة للدقة، مثل إعادة البناء ثلاثية الأبعاد.
معالجة الفيديو إطارًا بإطار مع الاتساق الزمني
نظرًا للطبيعة التوليدية لـ Marigold، فإن كل تنبؤ فريد ومُعرَّف بالضوضاء العشوائية المُستخرجة لتهيئة الحالة الكامنة. يُصبح هذا عيبًا واضحًا مقارنةً بشبكات الانحدار الكثيف التقليدية من الطرف إلى الطرف، كما هو مُوضح في مقاطع الفيديو التالية:


لمعالجة هذه المشكلة، يمكن تمرير معامل latents إلى خطوط الأنابيب، والذي يحدد نقطة بداية الانتشار.
عملياً، وجدنا أن الجمع المحدب بين ضجيج الكامن لنقطة البداية نفسها والكامن المقابل لتوقع الإطار السابق يعطي نتائج سلسة بما يكفي، كما هو مُنفَّذ في المقطع أدناه:
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
هنا، تبدأ عملية الانتشار من الكامن المُحسَب المُعطى.
يُعيّن خط الأنابيب output_latent=True للوصول إلى out.latent ويحسب مساهمته في تهيئة الكامن للإطار التالي.
أصبح الناتج أكثر استقراراً بكثير الآن:

Marigold لـ ControlNet
تُعدّ التنبؤ بالعمق باستخدام نماذج الانتشار تطبيقاً شائعاً جداً عند اقترانه مع ControlNet. يلعب وضوح العمق دوراً حاسماً في الحصول على نتائج عالية الجودة من ControlNet. كما هو موضح في المقارنات مع الأساليب الأخرى أعلاه، يتفوق Marigold في أداء هذه المهمة. يُبيّن المقطع البرمجي أدناه كيفية تحميل صورة، وحساب العمق، وتوريده إلى ControlNet بتنسيق متوافق:
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")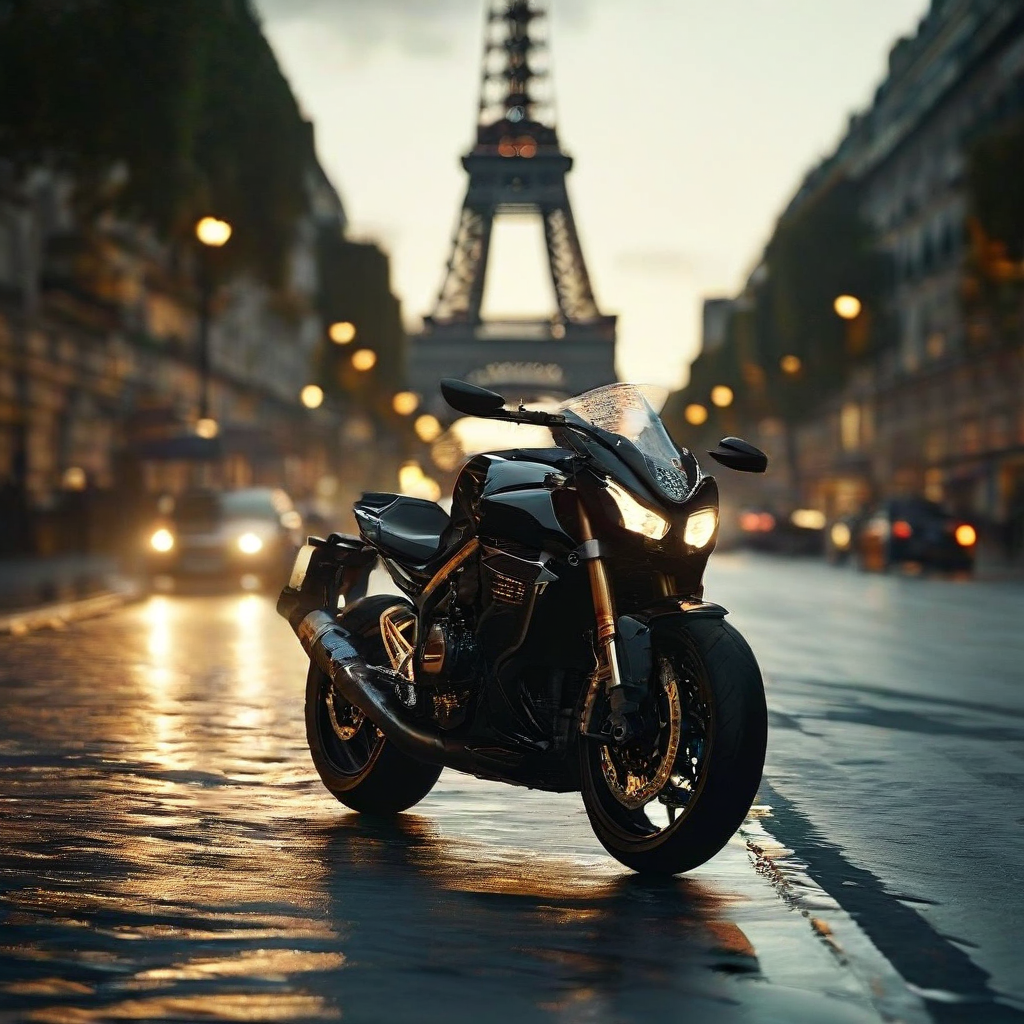


التقييم الكمي
لتقييم Marigold كمياً في لوحات المتصدرين والمعايير القياسية (مثل NYU وKITTI ومجموعات بيانات أخرى)،
اتبع بروتوكول التقييم الموضح في الورقة: حمّل النموذج بدقة كاملة fp32 واستخدم القيم المناسبة
لـ num_inference_steps وensemble_size.
اختياريًا، ثبّت البذرة العشوائية لضمان قابلية التكرار.
سيؤدي تعظيم batch_size إلى تحقيق أقصى استغلال للجهاز.
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
استخدام عدم اليقين التنبؤي
تجمع آلية التجميع (Ensembling) المدمجة في خطوط أنابيب Marigold بين تنبؤات متعددة مستمدة من كامنات عشوائية مختلفة.
كأثر جانبي، يمكن استخدام هذه الآلية لقياس عدم اليقين الإبستمولوجي (الناتج عن النموذج)؛ ما عليك سوى تحديد ensemble_size بقيمة أكبر من 3 أو تساويها، وإعداد output_uncertainty=True.
سيكون عدم اليقين الناتج متوفراً في حقل uncertainty من المخرجات.
ويمكن تصور ذلك على النحو التالي:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")


تفسير عدم اليقين سهل: فالقيم الأعلى (الأبيض) تتوافق مع البكسلات التي يجد فيها النموذج صعوبة في تقديم تنبؤات متسقة.
- يُظهر نموذج العمق أكبر قدر من عدم اليقين حول نقاط التوقف، حيث يتغير عمق الكائنات بشكل مفاجئ.
- يكون نموذج الاتجاهات السطحية أقل ثقة في البنى الدقيقة مثل الشعر وفي المناطق الداكنة مثل منطقة الياقة.
- يُمثَّل عدم اليقين في الانعكاسية (Albedo) كصورة RGB، إذ يلتقط عدم اليقين بشكل مستقل لكل قناة ألوان، على عكس العمط وطبقات السطح. كما يكون أعلى في المناطق المظللة وعند نقاط عدم الاستمرارية.
واجهة برمجة التطبيقات للتنبؤ بالعمق في Marigold
فئة diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
المعاملات
- unet (
UNet2DConditionModel) — شبكة U-Net شرطية لإزالة الضوضاء من الكامن العمقي، مشروطة بالكامن الصوري. - vae (
AutoencoderKL) — نموذج الترميز التبايني التلقائي (VAE) لتشفير وفك تشفير الصور والتنبؤات إلى تمثيلات كامنة ومنها. - scheduler (
DDIMSchedulerأوLCMScheduler) — جدولة تُستخدم بالاقتران معunetلإزالة الضوضاء من كائنات الصورة المُرمّزة. - text_encoder (
CLIPTextModel) — مُشفِّر النص، لتضمين النص الفارغ. - tokenizer (
CLIPTokenizer) — مقسّم نصوص CLIP. - prediction_type (
str، اختياري) — نوع التنبؤات التي يقوم بها النموذج. - scale_invariant (
bool، اختياري) — خاصية في النموذج تحدد ما إذا كانت خرائط العمق المتوقعة غير حساسة للتغيير في المقياس (scale-invariant). يجب تعيين هذه القيمة في إعدادات النموذج. عند استخدامها مع العلمshift_invariant=True، يُطلق على النموذج أيضًا اسم “غير حساس للتحويلات الأفينية” (affine-invariant). ملاحظة: لا يُدعم تجاوز هذه القيمة. - shift_invariant (
bool، اختياري) — خاصية في النموذج تحدد ما إذا كانت خرائط العمق المتوقعة غير متغيرة بالنسبة للإزاحة. يجب تعيين هذه القيمة في إعدادات النموذج. عند استخدامها مع العلمscale_invariant=True، يُطلق على النموذج أيضًا اسم “غير متغير بالنسبة للتحويلات الأفينية”. ملاحظة: لا يُدعم تجاوز هذه القيمة. - default_denoising_steps (
int، اختياري) — الحد الأدنى لعدد خطوات الانتشار لإزالة الضوضاء المطلوبة لإنتاج تنبؤ بجودة معقولة باستخدام النموذج المعطى. يجب تعيين هذه القيمة في إعدادات النموذج. عند استدعاء خط الأنابيب دون تعيينnum_inference_stepsبشكل صريح، يتم استخدام القيمة الافتراضية. وهذا ضروري لضمان نتائج معقولة مع مختلف النسخ المتوافقة مع خط الأنابيب، مثل تلك التي تعتمد على جداول إزالة ضوضاء قصيرة جداً (LCMScheduler) وتلك التي لديها جداول انتشار كاملة (DDIMScheduler). - default_processing_resolution (
int، اختياري) — القيمة الموصى بها لمعاملprocessing_resolutionفي خط المعالجة. يجب تعيين هذه القيمة في إعدادات النموذج. عند استدعاء خط المعالجة دون تعيينprocessing_resolutionبشكل صريح، تُستخدم القيمة الافتراضية. وهذا ضروري لضمان نتائج معقولة مع مختلف أنواع النماذج المدربة بقيم معالجة مثالية متباينة.
خط أنابيب لتقدير العمق أحادي العين باستخدام طريقة Marigold: https://marigoldmonodepth.github.io.
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
المعاملات
- image (
PIL.Image.Image،np.ndarray،torch.Tensor،list[PIL.Image.Image]،list[np.ndarray])، —list[torch.Tensor]: صورة أو صور مدخلة تُستخدم كمدخلات لمهمة تقدير العمق. بالنسبة للمصفوفات والتينسورات، النطاق المتوقع للقيم هو بين[0, 1]. يمكن تمرير دفعة من الصور من خلال تقديم مصفوفة رباعية الأبعاد أو تينسور. بالإضافة إلى ذلك، يمكن تمرير قائمة من الصور تكون مصفوفات أو تينسورات ثنائية أو ثلاثية الأبعاد. في الحالة الأخيرة، يجب أن تكون جميع عناصر القائمة ذات نفس العرض والارتفاع. - num_inference_steps (
int، اختياري، القيمة الافتراضيةNone) — عدد خطوات الانتشار لإزالة الضوضاء أثناء الاستدلال. تؤدي القيمة الافتراضيةNoneإلى الاختيار التلقائي. - ensemble_size (
int، القيمة الافتراضية1) — عدد تنبؤات المجموعة. تؤدي القيم الأعلى إلى تحسينات قابلة للقياس وتدهور بصري. - processing_resolution (
int، اختياري، القيمة الافتراضيةNone) — دقة المعالجة الفعلية. عند ضبطها على0، تتطابق مع بُعد الصورة المدخلة الأكبر. يؤدي هذا إلى تنبؤات أكثر وضوحًا، لكنه قد يؤدي أيضًا إلى فقدان السياق العام بشكل عام. تحل القيمة الافتراضيةNoneإلى القيمة المثلى من إعدادات النموذج. - match_input_resolution (
bool، اختياري، القيمة الافتراضيةTrue) — عند التفعيل، يتم تغيير حجم التنبؤ الناتج ليتطابق مع أبعاد الإدخال. عند التعطيل، ستكون الطول الأكبر للجهة الناتجة مساوياً لـprocessing_resolution. - resample_method_input (
str، اختياري، القيمة الافتراضية"bilinear") — طريقة إعادة العينة المستخدمة لتغيير حجم الصور المدخلة إلىprocessing_resolution. القيم المقبولة هي:"nearest"،"nearest-exact"،"bilinear"،"bicubic"، أو"area". - resample_method_output (
str، اختياري، القيمة الافتراضية"bilinear") — طريقة إعادة العينة المستخدمة لتغيير حجم تنبؤات المخرجات لتطابق دقة الإدخال. القيم المقبولة هي"nearest"،"nearest-exact"،"bilinear"،"bicubic"، أو"area". - batch_size (
int، اختياري، القيمة الافتراضية1) — حجم الدفعة؛ لا يهم إلا عند ضبطensemble_sizeأو تمرير مصفوفة من الصور. - ensembling_kwargs (
dict, اختياري, الافتراضي هوNone) — قاموس إضافي يحتوي على حُجج للتحكم الدقيق في التجميع. الخيارات المتاحة هي:- reduction (
str، اختياري، الافتراضي"median"): يحدد دالة التجميع (ensembling) المطبقة في كل موقع بكسل، ويمكن أن تكون إما"median"أو"mean". - regularizer_strength (
float, اختياري، القيمة الافتراضية0.02): قوة المُنظِّم الذي يسحب التنبؤات المُحاذاة إلى المدى الموحّد من 0 إلى 1. - max_iter (
int, اختياري, القيمة الافتراضية2): الحد الأقصى لعدد خطوات محلّص المحاذاة. راجع دالةscipy.optimize.minimize، معاملoptions. - tol (
float, اختياري، القيمة الافتراضية1e-3): حدّ سماحية محلّف المحاذاة. يتوقف المحلّل عند بلوغ حدّ السماحية. - max_res (
int، اختياري، القيمة الافتراضيةNone): الدقة التي يتم بها إجراء المحاذاة؛Noneيطابقprocessing_resolution.
- reduction (
- latents (
torch.Tensor، أوlist[torch.Tensor]، اختياري، القيمة الافتراضيةNone) — مصفوفات الضوضاء الكامنة لاستبدال التهيئة العشوائية. يمكن أخذ هذه المصفوفات من مخرجات استدعاء الدالة السابق. - generator (
torch.Generator، أوlist[torch.Generator]، اختياري، القيمة الافتراضيةNone) — كائن مولّد الأرقام العشوائية لضمان قابلية إعادة الإنتاج. - output_type (
str، اختياري، القيمة الافتراضية"np") — الصيغة المفضلة لحقلpredictionفي المخرجات والحقل الاختياريuncertainty. القيم المقبولة هي:"np"(مصفوفة numpy) أو"pt"(موتر torch). - output_uncertainty (
bool، اختياري، القيمة الافتراضيةFalse) — عند التفعيل، يحتوي حقلuncertaintyفي المخرجات على خريطة عدم اليقين التنبؤي، شريطة أن تكون قيمة الحجةensemble_sizeمضبوطة على قيمة أعلى من 2. - output_latent (
bool، اختياري، القيمة الافتراضيةFalse) — عند التفعيل، يحتوي حقلlatentفي المخرجات على الرموز الكامنة المقابلة للتنبؤات ضمن المجموعة. يمكن حفظ هذه الرموز وتعديلها واستخدامها في الاستدعاءات اللاحقة مع الحجةlatents. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع MarigoldDepthOutput بدلاً من tuple عادي.
يعيد
MarigoldDepthOutput أو tuple
إذا كان return_dict هو True، يُعاد MarigoldDepthOutput، وإلا يُعاد tuple حيث العنصر الأول هو التنبؤ، والعنصر الثاني هو عدم اليقين (أو None)، والثالث هو الكمون (أو None).
الدالة التي يتم استدعاؤها عند استدعاء خط الأنابيب.
أمثلة:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
فئة diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
المعاملات
- prediction (
np.ndarray,torch.Tensor) — خرائط العمق المتوقعة بقيم ضمن المدى [0, 1]. الشكل هوnumimages × 1 × height × widthلـtorch.Tensorأوnumimages × height × width × 1لـnp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — خرائط عدم اليقين المحسوبة من المجموعة، بقيم ضمن المدى [0, 1]. الشكل هوnumimages × 1 × height × widthلـtorch.Tensorأوnumimages × height × width × 1لـnp.ndarray. - latent (
None,torch.Tensor) — الميزات الكامنة المقابلة للتنبؤات، متوافقة مع معاملlatentsفي خط الأنابيب. الشكل هوnumimages * numensemble × 4 × latentheight × latentwidth.
فئة الإخراج لخط أنابيب Marigold للتنبؤ بالعمق أحادي العين.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
المعاملات
- depth (
PIL.Image.Image | np.ndarray | torch.Tensor | list[PIL.Image.Image, list[np.ndarray], -- list[torch.Tensor]]): خرائط العمق. - val_min (
float، اختياري، القيمة الافتراضية0.0) — القيمة الدنيا لنطاق العمق المُصوَّر. - val_max (
float، اختياري، القيمة الافتراضية1.0) — القيمة القصوى لنطاق العمق المُصوَّر. - color_map (
str، اختياري، الافتراضي"Spectral") — خريطة الألوان المستخدمة لتحويل التنبؤ العميق أحادي القناة إلى تمثيل ملوّن.
يُظهر خرائط العمق، مثل تنبؤات خط أنابيب MarigoldDepthPipeline.
يعيد: list[PIL.Image.Image] تحتوي على تصور لخرائط العمق.
واجهة برمجة التطبيقات لتقدير الاتجاهات في Marigold
فئة diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
المعاملات
- unet (
UNet2DConditionModel) — شبكة U-Net شرطية لإزالة الضوضاء من الكمونيات (latents) الخاصة بالمتجهات العمودية (normals)، مشروطة بالكمونيات (latents) الخاصة بالصورة. - vae (
AutoencoderKL) — نموذج الترميز التبايني التلقائي (VAE) لتشفير وفك تشفير الصور والتنبؤات إلى تمثيلات كامنة ومنها. - scheduler (
DDIMSchedulerأوLCMScheduler) — جدولة تُستخدم بالاقتران معunetلإزالة الضوضاء من كائنات الصورة المُرمّزة. - text_encoder (
CLIPTextModel) — مُشفِّر النص، لتضمين النص الفارغ. - tokenizer (
CLIPTokenizer) — مقسّم نصوص CLIP. - prediction_type (
str، اختياري) — نوع التنبؤات التي يقوم بها النموذج. - use_full_z_range (
bool, اختياري) — ما إذا كانت المتجهات العمودية (normals) التي يتنبأ بها هذا النموذج تستخدم النطاق الكامل لبُعد Z، أم نصفه الموجب فقط. - default_denoising_steps (
int، اختياري) — الحد الأدنى لعدد خطوات الانتشار لإزالة الضوضاء المطلوبة لإنتاج تنبؤ بجودة معقولة باستخدام النموذج المعطى. يجب تعيين هذه القيمة في إعدادات النموذج. عند استدعاء خط الأنابيب دون تعيينnum_inference_stepsبشكل صريح، يتم استخدام القيمة الافتراضية. وهذا ضروري لضمان نتائج معقولة مع مختلف النسخ المتوافقة مع خط الأنابيب، مثل تلك التي تعتمد على جداول إزالة ضوضاء قصيرة جداً (LCMScheduler) وتلك التي لديها جداول انتشار كاملة (DDIMScheduler). - default_processing_resolution (
int، اختياري) — القيمة الموصى بها لمعاملprocessing_resolutionفي خط المعالجة. يجب تعيين هذه القيمة في إعدادات النموذج. عند استدعاء خط المعالجة دون تعيينprocessing_resolutionبشكل صريح، تُستخدم القيمة الافتراضية. وهذا ضروري لضمان نتائج معقولة مع مختلف أنواع النماذج المدربة بقيم معالجة مثالية متباينة.
خط أنابيب لتقدير العواطف الأحادية باستخدام طريقة Marigold: https://marigoldmonodepth.github.io.
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
المعاملات
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]), —list[torch.Tensor]: صورة أو صور مدخلة تُستخدم كمدخلات لمهمة تقدير العواطف. بالنسبة للمصفوفات والتينسورات، النطاق المتوقع للقيم هو بين[0, 1]. يمكن تمرير دفعة من الصور من خلال تقديم مصفوفة رباعية الأبعاد أو تينسور. بالإضافة إلى ذلك، يمكن تمرير قائمة من الصور تكون مصفوفات أو تينسورات ثنائية أو ثلاثية الأبعاد. في الحالة الأخيرة، يجب أن تكون جميع عناصر القائمة ذات نفس العرض والارتفاع. - num_inference_steps (
int، اختياري، القيمة الافتراضيةNone) — عدد خطوات الانتشار لإزالة الضوضاء أثناء الاستدلال. تؤدي القيمة الافتراضيةNoneإلى الاختيار التلقائي. - ensemble_size (
int، القيمة الافتراضية1) — عدد تنبؤات المجموعة. تؤدي القيم الأعلى إلى تحسينات قابلة للقياس وتدهور بصري. - processing_resolution (
int، اختياري، القيمة الافتراضيةNone) — دقة المعالجة الفعلية. عند ضبطها على0، تتطابق مع بُعد الصورة المدخلة الأكبر. يؤدي هذا إلى تنبؤات أكثر وضوحًا، لكنه قد يؤدي أيضًا إلى فقدان السياق العام بشكل عام. تحل القيمة الافتراضيةNoneإلى القيمة المثلى من إعدادات النموذج. - match_input_resolution (
bool، اختياري، القيمة الافتراضيةTrue) — عند التفعيل، يتم تغيير حجم التنبؤ الناتج ليتطابق مع أبعاد الإدخال. عند التعطيل، ستكون الطول الأكبر للجهة الناتجة مساوياً لـprocessing_resolution. - resample_method_input (
str، اختياري، القيمة الافتراضية"bilinear") — طريقة إعادة العينة المستخدمة لتغيير حجم الصور المدخلة إلىprocessing_resolution. القيم المقبولة هي:"nearest"،"nearest-exact"،"bilinear"،"bicubic"، أو"area". - resample_method_output (
str، اختياري، القيمة الافتراضية"bilinear") — طريقة إعادة العينة المستخدمة لتغيير حجم تنبؤات المخرجات لتطابق دقة الإدخال. القيم المقبولة هي"nearest"،"nearest-exact"،"bilinear"،"bicubic"، أو"area". - batch_size (
int، اختياري، القيمة الافتراضية1) — حجم الدفعة؛ لا يهم إلا عند ضبطensemble_sizeأو تمرير مصفوفة من الصور. - ensembling_kwargs (
dict, اختياري, الافتراضي هوNone) — قاموس إضافي يحتوي على حُجج للتحكم الدقيق في التجميع. الخيارات المتاحة هي:- reduction (
str، اختياري، القيمة الافتراضية"closest"): يحدد دالة التجميع (ensembling) المطبقة في كل موقع بكسل، ويمكن أن تكون إما"closest"أو"mean".
- reduction (
- latents (
torch.Tensor، اختياري، القيمة الافتراضيةNone) — مصفوفات الضوضاء الكامنة لاستبدال التهيئة العشوائية. يمكن أخذ هذه المصفوفات من مخرجات استدعاء الدالة السابق. - generator (
torch.Generator، أوlist[torch.Generator]، اختياري، القيمة الافتراضيةNone) — كائن مولّد الأرقام العشوائية لضمان قابلية إعادة الإنتاج. - output_type (
str، اختياري، القيمة الافتراضية"np") — الصيغة المفضلة لحقلpredictionفي المخرجات والحقل الاختياريuncertainty. القيم المقبولة هي:"np"(مصفوفة numpy) أو"pt"(موتر torch). - output_uncertainty (
bool، اختياري، القيمة الافتراضيةFalse) — عند التفعيل، يحتوي حقلuncertaintyفي المخرجات على خريطة عدم اليقين التنبؤي، شريطة أن تكون قيمة الحجةensemble_sizeمضبوطة على قيمة أعلى من 2. - output_latent (
bool، اختياري، القيمة الافتراضيةFalse) — عند التفعيل، يحتوي حقلlatentفي المخرجات على الرموز الكامنة المقابلة للتنبؤات ضمن المجموعة. يمكن حفظ هذه الرموز وتعديلها واستخدامها في الاستدعاءات اللاحقة مع الحجةlatents. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع MarigoldNormalsOutput بدلاً من tuple عادي.
يعيد
MarigoldNormalsOutput أو tuple
إذا كان return_dict هو True، يُعاد MarigoldNormalsOutput، وإلا يُعاد tuple حيث العنصر الأول هو التنبؤ، والعنصر الثاني هو عدم اليقين (أو None)، والثالث هو الكمون (أو None).
الدالة التي يتم استدعاؤها عند استدعاء خط الأنابيب.
أمثلة:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
فئة diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
المعاملات
- prediction (
np.ndarray,torch.Tensor) — القيم الطبيعية المتوقعة بقيم ضمن المدى [-1, 1]. يكون الشكلnumimages × 3 × height × widthفي حالةtorch.Tensorأوnumimages × height × width × 3في حالةnp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — خرائط عدم اليقين المحسوبة من المجموعة، بقيم ضمن المدى [0, 1]. الشكل هوnumimages × 1 × height × widthلـtorch.Tensorأوnumimages × height × width × 1لـnp.ndarray. - latent (
None,torch.Tensor) — الميزات الكامنة المقابلة للتنبؤات، متوافقة مع معاملlatentsفي خط الأنابيب. الشكل هوnumimages * numensemble × 4 × latentheight × latentwidth.
فئة الإخراج لخط أنابيب تنبؤ Marigold بالمتجهات العمودية أحادية العين.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
المعاملات
- normals (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — طبيعات السطح. - flip_x (
bool، اختياري، القيمة الافتراضيةFalse) — يقلب محور X في إطار إحداثيات العواطف. الاتجاه الافتراضي هو اليمين. - flip_y (
bool، اختياري، القيمة الافتراضيةFalse) — يقلب محور Y في إطار إحداثيات العواطف. الاتجاه الافتراضي هو الأعلى. - flip_z (
bool، اختياري، القيمة الافتراضيةFalse) — يقلب محور Z في إطار إحداثيات العواطف. الاتجاه الافتراضي هو الاتجاه نحو المشاهد.
يُظهر متجهات العمودية السطحية، مثل تنبؤات خط أنابيب MarigoldNormalsPipeline.
يعيد: list[PIL.Image.Image] مع تصور لطبقات السطوح.
واجهة برمجة التطبيقات الخاصة بتفكيك الصورة الجوهرية في Marigold
فئة diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
المعاملات
- unet (
UNet2DConditionModel) — شبكة U-Net شرطية لإزالة الضوضاء من الأهداف الكامنة، مشروطة بالكامنة الصورية. - vae (
AutoencoderKL) — نموذج الترميز التبايني التلقائي (VAE) لتشفير وفك تشفير الصور والتنبؤات إلى تمثيلات كامنة ومنها. - scheduler (
DDIMSchedulerأوLCMScheduler) — جدولة تُستخدم بالاقتران معunetلإزالة الضوضاء من كائنات الصورة المُرمّزة. - text_encoder (
CLIPTextModel) — مُشفِّر النص، لتضمين النص الفارغ. - tokenizer (
CLIPTokenizer) — مقسّم نصوص CLIP. - prediction_type (
str، اختياري) — نوع التنبؤات التي يقوم بها النموذج. - target_properties (
dict[str, Any], اختياري) — خصائص الأنماط المتوقعة، مثلtarget_names، وهوlist[str]يُستخدم لتحديد عدد الأنماط المتوقعة وترتيبها وأسمائها، وأي بيانات وصفية أخرى قد تكون مطلوبة لتفسير التوقعات. - default_denoising_steps (
int، اختياري) — الحد الأدنى لعدد خطوات الانتشار لإزالة الضوضاء المطلوبة لإنتاج تنبؤ بجودة معقولة باستخدام النموذج المعطى. يجب تعيين هذه القيمة في إعدادات النموذج. عند استدعاء خط الأنابيب دون تعيينnum_inference_stepsبشكل صريح، يتم استخدام القيمة الافتراضية. وهذا ضروري لضمان نتائج معقولة مع مختلف النسخ المتوافقة مع خط الأنابيب، مثل تلك التي تعتمد على جداول إزالة ضوضاء قصيرة جداً (LCMScheduler) وتلك التي لديها جداول انتشار كاملة (DDIMScheduler). - default_processing_resolution (
int، اختياري) — القيمة الموصى بها لمعاملprocessing_resolutionفي خط المعالجة. يجب تعيين هذه القيمة في إعدادات النموذج. عند استدعاء خط المعالجة دون تعيينprocessing_resolutionبشكل صريح، تُستخدم القيمة الافتراضية. وهذا ضروري لضمان نتائج معقولة مع مختلف أنواع النماذج المدربة بقيم معالجة مثالية متباينة.
خط أنابيب لتفكيك الصورة الجوهرية (IID) باستخدام طريقة Marigold: https://marigoldcomputervision.github.io.
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
المعاملات
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]), —list[torch.Tensor]: صورة أو صور مدخلة تُستخدم كمدخلات لمهمة التحليل الداخلي. بالنسبة للمصفوفات والتينسورات، النطاق المتوقع للقيم هو بين[0, 1]. من الممكن تمرير دفعة من الصور عن طريق تقديم مصفوفة أو تينسور رباعي الأبعاد. بالإضافة إلى ذلك، يمكن تمرير قائمة من الصور تكون مصفوفات أو تينسورات ثنائية أو ثلاثية الأبعاد. في الحالة الأخيرة، يجب أن تكون جميع عناصر القائمة ذات نفس العرض والارتفاع. - num_inference_steps (
int، اختياري، القيمة الافتراضيةNone) — عدد خطوات الانتشار لإزالة الضوضاء أثناء الاستدلال. تؤدي القيمة الافتراضيةNoneإلى الاختيار التلقائي. - ensemble_size (
int، القيمة الافتراضية1) — عدد تنبؤات المجموعة. تؤدي القيم الأعلى إلى تحسينات قابلة للقياس وتدهور بصري. - processing_resolution (
int، اختياري، القيمة الافتراضيةNone) — دقة المعالجة الفعلية. عند ضبطها على0، تتطابق مع بُعد الصورة المدخلة الأكبر. يؤدي هذا إلى تنبؤات أكثر وضوحًا، لكنه قد يؤدي أيضًا إلى فقدان السياق العام بشكل عام. تحل القيمة الافتراضيةNoneإلى القيمة المثلى من إعدادات النموذج. - match_input_resolution (
bool، اختياري، القيمة الافتراضيةTrue) — عند التفعيل، يتم تغيير حجم التنبؤ الناتج ليتطابق مع أبعاد الإدخال. عند التعطيل، ستكون الطول الأكبر للجهة الناتجة مساوياً لـprocessing_resolution. - resample_method_input (
str، اختياري، القيمة الافتراضية"bilinear") — طريقة إعادة العينة المستخدمة لتغيير حجم الصور المدخلة إلىprocessing_resolution. القيم المقبولة هي:"nearest"،"nearest-exact"،"bilinear"،"bicubic"، أو"area". - resample_method_output (
str، اختياري، القيمة الافتراضية"bilinear") — طريقة إعادة العينة المستخدمة لتغيير حجم تنبؤات المخرجات لتطابق دقة الإدخال. القيم المقبولة هي"nearest"،"nearest-exact"،"bilinear"،"bicubic"، أو"area". - batch_size (
int، اختياري، القيمة الافتراضية1) — حجم الدفعة؛ لا يهم إلا عند ضبطensemble_sizeأو تمرير مصفوفة من الصور. - ensembling_kwargs (
dict, اختياري, الافتراضي هوNone) — قاموس إضافي يحتوي على حُجج للتحكم الدقيق في التجميع. الخيارات المتاحة هي:- reduction (
str، اختياري، الافتراضي"median"): يحدد دالة التجميع (ensembling) المطبقة في كل موقع بكسل، ويمكن أن تكون إما"median"أو"mean".
- reduction (
- latents (
torch.Tensor، اختياري، القيمة الافتراضيةNone) — مصفوفات الضوضاء الكامنة لاستبدال التهيئة العشوائية. يمكن أخذ هذه المصفوفات من مخرجات استدعاء الدالة السابق. - generator (
torch.Generator، أوlist[torch.Generator]، اختياري، القيمة الافتراضيةNone) — كائن مولّد الأرقام العشوائية لضمان قابلية إعادة الإنتاج. - output_type (
str، اختياري، القيمة الافتراضية"np") — الصيغة المفضلة لحقلpredictionفي المخرجات والحقل الاختياريuncertainty. القيم المقبولة هي:"np"(مصفوفة numpy) أو"pt"(موتر torch). - output_uncertainty (
bool، اختياري، القيمة الافتراضيةFalse) — عند التفعيل، يحتوي حقلuncertaintyفي المخرجات على خريطة عدم اليقين التنبؤي، شريطة أن تكون قيمة الحجةensemble_sizeمضبوطة على قيمة أعلى من 2. - output_latent (
bool، اختياري، القيمة الافتراضيةFalse) — عند التفعيل، يحتوي حقلlatentفي المخرجات على الرموز الكامنة المقابلة للتنبؤات ضمن المجموعة. يمكن حفظ هذه الرموز وتعديلها واستخدامها في الاستدعاءات اللاحقة مع الحجةlatents. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع MarigoldIntrinsicsOutput بدلاً من tuple عادي.
يعيد
MarigoldIntrinsicsOutput أو tuple
إذا كان return_dict هو True، يُعاد MarigoldIntrinsicsOutput، وإلا يُعاد tuple حيث العنصر الأول هو التنبؤ، والعنصر الثاني هو عدم اليقين (أو None)، والثالث هو الكمون (أو None).
الدالة التي يتم استدعاؤها عند استدعاء خط الأنابيب.
أمثلة:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")فئة diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
المعاملات
- prediction (
np.ndarray,torch.Tensor) — الخصائص الداخلية للصورة المتوقعة بقيم ضمن المدى [0, 1]. الشكل هو(numimages * numtargets) × 3 × height × widthلـtorch.Tensorأو(numimages * numtargets) × height × width × 3لـnp.ndarray، حيثnumtargetsيتوافق مع عدد أنماط الهدف المتوقعة في التحليل إلى خصائص داخلية للصورة. - uncertainty (
None,np.ndarray,torch.Tensor) — خرائط عدم اليقين المحسوبة من المجموعة، بقيم ضمن المدى [0, 1]. الشكل هو(numimages * numtargets) × 3 × height × widthلـtorch.Tensorأو(numimages * numtargets) × height × width × 3لـnp.ndarray. - latent (
None,torch.Tensor) — الميزات الكامنة المقابلة للتنبؤات، متوافقة مع معاملlatentsفي خط الأنابيب. الشكل هو(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidth.
فئة الإخراج لخط أنابيب Marigold Intrinsic Image Decomposition.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dict[str, typing.Any]color_map: str | dict[str, str] = 'binary' )
المعاملات
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — تفكيك الصورة الجوهرية. - target_properties (
dict[str, Any]) — خصائص التفكيك. المدخلات المتوقعة:target_names: list[str]وقاموس بمفاتيحprediction_space: str،sub_target_names: list[str | Null](يجب أن يحتوي على 3 مدخلات، مع قيمة null للأنماط المفقودة)،up_to_scale: bool، واحد لكل هدف وفرع هدف. - color_map (
str | dict[str, str]، اختياري، القيمة الافتراضية"Spectral") — خريطة الألوان المستخدمة لتحويل التنبؤات أحادية القناة إلى تمثيلات ملونة. عند تمرير قاموس، يمكن تلوين كل نمط (modality) بخريطة ألوان خاصة به.
يُظهر تحليل الصورة الجوهري، مثل تنبؤات خط أنابيب MarigoldIntrinsicsPipeline.
يعيد: list[dict[str, PIL.Image.Image]] مع تصور لتفكيك الصورة الجوهرية.