
Diffusers documentation
Shap-E
Shap-E
Модель Shap-E была предложена в работе Shap-E: Generating Conditional 3D Implicit Functions Алексом Ничолом и Хиу Джунем из OpenAI.
Аннотация из статьи:
Мы представляем Shap-E — условную генеративную модель для 3D-ассетов. В отличие от недавних работ по 3D-генеративным моделям, которые формируют единственное выходное представление, Shap-E непосредственно генерирует параметры неявных функций, которые могут быть отрендерены как текстурированные меши, так и нейронные поля радиантности. Обучение Shap-E проходит в два этапа: сначала мы обучаем энкодер, который детерминированно отображает 3D-ассеты в параметры неявной функции; затем мы обучаем условную диффузионную модель на выходах энкодера. При обучении на большом наборе данных, содержащем пары 3D-ассетов и текстов, полученные модели способны генерировать сложные и разнообразные 3D-ассеты за считанные секунды. В сравнении с Point-E — явной генеративной моделью для облаков точек — Shap-E сходится быстрее и достигает сопоставимого или более высокого качества выборок, несмотря на то, что моделирует выходное пространство с более высокой размерностью и несколькими представлениями.
Исходная кодовая база доступна по адресу openai/shap-e.
См. раздел повторное использование компонентов в разных конвейерах, чтобы узнать, как эффективно загружать одни и те же компоненты в несколько конвейеров.
Убедитесь, что у вас установлены следующие библиотеки.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate trimesh
Текст в 3D
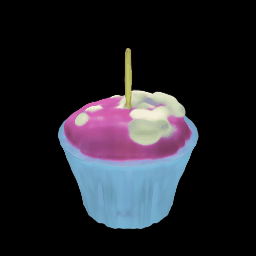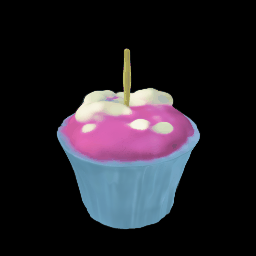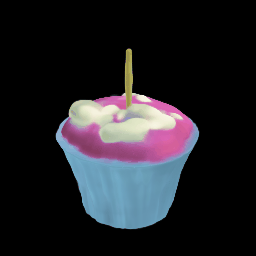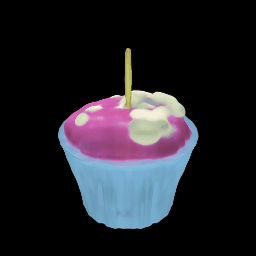
Чтобы создать gif-анимацию 3D-объекта, передайте текстовый промпт в ShapEPipeline. Пайплайн генерирует список кадров изображений, которые используются для создания 3D-объекта.
import torch
from diffusers import ShapEPipeline

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

pipe = ShapEPipeline.from_pretrained("openai/shap-e", dtype=torch.float16, variant="fp16")
pipe = pipe.to(device)

guidance_scale = 15.0
prompt = ["A firecracker", "A birthday cupcake"]

images = pipe(
    prompt,
    guidance_scale=guidance_scale,
    num_inference_steps=64,
    frame_size=256,
).images
Теперь используйте функцию export_to_gif(), чтобы преобразовать список кадров изображения в gif-файл 3D-объекта.
from diffusers.utils import export_to_gif

export_to_gif(images[0], "firecracker_3d.gif")
export_to_gif(images[1], "cake_3d.gif")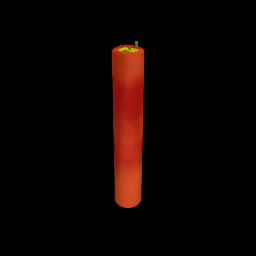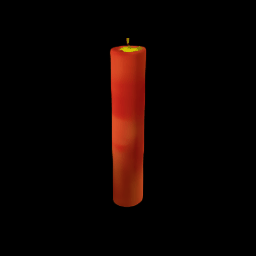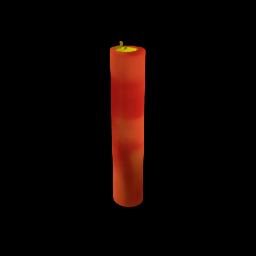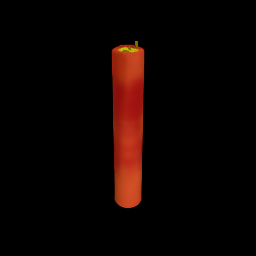
Изображение в 3D
Чтобы создать 3D-объект по другому изображению, используйте ShapEImg2ImgPipeline. Вы можете использовать существующее изображение или сгенерировать совершенно новое. Давайте сгенерируем новое изображение с помощью модели Kandinsky 2.1.
from diffusers import DiffusionPipeline
import torch

prior_pipeline = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")

prompt = "A cheeseburger, white background"

image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
image = pipeline(
    prompt,
    image_embeds=image_embeds,
    negative_image_embeds=negative_image_embeds,
).images[0]

image.save("burger.png")
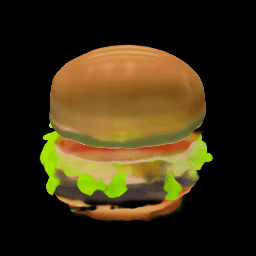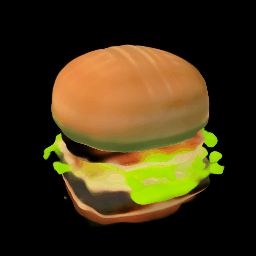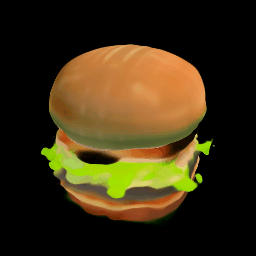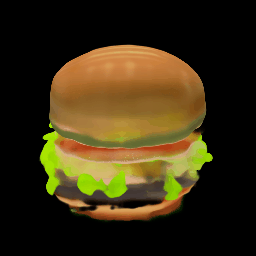
Передайте чизбургер в ShapEImg2ImgPipeline, чтобы сгенерировать его 3D-представление.
from PIL import Image
from diffusers import ShapEImg2ImgPipeline
from diffusers.utils import export_to_gif

pipe = ShapEImg2ImgPipeline.from_pretrained("openai/shap-e-img2img", dtype=torch.float16, variant="fp16").to("cuda")  # or "mps", "xpu", "cpu"

guidance_scale = 3.0
image = Image.open("burger.png").resize((256, 256))

images = pipe(
    image,
    guidance_scale=guidance_scale,
    num_inference_steps=64,
    frame_size=256,
).images

gif_path = export_to_gif(images[0], "burger_3d.gif")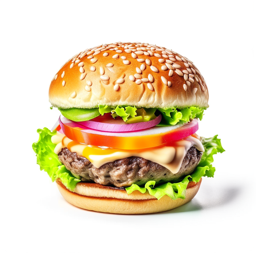
Создать сетку
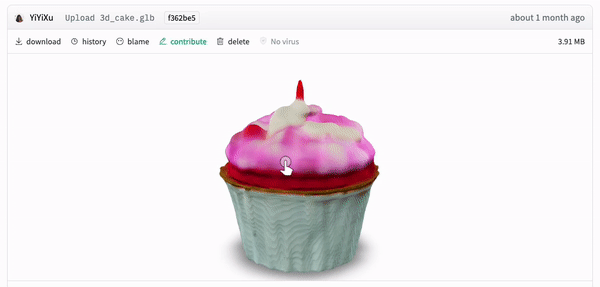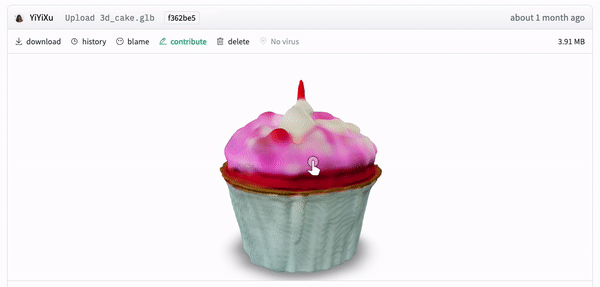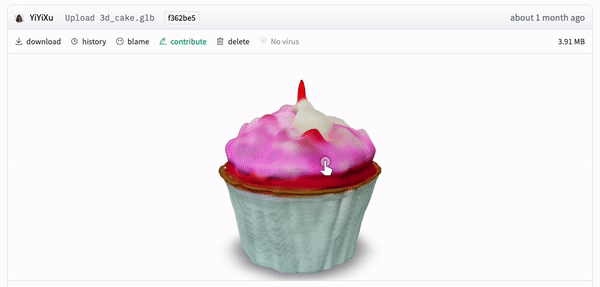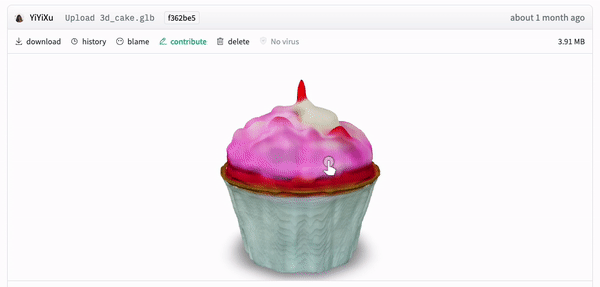
Shap-E — это гибкая модель, которая также может генерировать текстурированные сетки для рендеринга в прикладных задачах. В этом примере вы конвертируете результат в файл glb, так как библиотека 🤗 Datasets поддерживает визуализацию сеток из файлов glb, которые могут быть отрендерены в просмотрщике датасетов.
Вы можете генерировать выходные данные в формате сетки для ShapEPipeline и ShapEImg2ImgPipeline, указав параметр output_type со значением "mesh":
import torch
from diffusers import ShapEPipeline

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

pipe = ShapEPipeline.from_pretrained("openai/shap-e", dtype=torch.float16, variant="fp16")
pipe = pipe.to(device)

guidance_scale = 15.0
prompt = "A birthday cupcake"

images = pipe(prompt, guidance_scale=guidance_scale, num_inference_steps=64, frame_size=256, output_type="mesh").images
Используйте функцию export_to_ply(), чтобы сохранить вывод сетки в файл ply:
При необходимости можно сохранить вывод сетки в файл формата
objс помощью функцииexport_to_obj(). Возможность сохранять вывод сетки в различных форматах делает его более гибким для дальнейшего использования!
from diffusers.utils import export_to_ply

ply_path = export_to_ply(images[0], "3d_cake.ply")
print(f"Saved to folder: {ply_path}")
Затем вы можете преобразовать файл ply в файл glb с помощью библиотеки trimesh:
import trimesh

mesh = trimesh.load("3d_cake.ply")
mesh_export = mesh.export("3d_cake.glb", file_type="glb")
По умолчанию вывод сетки сфокусирован на нижнюю точку обзора, но вы можете изменить точку обзора по умолчанию, применив преобразование вращения:
import trimesh
import numpy as np

mesh = trimesh.load("3d_cake.ply")
rot = trimesh.transformations.rotation_matrix(-np.pi / 2, [1, 0, 0])
mesh = mesh.apply_transform(rot)
mesh_export = mesh.export("3d_cake.glb", file_type="glb")
Загрузите файл сетки в репозиторий датасета, чтобы визуализировать его с помощью Dataset viewer!
ShapEPipeline
класс diffusers.ShapEPipeline
< source >( prior: PriorTransformertext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: HeunDiscreteSchedulershap_e_renderer: ShapERenderer )
Параметры
- prior (PriorTransformer) — канонический prior unCLIP для приближения эмбеддинга изображения по эмбеддингу текста.
- text_encoder (CLIPTextModelWithProjection) — Замороженный текстовый энкодер.
- tokenizer (CLIPTokenizer) —
CLIPTokenizerдля токенизации текста. - scheduler (HeunDiscreteScheduler) —
планировщик, используемый в сочетании с моделью
priorдля генерации эмбеддинга изображения. - shap_e_renderer (
ShapERenderer) — рендерер Shap-E проецирует сгенерированные латенты в параметры MLP для создания 3D-объектов с использованием метода рендеринга NeRF.
Пайплайн для генерации латентного представления 3D-ассета и рендеринга с использованием метода NeRF.
Эта модель наследуется от DiffusionPipeline. Общую документацию по методам, реализованным для всех пайплайнов (загрузка, сохранение, запуск на конкретном устройстве и т. д.), см. в документации родительского класса.
__call__
< source >( prompt: strnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0frame_size: int = 64output_type: str | None = 'pil'return_dict: bool = True ) → ShapEPipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - num_inference_steps (
int, необязательный, по умолчанию 25) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счёт более медленного вывода. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) —torch.Generatorдля обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумленные латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Можно использовать, чтобы корректировать одну и ту же генерацию с разными промптами. Если не задано, тензор латентов генерируется путём выборки с использованием переданного случайногоgenerator. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Более высокое значение guidance scale побуждает модель генерировать изображения, тесно связанные с текстовымprompt, в ущерб качеству изображения. Guidance scale включается, когдаguidance_scale > 1. - frame_size (
int, необязательный, по умолчанию 64) — Ширина и высота каждого кадра изображения в генерируемом 3D-результате. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array),"latent"(torch.Tensor) или mesh (MeshDecoderOutput). - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ShapEPipelineOutput вместо обычного кортежа.
Возвращает
ShapEPipelineOutput или tuple
Если return_dict равно True, возвращается ShapEPipelineOutput,
в противном случае возвращается tuple, где первый элемент — это список с сгенерированными изображениями.
Функция вызова конвейера для генерации.
Примеры:
>>> import torch
>>> from diffusers import DiffusionPipeline
>>> from diffusers.utils import export_to_gif

>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

>>> repo = "openai/shap-e"
>>> pipe = DiffusionPipeline.from_pretrained(repo, torch_dtype=torch.float16)
>>> pipe = pipe.to(device)

>>> guidance_scale = 15.0
>>> prompt = "a shark"

>>> images = pipe(
...     prompt,
...     guidance_scale=guidance_scale,
...     num_inference_steps=64,
...     frame_size=256,
... ).images

>>> gif_path = export_to_gif(images[0], "shark_3d.gif")
ShapEImg2ImgPipeline
класс diffusers.ShapEImg2ImgPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelimage_processor: CLIPImageProcessorPilscheduler: HeunDiscreteSchedulershap_e_renderer: ShapERenderer )
Параметры
- prior (PriorTransformer) — канонический prior unCLIP для приближения эмбеддинга изображения по эмбеддингу текста.
- image_encoder (CLIPVisionModel) — Замороженный энкодер изображений.
- image_processor (CLIPImageProcessor) —
CLIPImageProcessorдля обработки изображений. - scheduler (HeunDiscreteScheduler) —
планировщик, используемый в сочетании с моделью
priorдля генерации эмбеддинга изображения. - shap_e_renderer (
ShapERenderer) — рендерер Shap-E проецирует сгенерированные латенты в параметры MLP для создания 3D-объектов с использованием метода рендеринга NeRF.
Пайплайн для генерации латентного представления 3D-объекта и рендеринга методом NeRF по изображению.
Эта модель наследуется от DiffusionPipeline. Общую документацию по методам, реализованным для всех пайплайнов (загрузка, сохранение, запуск на конкретном устройстве и т. д.), см. в документации родительского класса.
__call__
< source >( image: PIL.Image.Image | list[PIL.Image.Image]num_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0frame_size: int = 64output_type: str | None = 'pil'return_dict: bool = True ) → ShapEPipelineOutput or tuple
Параметры
- image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]илиlist[np.ndarray]) —Imageили тензор, представляющий пакет изображений, используемый в качестве начальной точки. Также можно передавать латенты изображений в качестве image, но при прямой передаче латентов они не кодируются повторно. - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - num_inference_steps (
int, необязательный, по умолчанию 25) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счёт более медленного вывода. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) —torch.Generatorдля обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумленные латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Можно использовать, чтобы корректировать одну и ту же генерацию с разными промптами. Если не задано, тензор латентов генерируется путём выборки с использованием переданного случайногоgenerator. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Более высокое значение guidance scale побуждает модель генерировать изображения, тесно связанные с текстовымprompt, в ущерб качеству изображения. Guidance scale включается, когдаguidance_scale > 1. - frame_size (
int, необязательный, по умолчанию 64) — Ширина и высота каждого кадра изображения в генерируемом 3D-результате. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array),"latent"(torch.Tensor) или mesh (MeshDecoderOutput). - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ShapEPipelineOutput вместо обычного кортежа.
Возвращает
ShapEPipelineOutput или tuple
Если return_dict равно True, возвращается ShapEPipelineOutput,
в противном случае возвращается tuple, где первый элемент — это список с сгенерированными изображениями.
Функция вызова конвейера для генерации.
Примеры:
>>> from PIL import Image
>>> import torch
>>> from diffusers import DiffusionPipeline
>>> from diffusers.utils import export_to_gif, load_image

>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

>>> repo = "openai/shap-e-img2img"
>>> pipe = DiffusionPipeline.from_pretrained(repo, torch_dtype=torch.float16)
>>> pipe = pipe.to(device)

>>> guidance_scale = 3.0
>>> image_url = "https://hf.co/datasets/diffusers/docs-images/resolve/main/shap-e/corgi.png"
>>> image = load_image(image_url).convert("RGB")

>>> images = pipe(
...     image,
...     guidance_scale=guidance_scale,
...     num_inference_steps=64,
...     frame_size=256,
... ).images

>>> gif_path = export_to_gif(images[0], "corgi_3d.gif")
ShapEPipelineOutput
класс diffusers.pipelines.shap_e.pipeline_shap_e.ShapEPipelineOutput
< source >( images: list[list[PIL.Image.Image]] | list[list[numpy.ndarray]] )
Класс результата для ShapEPipeline и ShapEImg2ImgPipeline.