
Diffusers documentation
Flux
Flux


Flux é uma série de modelos de geração de imagem a partir de texto baseados em transformadores de difusão. Para saber mais sobre o Flux, confira o post original no blog dos criadores do Flux, a Black Forest Labs.
Os checkpoints originais do modelo Flux podem ser encontrados aqui. O código de inferência original pode ser encontrado aqui.
Flux pode ser bastante caro de executar em dispositivos de hardware de consumo. No entanto, você pode realizar uma série de otimizações para executá-lo mais rápido e de uma forma mais amigável à memória. Consulte esta seção para mais detalhes. Além disso, o Flux pode se beneficiar da quantização para eficiência de memória, com um compromisso em relação à latência de inferência. Consulte este post de blog para saber mais. Para uma lista exaustiva de recursos, confira este gist.
Caching também pode acelerar a inferência ao armazenar e reutilizar saídas intermediárias.
O Flux está disponível nas seguintes variantes:
| tipo de modelo | ID do modelo |
|---|---|
| Timestep destilado | black-forest-labs/FLUX.1-schnell |
| Destilado por orientação | black-forest-labs/FLUX.1-dev |
| Preencher Inpainting/Outpainting (Guidance-distilled) | black-forest-labs/FLUX.1-Fill-dev |
| Canny Control (Guidance destilado) | black-forest-labs/FLUX.1-Canny-dev |
| Controle de Profundidade (Destilado de Orientação) | black-forest-labs/FLUX.1-Depth-dev |
| Canny Control (LoRA) | black-forest-labs/FLUX.1-Canny-dev-lora |
| Controle de Profundidade (LoRA) | black-forest-labs/FLUX.1-Depth-dev-lora |
| Redux (Adaptador) | black-forest-labs/FLUX.1-Redux-dev |
| Kontext | black-forest-labs/FLUX.1-kontext |
Todos os checkpoints têm usos diferentes, que detalhamos abaixo.
Timestep destilado
max_sequence_lengthnão pode ser maior que 256.guidance_scaleprecisa ser 0.- Como este é um modelo destilado em passos de tempo, ele se beneficia de menos etapas de amostragem.
import torch
from diffusers import FluxPipeline

pipe = FluxPipeline.from_pretrained("black-forest-labs/FLUX.1-schnell", dtype=torch.bfloat16)
pipe.enable_model_cpu_offload()

prompt = "A cat holding a sign that says hello world"
out = pipe(
    prompt=prompt,
    guidance_scale=0.,
    height=768,
    width=1360,
    num_inference_steps=4,
    max_sequence_length=256,
).images[0]
out.save("image.png")
Destilado por orientação
- A variante destilada por orientação leva cerca de 50 etapas de amostragem para uma geração de boa qualidade.
- Ele não possui limitações em relação ao
max_sequence_length.
import torch
from diffusers import FluxPipeline

pipe = FluxPipeline.from_pretrained("black-forest-labs/FLUX.1-dev", dtype=torch.bfloat16)
pipe.enable_model_cpu_offload()

prompt = "a tiny astronaut hatching from an egg on the moon"
out = pipe(
    prompt=prompt,
    guidance_scale=3.5,
    height=768,
    width=1360,
    num_inference_steps=50,
).images[0]
out.save("image.png")
Preencher Inpainting/Outpainting
- O pipeline Flux Fill não requer
strengthcomo entrada, ao contrário dos pipelines de inpainting regulares. - Ele suporta tanto inpainting quanto outpainting.
import torch
from diffusers import FluxFillPipeline
from diffusers.utils import load_image

image = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/cup.png")
mask = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/cup_mask.png")

repo_id = "black-forest-labs/FLUX.1-Fill-dev"
pipe = FluxFillPipeline.from_pretrained(repo_id, dtype=torch.bfloat16).to("cuda")  # or "mps", "xpu", "cpu"

image = pipe(
    prompt="a white paper cup",
    image=image,
    mask_image=mask,
    height=1632,
    width=1232,
    max_sequence_length=512,
    generator=torch.Generator("cpu").manual_seed(0)
).images[0]
image.save(f"output.png")
Canny Control
Observação: black-forest-labs/Flux.1-Canny-dev não é um modelo ControlNetModel. Os modelos ControlNet são um componente separado do UNet/Transformer, cujos resíduos são somados ao modelo subjacente real. O Canny Control é uma arquitetura alternativa que alcança resultados efetivamente iguais aos de um modelo ControlNet, utilizando concatenação por canal com a condição de controle de entrada e garantindo que o transformer aprenda o controle de estrutura seguindo a condição o mais fielmente possível.
# !pip install -U controlnet-aux
import torch
from controlnet_aux import CannyDetector
from diffusers import FluxControlPipeline
from diffusers.utils import load_image

pipe = FluxControlPipeline.from_pretrained("black-forest-labs/FLUX.1-Canny-dev", dtype=torch.bfloat16).to("cuda")  # or "mps", "xpu", "cpu"

prompt = "A robot made of exotic candies and chocolates of different kinds. The background is filled with confetti and celebratory gifts."
control_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/robot.png")

processor = CannyDetector()
control_image = processor(control_image, low_threshold=50, high_threshold=200, detect_resolution=1024, image_resolution=1024)

image = pipe(
    prompt=prompt,
    control_image=control_image,
    height=1024,
    width=1024,
    num_inference_steps=50,
    guidance_scale=30.0,
).images[0]
image.save("output.png")
O Canny Control também é possível com uma variante LoRA desta condição. O uso é o seguinte:
# !pip install -U controlnet-aux
import torch
from controlnet_aux import CannyDetector
from diffusers import FluxControlPipeline
from diffusers.utils import load_image

pipe = FluxControlPipeline.from_pretrained("black-forest-labs/FLUX.1-dev", dtype=torch.bfloat16).to("cuda")  # or "mps", "xpu", "cpu"
pipe.load_lora_weights("black-forest-labs/FLUX.1-Canny-dev-lora")

prompt = "A robot made of exotic candies and chocolates of different kinds. The background is filled with confetti and celebratory gifts."
control_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/robot.png")

processor = CannyDetector()
control_image = processor(control_image, low_threshold=50, high_threshold=200, detect_resolution=1024, image_resolution=1024)

image = pipe(
    prompt=prompt,
    control_image=control_image,
    height=1024,
    width=1024,
    num_inference_steps=50,
    guidance_scale=30.0,
).images[0]
image.save("output.png")
Controle de Profundidade
Observação: black-forest-labs/Flux.1-Depth-dev não é um modelo ControlNet. Modelos ControlNetModel são um componente separado do UNet/Transformer, cujos resíduos são adicionados ao modelo subjacente real. O Depth Control é uma arquitetura alternativa que alcança resultados efetivamente iguais aos de um modelo ControlNet, utilizando concatenação por canal com a condição de controle de entrada e garantindo que o transformer aprenda o controle de estrutura seguindo a condição o mais próximo possível.
# !pip install git+https://github.com/huggingface/image_gen_aux
import torch
from diffusers import FluxControlPipeline, FluxTransformer2DModel
from diffusers.utils import load_image
from image_gen_aux import DepthPreprocessor

pipe = FluxControlPipeline.from_pretrained("black-forest-labs/FLUX.1-Depth-dev", dtype=torch.bfloat16).to("cuda")  # or "mps", "xpu", "cpu"

prompt = "A robot made of exotic candies and chocolates of different kinds. The background is filled with confetti and celebratory gifts."
control_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/robot.png")

processor = DepthPreprocessor.from_pretrained("LiheYoung/depth-anything-large-hf")
control_image = processor(control_image)[0].convert("RGB")

image = pipe(
    prompt=prompt,
    control_image=control_image,
    height=1024,
    width=1024,
    num_inference_steps=30,
    guidance_scale=10.0,
    generator=torch.Generator().manual_seed(42),
).images[0]
image.save("output.png")
O Controle de Profundidade também é possível com uma variante LoRA desta condição. O uso é o seguinte:
# !pip install git+https://github.com/huggingface/image_gen_aux
import torch
from diffusers import FluxControlPipeline, FluxTransformer2DModel
from diffusers.utils import load_image
from image_gen_aux import DepthPreprocessor

pipe = FluxControlPipeline.from_pretrained("black-forest-labs/FLUX.1-dev", dtype=torch.bfloat16).to("cuda")  # or "mps", "xpu", "cpu"
pipe.load_lora_weights("black-forest-labs/FLUX.1-Depth-dev-lora")

prompt = "A robot made of exotic candies and chocolates of different kinds. The background is filled with confetti and celebratory gifts."
control_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/robot.png")

processor = DepthPreprocessor.from_pretrained("LiheYoung/depth-anything-large-hf")
control_image = processor(control_image)[0].convert("RGB")

image = pipe(
    prompt=prompt,
    control_image=control_image,
    height=1024,
    width=1024,
    num_inference_steps=30,
    guidance_scale=10.0,
    generator=torch.Generator().manual_seed(42),
).images[0]
image.save("output.png")
Redux
- O pipeline Flux Redux é um adaptador para os modelos base FLUX.1. Ele pode ser usado tanto com flux-dev quanto com flux-schnell, para geração de imagem a partir de imagem.
- Primeiro, você pode usar o
FluxPriorReduxPipelinepara obter osprompt_embedse ospooled_prompt_embedse, em seguida, inseri-los noFluxPipelinepara a geração de imagem a partir de imagem. - Ao usar
FluxPriorReduxPipelinecom um pipeline base, você pode definirtext_encoder=Noneetext_encoder_2=Noneno pipeline base, a fim de economizar VRAM.
import torch
from diffusers import FluxPriorReduxPipeline, FluxPipeline
from diffusers.utils import load_image
device = "cuda"  # or "mps", "xpu", "cpu"
dtype = torch.bfloat16


repo_redux = "black-forest-labs/FLUX.1-Redux-dev"
repo_base = "black-forest-labs/FLUX.1-dev"
pipe_prior_redux = FluxPriorReduxPipeline.from_pretrained(repo_redux, dtype=dtype).to(device)
pipe = FluxPipeline.from_pretrained(
    repo_base,
    text_encoder=None,
    text_encoder_2=None,
    dtype=torch.bfloat16
).to(device)

image = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/style_ziggy/img5.png")
pipe_prior_output = pipe_prior_redux(image)
images = pipe(
    guidance_scale=2.5,
    num_inference_steps=50,
    generator=torch.Generator("cpu").manual_seed(0),
    **pipe_prior_output,
).images
images[0].save("flux-redux.png")
Kontext
Flux Kontext é um modelo que permite controle em contexto do processo de geração de imagens, possibilitando edição, refinamento, reiluminação, transferência de estilo, personalização de personagens e muito mais.
import torch
from diffusers import FluxKontextPipeline
from diffusers.utils import load_image

pipe = FluxKontextPipeline.from_pretrained(
    "black-forest-labs/FLUX.1-Kontext-dev", dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/yarn-art-pikachu.png").convert("RGB")
prompt = "Make Pikachu hold a sign that says 'Black Forest Labs is awesome', yarn art style, detailed, vibrant colors"
image = pipe(
    image=image,
    prompt=prompt,
    guidance_scale=2.5,
    generator=torch.Generator().manual_seed(42),
).images[0]
image.save("flux-kontext.png")
O Flux Kontext vem com um verificador de segurança de integridade, que deve ser executado após a etapa de geração de imagem. Para executar o verificador de segurança, instale o repositório oficial de black-forest-labs/flux e adicione o seguinte código:
from flux.content_filters import PixtralContentFilter

# ... pipeline invocation to generate images

integrity_checker = PixtralContentFilter(torch.device("cuda"))
image_ = np.array(image) / 255.0
image_ = 2 * image_ - 1
image_ = torch.from_numpy(image_).to("cuda", dtype=torch.float32).unsqueeze(0).permute(0, 3, 1, 2)
if integrity_checker.test_image(image_):
    raise ValueError("Your image has been flagged. Choose another prompt/image or try again.")
Kontext Inpainting
FluxKontextInpaintPipeline permite a modificação de imagens dentro de uma região de máscara fixa. Atualmente, ele suporta tanto a condicionamento baseado em texto quanto o condicionamento baseado em referência de imagem.
import torch
from diffusers import FluxKontextInpaintPipeline
from diffusers.utils import load_image

prompt = "Change the yellow dinosaur to green one"
img_url = (
    "https://github.com/ZenAI-Vietnam/Flux-Kontext-pipelines/blob/main/assets/dinosaur_input.jpeg?raw=true"
)
mask_url = (
    "https://github.com/ZenAI-Vietnam/Flux-Kontext-pipelines/blob/main/assets/dinosaur_mask.png?raw=true"
)

source = load_image(img_url)
mask = load_image(mask_url)

pipe = FluxKontextInpaintPipeline.from_pretrained(
    "black-forest-labs/FLUX.1-Kontext-dev", dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

image = pipe(prompt=prompt, image=source, mask_image=mask, strength=1.0).images[0]
image.save("kontext_inpainting_normal.png")import torch
from diffusers import FluxKontextInpaintPipeline
from diffusers.utils import load_image
pipe = FluxKontextInpaintPipeline.from_pretrained(
"black-forest-labs/FLUX.1-Kontext-dev", dtype=torch.bfloat16
)
pipe.to("cuda") # or "mps", "xpu", "cpu"
prompt = "Replace this ball"
img_url = "https://images.pexels.com/photos/39362/the-ball-stadion-football-the-pitch-39362.jpeg?auto=compress&cs=tinysrgb&dpr=1&w=500"
mask_url = "https://github.com/ZenAI-Vietnam/Flux-Kontext-pipelines/blob/main/assets/ball_mask.png?raw=true"
image_reference_url = "https://encrypted-tbn0.gstatic.com/images?q=tbn:ANd9GcTah3x6OL_ECMBaZ5ZlJJhNsyC-OSMLWAI-xw&s"
source = load_image(img_url)
mask = load_image(mask_url)
image_reference = load_image(image_reference_url)
mask = pipe.mask_processor.blur(mask, blur_factor=12)
image = pipe(
prompt=prompt, image=source, mask_image=mask, image_reference=image_reference, strength=1.0
).images[0]
image.save("kontext_inpainting_ref.png")Combinando Flux Turbo LoRAs com Flux Control, Fill e Redux
Podemos combinar Flux Turbo LoRAs com Flux Control e outros pipelines, como Fill e Redux, para habilitar inferência em poucas etapas. O exemplo abaixo mostra como fazer isso para o Flux Control LoRA de profundidade e o turbo LoRA de ByteDance/Hyper-SD.
from diffusers import FluxControlPipeline
from image_gen_aux import DepthPreprocessor
from diffusers.utils import load_image
from huggingface_hub import hf_hub_download
import torch

control_pipe = FluxControlPipeline.from_pretrained("black-forest-labs/FLUX.1-dev", dtype=torch.bfloat16)
control_pipe.load_lora_weights("black-forest-labs/FLUX.1-Depth-dev-lora", adapter_name="depth")
control_pipe.load_lora_weights(
    hf_hub_download("ByteDance/Hyper-SD", "Hyper-FLUX.1-dev-8steps-lora.safetensors"), adapter_name="hyper-sd"
)
control_pipe.set_adapters(["depth", "hyper-sd"], adapter_weights=[0.85, 0.125])
control_pipe.enable_model_cpu_offload()

prompt = "A robot made of exotic candies and chocolates of different kinds. The background is filled with confetti and celebratory gifts."
control_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/robot.png")

processor = DepthPreprocessor.from_pretrained("LiheYoung/depth-anything-large-hf")
control_image = processor(control_image)[0].convert("RGB")

image = control_pipe(
    prompt=prompt,
    control_image=control_image,
    height=1024,
    width=1024,
    num_inference_steps=8,
    guidance_scale=10.0,
    generator=torch.Generator().manual_seed(42),
).images[0]
image.save("output.png")
Observação sobre unload_lora_weights() ao usar LoRAs do Flux
Ao descarregar os pesos do Control LoRA, chame pipe.unload_lora_weights(reset_to_overwritten_params=True) para redefinir completamente o pipe.transformer para sua forma original. O pipeline resultante pode então ser usado com métodos como DiffusionPipeline.from_pipe(). Mais detalhes sobre este argumento estão disponíveis em este PR.
IP-Adapter
Confira o IP-Adapter para saber mais sobre como os IP-Adapters funcionam.
Um IP-Adapter permite que você use imagens para fazer o prompt do Flux, além do prompt de texto. Isso é especialmente útil ao descrever conceitos complexos que são difíceis de articular apenas por meio de texto e quando você possui imagens de referência.
import torch
from diffusers import FluxPipeline
from diffusers.utils import load_image

pipe = FluxPipeline.from_pretrained(
    "black-forest-labs/FLUX.1-dev", dtype=torch.bfloat16
).to("cuda")  # or "mps", "xpu", "cpu"

image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/flux_ip_adapter_input.jpg").resize((1024, 1024))

pipe.load_ip_adapter(
    "XLabs-AI/flux-ip-adapter",
    weight_name="ip_adapter.safetensors",
    image_encoder_pretrained_model_name_or_path="openai/clip-vit-large-patch14"
)
pipe.set_ip_adapter_scale(1.0)

image = pipe(
    width=1024,
    height=1024,
    prompt="wearing sunglasses",
    negative_prompt="",
    true_cfg_scale=4.0,
    generator=torch.Generator().manual_seed(4444),
    ip_adapter_image=image,
).images[0]

image.save('flux_ip_adapter_output.jpg')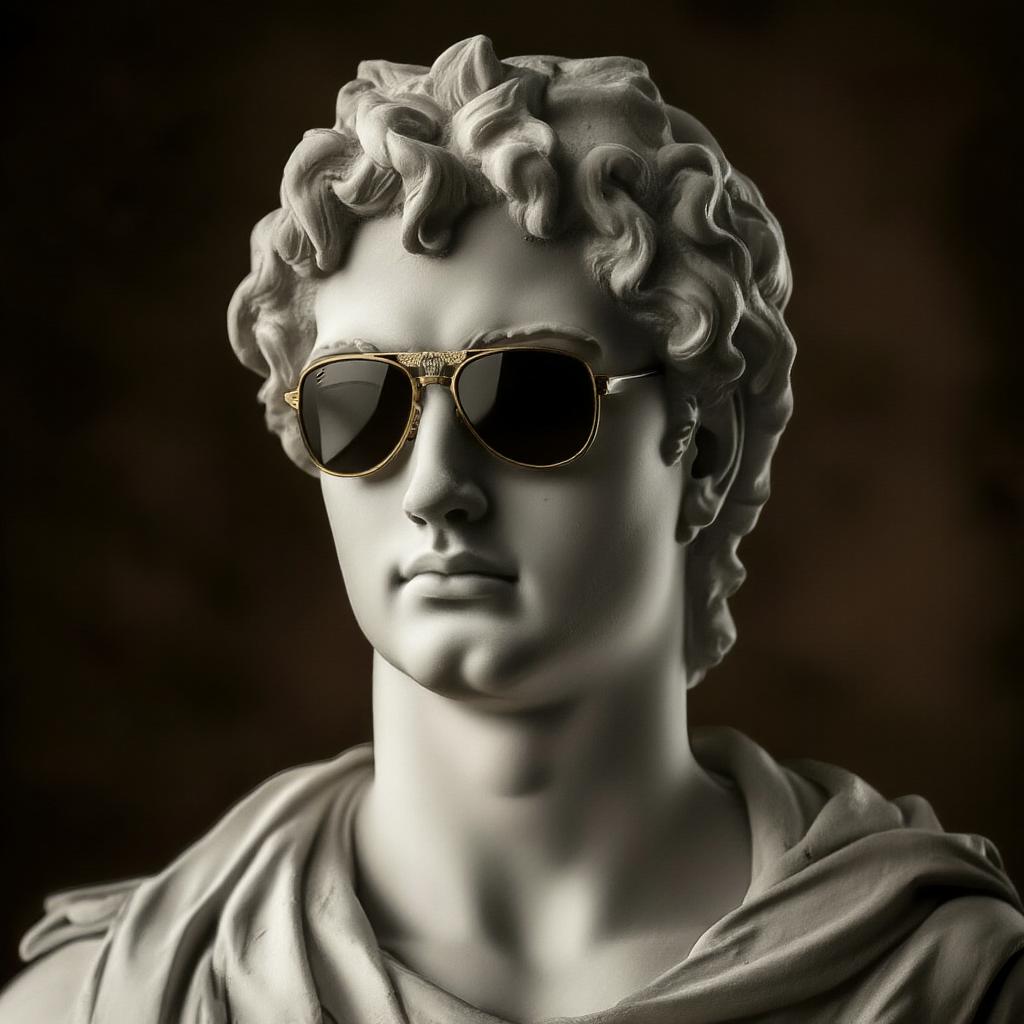
Otimizar
Flux é um modelo muito grande e requer ~50GB de RAM/VRAM para carregar todos os componentes de modelagem. Ative algumas das otimizações abaixo para reduzir os requisitos de memória.
Descarregamento em grupo
Group offloading reduz o uso de VRAM ao transferir grupos de camadas internas para fora da GPU, em vez de transferir o modelo inteiro ou os pesos. É necessário usar apply_group_offloading() em todos os componentes do modelo de um pipeline. O parâmetro offload_type permite alternar entre offloading em nível de bloco e em nível de folha. Ao defini-lo como leaf_level, os parâmetros de nível de folha mais baixos são transferidos para a CPU, em vez de serem transferidos em nível de módulo.
Em dispositivos CUDA que suportam streaming de dados assíncrono, defina use_stream=True para sobrepor a transferência de dados e o cálculo, acelerando a inferência.
É possível misturar o offloading em nível de bloco e em nível de folha para diferentes componentes em um pipeline.
import torch
from diffusers import FluxPipeline
from diffusers.hooks import apply_group_offloading

model_id = "black-forest-labs/FLUX.1-dev"
dtype = torch.bfloat16
pipe = FluxPipeline.from_pretrained(
	model_id,
	dtype=dtype,
)

apply_group_offloading(
    pipe.transformer,
    offload_type="leaf_level",
    offload_device=torch.device("cpu"),
    onload_device=torch.device("cuda"),
    use_stream=True,
)
apply_group_offloading(
    pipe.text_encoder,
    offload_device=torch.device("cpu"),
    onload_device=torch.device("cuda"),
    offload_type="leaf_level",
    use_stream=True,
)
apply_group_offloading(
    pipe.text_encoder_2,
    offload_device=torch.device("cpu"),
    onload_device=torch.device("cuda"),
    offload_type="leaf_level",
    use_stream=True,
)
apply_group_offloading(
    pipe.vae,
    offload_device=torch.device("cpu"),
    onload_device=torch.device("cuda"),
    offload_type="leaf_level",
    use_stream=True,
)

prompt="A cat wearing sunglasses and working as a lifeguard at pool."

generator = torch.Generator().manual_seed(181201)
image = pipe(
    prompt,
    width=576,
    height=1024,
    num_inference_steps=30,
    generator=generator
).images[0]
image
Executando inferência em FP16
Flux pode gerar imagens de alta qualidade com FP16 (ou seja, para acelerar a inferência em GPUs Turing/Volta), mas produz saídas diferentes em comparação com FP32/BF16. O problema é que algumas ativações nos codificadores de texto precisam ser limitadas (clipped) ao executar em FP16, o que afeta a imagem geral. Forçar os codificadores de texto a executar com inferência em FP32, portanto, remove essa diferença de saída. Veja aqui para mais detalhes.
Código de inferência em FP16:
import torch
from diffusers import FluxPipeline

pipe = FluxPipeline.from_pretrained("black-forest-labs/FLUX.1-schnell", dtype=torch.bfloat16) # can replace schnell with dev
# to run on low vram GPUs (i.e. between 4 and 32 GB VRAM)
pipe.enable_sequential_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()

pipe.to(torch.float16) # casting here instead of in the pipeline constructor because doing so in the constructor loads all models into CPU memory at once

prompt = "A cat holding a sign that says hello world"
out = pipe(
    prompt=prompt,
    guidance_scale=0.,
    height=768,
    width=1360,
    num_inference_steps=4,
    max_sequence_length=256,
).images[0]
out.save("image.png")
Quantização
A quantização ajuda a reduzir os requisitos de memória de modelos muito grandes armazenando os pesos do modelo em um tipo de dados de menor precisão. No entanto, a quantização pode ter um impacto variável na qualidade do vídeo, dependendo do modelo de vídeo.
Consulte a visão geral de Quantization para saber mais sobre os backends de quantização suportados e sobre como selecionar um backend de quantização que atenda ao seu caso de uso. O exemplo abaixo demonstra como carregar um FluxPipeline quantizado para inferência com bitsandbytes.
import torch
from diffusers import BitsAndBytesConfig as DiffusersBitsAndBytesConfig, FluxTransformer2DModel, FluxPipeline
from transformers import BitsAndBytesConfig as BitsAndBytesConfig, T5EncoderModel

quant_config = BitsAndBytesConfig(load_in_8bit=True)
text_encoder_8bit = T5EncoderModel.from_pretrained(
    "black-forest-labs/FLUX.1-dev",
    subfolder="text_encoder_2",
    quantization_config=quant_config,
    dtype=torch.float16,
)

quant_config = DiffusersBitsAndBytesConfig(load_in_8bit=True)
transformer_8bit = FluxTransformer2DModel.from_pretrained(
    "black-forest-labs/FLUX.1-dev",
    subfolder="transformer",
    quantization_config=quant_config,
    dtype=torch.float16,
)

pipeline = FluxPipeline.from_pretrained(
    "black-forest-labs/FLUX.1-dev",
    text_encoder_2=text_encoder_8bit,
    transformer=transformer_8bit,
    dtype=torch.float16,
    device_map="balanced",
)

prompt = "a tiny astronaut hatching from an egg on the moon"
image = pipeline(prompt, guidance_scale=3.5, height=768, width=1360, num_inference_steps=50).images[0]
image.save("flux.png")
Carregamento de arquivo único para o FluxTransformer2DModel
O FluxTransformer2DModel suporta o carregamento de checkpoints no formato original distribuído pela Black Forest Labs. Isso também é útil ao tentar carregar versões finetunadas ou quantizadas dos modelos publicadas pela comunidade.
A inferência com
FP8pode ser instável, dependendo do tipo de GPU, da versão do CUDA e da versão dotorchque você está usando. Recomenda-se usar a bibliotecaoptimum-quantopara executar a inferência FP8 na sua máquina.
O exemplo a seguir demonstra como executar o Flux com menos de 16GB de VRAM.
Primeiro, instale optimum-quanto
pip install optimum-quanto
Em seguida, execute o exemplo a seguir
import torch
from diffusers import FluxTransformer2DModel, FluxPipeline
from transformers import T5EncoderModel, CLIPTextModel
from optimum.quanto import freeze, qfloat8, quantize

bfl_repo = "black-forest-labs/FLUX.1-dev"
dtype = torch.bfloat16

transformer = FluxTransformer2DModel.from_single_file("https://huggingface.co/Kijai/flux-fp8/blob/main/flux1-dev-fp8.safetensors", dtype=dtype)
quantize(transformer, weights=qfloat8)
freeze(transformer)

text_encoder_2 = T5EncoderModel.from_pretrained(bfl_repo, subfolder="text_encoder_2", dtype=dtype)
quantize(text_encoder_2, weights=qfloat8)
freeze(text_encoder_2)

pipe = FluxPipeline.from_pretrained(bfl_repo, transformer=None, text_encoder_2=None, dtype=dtype)
pipe.transformer = transformer
pipe.text_encoder_2 = text_encoder_2

pipe.enable_model_cpu_offload()

prompt = "A cat holding a sign that says hello world"
image = pipe(
    prompt,
    guidance_scale=3.5,
    output_type="pil",
    num_inference_steps=20,
    generator=torch.Generator("cpu").manual_seed(0)
).images[0]

image.save("flux-fp8-dev.png")
FluxPipeline
classe diffusers.FluxPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModelimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = None )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux para geração de imagens a partir de texto.
Referência: https://blackforestlabs.ai/announcing-black-forest-labs/
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Nonenegative_prompt: str | list[str] = Nonenegative_prompt_2: str | list[str] | None = Nonetrue_cfg_scale: float = 1.0height: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 3.5num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Nonenegative_ip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Se não for definido, é necessário passarnegative_prompt_embedsem vez disso. Ignorado quando não se usa orientação (ou seja, ignorado setrue_cfg_scalenão for maior que1). - negative_prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados paratokenizer_2etext_encoder_2. Se não definido,negative_prompté usado em todos os text-encoders. - true_cfg_scale (
float, opcional, padrão 1.0) — A orientação livre de classificador verdadeira (escala de orientação) é ativada quandotrue_cfg_scale> 1 enegative_prompté fornecido. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 3,5) — A escala de orientação incorporada é ativada ao definirguidance_scale> 1. Valores maiores deguidance_scaleincentivam o modelo a gerar imagens mais alinhadas com opromptem detrimento de uma menor qualidade de imagem.Modelos destilados por orientação aproximam a orientação livre de classe verdadeira para
guidance_scale> 1. Consulte o artigo para saber mais. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - ip_adapter_image — (
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_ip_adapter_image —
(
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - negative_ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto negativas pré-geradas. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não for fornecido, negative_prompt_embeds será gerado a partir do argumento de entradanegative_prompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompt. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entradanegative_prompt. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import FluxPipeline

>>> pipe = FluxPipeline.from_pretrained("black-forest-labs/FLUX.1-schnell", torch_dtype=torch.bfloat16)
>>> pipe.to("cuda")
>>> prompt = "A cat holding a sign that says hello world"
>>> # Depending on the variant being used, the pipeline call will slightly vary.
>>> # Refer to the pipeline documentation for more details.
>>> image = pipe(prompt, num_inference_steps=4, guidance_scale=0.0).images[0]
>>> image.save("flux.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxImg2ImgPipeline
classe diffusers.FluxImg2ImgPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModelimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = None )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux para inpainting de imagens.
Referência: https://blackforestlabs.ai/announcing-black-forest-labs/
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Nonenegative_prompt: str | list[str] = Nonenegative_prompt_2: str | list[str] | None = Nonetrue_cfg_scale: float = 1.0image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Noneheight: int | None = Nonewidth: int | None = Nonestrength: float = 0.6num_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 7.0num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Nonenegative_ip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Se não for definido, é necessário passarnegative_prompt_embedsem vez disso. Ignorado quando não se usa orientação (ou seja, ignorado setrue_cfg_scalenão for maior que1). - negative_prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados paratokenizer_2etext_encoder_2. Se não definido,negative_prompté usado em todos os text-encoders. - true_cfg_scale (
float, opcional, padrão 1.0) — A orientação livre de classificador verdadeira (escala de orientação) é ativada quandotrue_cfg_scale> 1 enegative_prompté fornecido. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens a ser usado como ponto de partida. Para arrays numpy e tensors pytorch, o intervalo de valores esperado é entre[0, 1]Se for um tensor ou uma lista de tensors, a forma esperada deve ser(B, C, H, W)ou(C, H, W). Se for um array numpy ou uma lista de arrays, a forma esperada deve ser(B, H, W, C)ou(H, W, C)Também pode aceitar latentes de imagem comoimage, mas, se latentes forem passados diretamente, eles não são codificados novamente. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - strength (
float, opcional, padrão 1.0) — Indica o grau de transformação daimagede referência. Deve estar entre 0 e 1. Aimageé usada como ponto de partida e mais ruído é adicionado quanto maior for ostrength. O número de etapas de desruidamento depende da quantidade de ruído inicialmente adicionada. Quandostrengthé 1, o ruído adicionado é máximo e o processo de desruidamento é executado pelo número total de iterações especificado emnum_inference_steps. Um valor de 1 essencialmente ignora aimage. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 7.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto negativas pré-geradas. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não for fornecido, negative_prompt_embeds será gerado a partir do argumento de entradanegative_prompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompt. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entradanegative_prompt. - ip_adapter_image — (
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_ip_adapter_image —
(
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - negative_ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch

>>> from diffusers import FluxImg2ImgPipeline
>>> from diffusers.utils import load_image

>>> device = "cuda"
>>> pipe = FluxImg2ImgPipeline.from_pretrained("black-forest-labs/FLUX.1-schnell", torch_dtype=torch.bfloat16)
>>> pipe = pipe.to(device)

>>> url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
>>> init_image = load_image(url).resize((1024, 1024))

>>> prompt = "cat wizard, gandalf, lord of the rings, detailed, fantasy, cute, adorable, Pixar, Disney, 8k"

>>> images = pipe(
...     prompt=prompt, image=init_image, num_inference_steps=4, strength=0.95, guidance_scale=0.0
... ).images[0]
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxInpaintPipeline
classe diffusers.FluxInpaintPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModelimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = None )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux para inpainting de imagens.
Referência: https://blackforestlabs.ai/announcing-black-forest-labs/
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Nonenegative_prompt: str | list[str] = Nonenegative_prompt_2: str | list[str] | None = Nonetrue_cfg_scale: float = 1.0image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonemask_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonemasked_image_latents: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Noneheight: int | None = Nonewidth: int | None = Nonepadding_mask_crop: int | None = Nonestrength: float = 0.6num_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 7.0num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Nonenegative_ip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Se não for definido, é necessário passarnegative_prompt_embedsem vez disso. Ignorado quando não se usa orientação (ou seja, ignorado setrue_cfg_scalenão for maior que1). - negative_prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados paratokenizer_2etext_encoder_2. Se não definido,negative_prompté usado em todos os text-encoders. - true_cfg_scale (
float, opcional, padrão 1.0) — A orientação livre de classificador verdadeira (escala de orientação) é ativada quandotrue_cfg_scale> 1 enegative_prompté fornecido. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens a ser usado como ponto de partida. Para arrays numpy e tensors pytorch, o intervalo de valores esperado é entre[0, 1]Se for um tensor ou uma lista de tensors, a forma esperada deve ser(B, C, H, W)ou(C, H, W). Se for um array numpy ou uma lista de arrays, a forma esperada deve ser(B, H, W, C)ou(H, W, C)Também pode aceitar latentes de imagem comoimage, mas, se latentes forem passados diretamente, eles não são codificados novamente. - mask_image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens para mascararimage. Os pixels brancos na máscara são repintados, enquanto os pixels pretos são preservados. Semask_imagefor uma imagem PIL, ela é convertida para um único canal (luminância) antes do uso. Se for um array numpy ou tensor pytorch, deve conter um único canal de cor (L) em vez de 3, portanto a forma esperada para um tensor pytorch seria(B, 1, H, W),(B, H, W),(1, H, W),(H, W). E para um array numpy seria(B, H, W, 1),(B, H, W),(H, W, 1)ou(H, W). - masked_image_latents (
torch.Tensor,list[torch.Tensor]) —Tensorque representa um lote de imagens para mascarar aimagegerada pelo VAE. Se não for fornecido, o tensor de latentes da máscara será gerado pormask_image. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - padding_mask_crop (
int, opcional, padrãoNone) — O tamanho da margem no recorte a ser aplicado à imagem e à máscara. SeNone, nenhum recorte é aplicado à imagem e à mask_image. Sepadding_mask_cropnão forNone, primeiro será encontrada uma região retangular com a mesma proporção da imagem e que contenha toda a área mascarada, e então essa área será expandida com base empadding_mask_crop. A imagem e a mask_image serão então recortadas com base na área expandida antes do redimensionamento para o tamanho original da imagem para o inpainting. Isso é útil quando a área mascarada é pequena, enquanto a imagem é grande e contém informações irrelevantes para o inpainting, como o fundo. - strength (
float, opcional, padrão 1.0) — Indica o grau de transformação daimagede referência. Deve estar entre 0 e 1. Aimageé usada como ponto de partida e mais ruído é adicionado quanto maior for ostrength. O número de etapas de desruidamento depende da quantidade de ruído inicialmente adicionada. Quandostrengthé 1, o ruído adicionado é máximo e o processo de desruidamento é executado pelo número total de iterações especificado emnum_inference_steps. Um valor de 1 essencialmente ignora aimage. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 7.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto negativas pré-geradas. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não for fornecido, negative_prompt_embeds será gerado a partir do argumento de entradanegative_prompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompt. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entradanegative_prompt. - ip_adapter_image — (
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_ip_adapter_image —
(
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - negative_ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import FluxInpaintPipeline
>>> from diffusers.utils import load_image

>>> pipe = FluxInpaintPipeline.from_pretrained("black-forest-labs/FLUX.1-schnell", torch_dtype=torch.bfloat16)
>>> pipe.to("cuda")
>>> prompt = "Face of a yellow cat, high resolution, sitting on a park bench"
>>> img_url = "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo.png"
>>> mask_url = "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo_mask.png"
>>> source = load_image(img_url)
>>> mask = load_image(mask_url)
>>> image = pipe(prompt=prompt, image=source, mask_image=mask).images[0]
>>> image.save("flux_inpainting.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxControlNetInpaintPipeline
classe diffusers.FluxControlNetInpaintPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModelcontrolnet: diffusers.models.controlnets.controlnet_flux.FluxControlNetModel | list[diffusers.models.controlnets.controlnet_flux.FluxControlNetModel] | tuple[diffusers.models.controlnets.controlnet_flux.FluxControlNetModel] | diffusers.models.controlnets.controlnet_flux.FluxMultiControlNetModel )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline de controlnet do Flux para inpainting.
Referência: https://blackforestlabs.ai/announcing-black-forest-labs/
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneimage: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonemask_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonemasked_image_latents: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonecontrol_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Noneheight: int | None = Nonewidth: int | None = Nonestrength: float = 0.6padding_mask_crop: int | None = Nonesigmas: list[float] | None = Nonenum_inference_steps: int = 28guidance_scale: float = 7.0control_guidance_start: float | list[float] = 0.0control_guidance_end: float | list[float] = 1.0control_mode: int | list[int] | None = Nonecontrolnet_conditioning_scale: float | list[float] = 1.0num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados para otokenizer_2e otext_encoder_2. - image (
PIL.Image.Imageoulist[PIL.Image.Image]outorch.FloatTensor) — A(s) imagem(ns) a ser(em) inpaintada(s). - mask_image (
PIL.Image.Imageoulist[PIL.Image.Image]outorch.FloatTensor) — A(s) imagem(ns) de máscara a ser(em) usada(s) para inpainting. Os pixels brancos na máscara serão repintados, enquanto os pixels pretos serão preservados. - masked_image_latents (
torch.FloatTensor, opcional) — Latentes de imagem mascarada pré-gerados. - control_image (
PIL.Image.Imageoulist[PIL.Image.Image]outorch.FloatTensor) — A condição de entrada do ControlNet. A imagem para controlar a geração. - height (
int, opcional, padrão é self.default_sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão self.default_sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. - strength (
float, opcional, padrão 0.6) — Indica, conceitualmente, o quanto a área mascarada deve ser inpaintada. Deve estar entre 0 e 1. - padding_mask_crop (
int, opcional) — O tamanho do padding a ser usado ao recortar a máscara. - num_inference_steps (
int, opcional, padrão 28) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 7.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance. - control_guidance_start (
floatoulist[float], opcional, padrão 0.0) — A porcentagem dos passos totais em que o ControlNet começa a ser aplicado. - control_guidance_end (
floatoulist[float], opcional, padrão 1.0) — A porcentagem do total de etapas em que o ControlNet para de ser aplicado. - control_mode (
intoulist[int], opcional) — O modo para o ControlNet. Se vários ControlNets forem usados, isso deve ser uma lista. - controlnet_conditioning_scale (
floatoulist[float], opcional, padrão 1.0) — As saídas do ControlNet são multiplicadas porcontrolnet_conditioning_scaleantes de serem adicionadas ao residual no transformer original. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou mais geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto pré-gerados. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entrePIL.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Argumentos de palavra-chave adicionais a serem passados para o mecanismo de atenção conjunta. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de remoção de ruído durante a inferência. - callback_on_step_end_tensor_inputs (
list[str], opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. - max_sequence_length (
int, opcional, padrão 512) — O comprimento máximo da sequência a ser gerada.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import FluxControlNetInpaintPipeline
>>> from diffusers.models import FluxControlNetModel
>>> from diffusers.utils import load_image

>>> controlnet = FluxControlNetModel.from_pretrained(
...     "InstantX/FLUX.1-dev-controlnet-canny", torch_dtype=torch.float16
... )
>>> pipe = FluxControlNetInpaintPipeline.from_pretrained(
...     "black-forest-labs/FLUX.1-schnell", controlnet=controlnet, torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> control_image = load_image(
...     "https://huggingface.co/InstantX/FLUX.1-dev-Controlnet-Canny-alpha/resolve/main/canny.jpg"
... )
>>> init_image = load_image(
...     "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo.png"
... )
>>> mask_image = load_image(
...     "https://raw.githubusercontent.com/CompVis/latent-diffusion/main/data/inpainting_examples/overture-creations-5sI6fQgYIuo_mask.png"
... )

>>> prompt = "A girl holding a sign that says InstantX"
>>> image = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask_image,
...     control_image=control_image,
...     control_guidance_start=0.2,
...     control_guidance_end=0.8,
...     controlnet_conditioning_scale=0.7,
...     strength=0.7,
...     num_inference_steps=28,
...     guidance_scale=3.5,
... ).images[0]
>>> image.save("flux_controlnet_inpaint.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxControlNetImg2ImgPipeline
classe diffusers.FluxControlNetImg2ImgPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModelcontrolnet: diffusers.models.controlnets.controlnet_flux.FluxControlNetModel | list[diffusers.models.controlnets.controlnet_flux.FluxControlNetModel] | tuple[diffusers.models.controlnets.controlnet_flux.FluxControlNetModel] | diffusers.models.controlnets.controlnet_flux.FluxMultiControlNetModel )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline de controlnet do Flux para geração de imagem a partir de imagem.
Referência: https://blackforestlabs.ai/announcing-black-forest-labs/
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneimage: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonecontrol_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Noneheight: int | None = Nonewidth: int | None = Nonestrength: float = 0.6num_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 7.0control_guidance_start: float | list[float] = 0.0control_guidance_end: float | list[float] = 1.0control_mode: int | list[int] | None = Nonecontrolnet_conditioning_scale: float | list[float] = 1.0num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados para otokenizer_2e otext_encoder_2. - image (
PIL.Image.Imageoulist[PIL.Image.Image]outorch.FloatTensor) — A(s) imagem(ns) a serem modificadas pelo pipeline. - control_image (
PIL.Image.Imageoulist[PIL.Image.Image]outorch.FloatTensor) — A condição de entrada do ControlNet. A imagem para controlar a geração. - height (
int, opcional, padrão é self.default_sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão self.default_sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. - strength (
float, opcional, padrão 0.6) — Indica, conceitualmente, o quanto transformar aimagede referência. Deve estar entre 0 e 1. - num_inference_steps (
int, opcional, padrão 28) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 7.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance. - control_mode (
intoulist[int], opcional) — O modo para o ControlNet. Se vários ControlNets forem usados, isso deve ser uma lista. - controlnet_conditioning_scale (
floatoulist[float], opcional, padrão 1.0) — As saídas do ControlNet são multiplicadas porcontrolnet_conditioning_scaleantes de serem adicionadas ao residual no transformer original. - control_guidance_start (
floatoulist[float], opcional, padrão 0.0) — A porcentagem dos passos totais em que o ControlNet começa a ser aplicado. - control_guidance_end (
floatoulist[float], opcional, padrão 1.0) — A porcentagem do total de etapas em que o ControlNet para de ser aplicado. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou mais geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto pré-gerados. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entrePIL.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Argumentos de palavra-chave adicionais a serem passados para o mecanismo de atenção conjunta. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de remoção de ruído durante a inferência. - callback_on_step_end_tensor_inputs (
list[str], opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. - max_sequence_length (
int, opcional, padrão 512) — O comprimento máximo da sequência a ser gerada.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import FluxControlNetImg2ImgPipeline, FluxControlNetModel
>>> from diffusers.utils import load_image

>>> device = "cuda" if torch.cuda.is_available() else "cpu"

>>> controlnet = FluxControlNetModel.from_pretrained(
...     "InstantX/FLUX.1-dev-Controlnet-Canny-alpha", torch_dtype=torch.bfloat16
... )

>>> pipe = FluxControlNetImg2ImgPipeline.from_pretrained(
...     "black-forest-labs/FLUX.1-schnell", controlnet=controlnet, torch_dtype=torch.float16
... )

>>> pipe.text_encoder.to(torch.float16)
>>> pipe.controlnet.to(torch.float16)
>>> pipe.to("cuda")

>>> control_image = load_image("https://huggingface.co/InstantX/SD3-Controlnet-Canny/resolve/main/canny.jpg")
>>> init_image = load_image(
...     "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
... )

>>> prompt = "A girl in city, 25 years old, cool, futuristic"
>>> image = pipe(
...     prompt,
...     image=init_image,
...     control_image=control_image,
...     control_guidance_start=0.2,
...     control_guidance_end=0.8,
...     controlnet_conditioning_scale=1.0,
...     strength=0.7,
...     num_inference_steps=2,
...     guidance_scale=3.5,
... ).images[0]
>>> image.save("flux_controlnet_img2img.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxControlPipeline
classe diffusers.FluxControlPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModel )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux para geração controlada de texto para imagem com condições de imagem.
Referência: https://bfl.ai/flux-1-tools
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Nonecontrol_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 3.5num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar - control_image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image],list[np.ndarray], —list[list[torch.Tensor]],list[list[np.ndarray]]oulist[list[PIL.Image.Image]]): A condição de entrada do ControlNet para fornecer orientação aounetna geração. Se o tipo for especificado comotorch.Tensor, ele é passado ao ControlNet como está.PIL.Image.Imagetambém pode ser aceito como imagem. As dimensões da imagem de saída são, por padrão, as dimensões deimage. Se altura e/ou largura forem passadas,imageserá redimensionada de acordo. Se múltiplos ControlNets forem especificados eminit, as imagens devem ser passadas como uma lista, de modo que cada elemento da lista possa ser corretamente agrupado para entrada em um único ControlNet. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 3,5) — A escala de orientação embutida é ativada ao definirguidance_scale> 1. Valores maiores deguidance_scaleincentivam o modelo a gerar imagens mais alinhadas ao prompt, em detrimento de uma menor qualidade de imagem.Modelos destilados por orientação aproximam a orientação livre de classificador verdadeira para
guidance_scale> 1. Consulte o artigo para saber mais. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from controlnet_aux import CannyDetector
>>> from diffusers import FluxControlPipeline
>>> from diffusers.utils import load_image

>>> pipe = FluxControlPipeline.from_pretrained(
...     "black-forest-labs/FLUX.1-Canny-dev", torch_dtype=torch.bfloat16
... ).to("cuda")

>>> prompt = "A robot made of exotic candies and chocolates of different kinds. The background is filled with confetti and celebratory gifts."
>>> control_image = load_image(
...     "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/robot.png"
... )

>>> processor = CannyDetector()
>>> control_image = processor(
...     control_image, low_threshold=50, high_threshold=200, detect_resolution=1024, image_resolution=1024
... )

>>> image = pipe(
...     prompt=prompt,
...     control_image=control_image,
...     height=1024,
...     width=1024,
...     num_inference_steps=50,
...     guidance_scale=30.0,
... ).images[0]
>>> image.save("output.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxControlImg2ImgPipeline
classe diffusers.FluxControlImg2ImgPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModel )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux para inpainting de imagens.
Referência: https://blackforestlabs.ai/announcing-black-forest-labs/
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneimage: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Nonecontrol_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Noneheight: int | None = Nonewidth: int | None = Nonestrength: float = 0.6num_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 7.0num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens a ser usado como ponto de partida. Para arrays numpy e tensors pytorch, o intervalo de valores esperado é entre[0, 1]Se for um tensor ou uma lista de tensors, a forma esperada deve ser(B, C, H, W)ou(C, H, W). Se for um array numpy ou uma lista de arrays, a forma esperada deve ser(B, H, W, C)ou(H, W, C)Também pode aceitar latentes de imagem comoimage, mas, se latentes forem passados diretamente, eles não são codificados novamente. - control_image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image],list[np.ndarray], —list[list[torch.Tensor]],list[list[np.ndarray]]oulist[list[PIL.Image.Image]]): A condição de entrada do ControlNet para fornecer orientação aounetna geração. Se o tipo for especificado comotorch.Tensor, ele é passado ao ControlNet como está.PIL.Image.Imagetambém pode ser aceito como imagem. As dimensões da imagem de saída são, por padrão, as dimensões deimage. Se altura e/ou largura forem passadas,imageserá redimensionada de acordo. Se múltiplos ControlNets forem especificados eminit, as imagens devem ser passadas como uma lista, de modo que cada elemento da lista possa ser corretamente agrupado para entrada em um único ControlNet. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - strength (
float, opcional, padrão 1.0) — Indica o grau de transformação daimagede referência. Deve estar entre 0 e 1. Aimageé usada como ponto de partida e mais ruído é adicionado quanto maior for ostrength. O número de etapas de desruidamento depende da quantidade de ruído inicialmente adicionada. Quandostrengthé 1, o ruído adicionado é máximo e o processo de desruidamento é executado pelo número total de iterações especificado emnum_inference_steps. Um valor de 1 essencialmente ignora aimage. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 7.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from controlnet_aux import CannyDetector
>>> from diffusers import FluxControlImg2ImgPipeline
>>> from diffusers.utils import load_image

>>> pipe = FluxControlImg2ImgPipeline.from_pretrained(
...     "black-forest-labs/FLUX.1-Canny-dev", torch_dtype=torch.bfloat16
... ).to("cuda")

>>> prompt = "A robot made of exotic candies and chocolates of different kinds. Abstract background"
>>> image = load_image(
...     "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/watercolor-painting.jpg"
... )
>>> control_image = load_image(
...     "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/robot.png"
... )

>>> processor = CannyDetector()
>>> control_image = processor(
...     control_image, low_threshold=50, high_threshold=200, detect_resolution=1024, image_resolution=1024
... )

>>> image = pipe(
...     prompt=prompt,
...     image=image,
...     control_image=control_image,
...     strength=0.8,
...     height=1024,
...     width=1024,
...     num_inference_steps=50,
...     guidance_scale=30.0,
... ).images[0]
>>> image.save("output.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxPriorReduxPipeline
classe diffusers.FluxPriorReduxPipeline
< source >( image_encoder: SiglipVisionModelfeature_extractor: SiglipImageProcessorPilimage_embedder: ReduxImageEncodertext_encoder: CLIPTextModel = Nonetokenizer: CLIPTokenizer = Nonetext_encoder_2: T5EncoderModel = Nonetokenizer_2: T5Tokenizer = None )
Parâmetros
- image_encoder (
SiglipVisionModel) — modelo de visão SIGLIP para codificar a imagem de entrada. - feature_extractor (
SiglipImageProcessor) — Processador de imagens para pré-processamento de imagens para o modelo SIGLIP. - image_embedder (
ReduxImageEncoder) — Codificador de imagem do Redux para processar os embeddings do SIGLIP. - text_encoder (
CLIPTextModel, opcional) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel, opcional) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer, opcional) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast, opcional) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux Redux para geração de imagem a partir de imagem.
Referência: https://blackforestlabs.ai/flux-1-tools/
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneprompt_embeds_scale: float | list[float] | None = 1.0pooled_prompt_embeds_scale: float | list[float] | None = 1.0return_dict: bool = True ) → ~pipelines.flux.FluxPriorReduxPipelineOutput or tuple
Parâmetros
- image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens a ser usado como ponto de partida. Para arrays numpy e tensors pytorch, o intervalo de valores esperado é entre[0, 1]Se for um tensor ou uma lista de tensors, a forma esperada deve ser(B, C, H, W)ou(C, H, W). Se for um array numpy ou uma lista de arrays, a forma esperada deve ser(B, H, W, C)ou(H, W, C) - prompt (
strorlist[str], optional) — The prompt or prompts to guide the image generation. experimental feature: to use this feature, make sure to explicitly load text encoders to the pipeline. Prompts will be ignored if text encoders are not loaded. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados para otokenizer_2e otext_encoder_2. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto pré-gerados. - prompt_embeds_scale (
floatoulist[float], opcional, padrão 1.0) — Fator de escala (ou lista de fatores de escala por imagem) aplicado aos embeddings do prompt do redux antes de serem retornados. - pooled_prompt_embeds_scale (
floatoulist[float], opcional, padrão 1.0) — Fator de escala (ou lista de fatores de escala por imagem) aplicado aos embeddings de prompt agregados do redux antes de serem retornados. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPriorReduxPipelineOutputem vez de uma tupla simples.
Retorna
~pipelines.flux.FluxPriorReduxPipelineOutput ou tuple
~pipelines.flux.FluxPriorReduxPipelineOutput se return_dict for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import FluxPriorReduxPipeline, FluxPipeline
>>> from diffusers.utils import load_image

>>> device = "cuda"
>>> dtype = torch.bfloat16

>>> repo_redux = "black-forest-labs/FLUX.1-Redux-dev"
>>> repo_base = "black-forest-labs/FLUX.1-dev"
>>> pipe_prior_redux = FluxPriorReduxPipeline.from_pretrained(repo_redux, torch_dtype=dtype).to(device)
>>> pipe = FluxPipeline.from_pretrained(
...     repo_base, text_encoder=None, text_encoder_2=None, torch_dtype=torch.bfloat16
... ).to(device)

>>> image = load_image(
...     "https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/style_ziggy/img5.png"
... )
>>> pipe_prior_output = pipe_prior_redux(image)
>>> images = pipe(
...     guidance_scale=2.5,
...     num_inference_steps=50,
...     generator=torch.Generator("cpu").manual_seed(0),
...     **pipe_prior_output,
... ).images
>>> images[0].save("flux-redux.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxFillPipeline
classe diffusers.FluxFillPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModel )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux Fill para inpainting/outpainting de imagens.
Referência: https://blackforestlabs.ai/flux-1-tools/
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneimage: typing.Optional[torch.FloatTensor] = Nonemask_image: typing.Optional[torch.FloatTensor] = Nonemasked_image_latents: typing.Optional[torch.FloatTensor] = Noneheight: int | None = Nonewidth: int | None = Nonestrength: float = 1.0num_inference_steps: int = 50sigmas: list[float] | None = Noneguidance_scale: float = 30.0num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512 ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens a ser usado como ponto de partida. Para arrays numpy e tensors pytorch, o intervalo de valores esperado é entre[0, 1]Se for um tensor ou uma lista de tensors, a forma esperada deve ser(B, C, H, W)ou(C, H, W). Se for um array numpy ou uma lista de arrays, a forma esperada deve ser(B, H, W, C)ou(H, W, C). - mask_image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens para mascararimage. Os pixels brancos na máscara são repintados, enquanto os pixels pretos são preservados. Semask_imagefor uma imagem PIL, ela é convertida para um único canal (luminância) antes do uso. Se for um array numpy ou tensor pytorch, deve conter um único canal de cor (L) em vez de 3, portanto a forma esperada para um tensor pytorch seria(B, 1, H, W),(B, H, W),(1, H, W),(H, W). E para um array numpy seria(B, H, W, 1),(B, H, W),(H, W, 1)ou(H, W). - masked_image_latents (
torch.Tensor,list[torch.Tensor]) —Tensorque representa um lote de imagens para mascarar aimagegerada pelo VAE. Se não for fornecido, o tensor de latentes da máscara será gerado pormask_image. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - strength (
float, opcional, padrão 1.0) — Indica o grau de transformação daimagede referência. Deve estar entre 0 e 1. Aimageé usada como ponto de partida e mais ruído é adicionado quanto maior for ostrength. O número de etapas de desruidamento depende da quantidade de ruído inicialmente adicionada. Quandostrengthé 1, o ruído adicionado é máximo e o processo de desruidamento é executado pelo número total de iterações especificado emnum_inference_steps. Um valor de 1 essencialmente ignora aimage. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 30.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import FluxFillPipeline
>>> from diffusers.utils import load_image

>>> image = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/cup.png")
>>> mask = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/cup_mask.png")

>>> pipe = FluxFillPipeline.from_pretrained("black-forest-labs/FLUX.1-Fill-dev", torch_dtype=torch.bfloat16)
>>> pipe.enable_model_cpu_offload()  # save some VRAM by offloading the model to CPU

>>> image = pipe(
...     prompt="a white paper cup",
...     image=image,
...     mask_image=mask,
...     height=1632,
...     width=1232,
...     guidance_scale=30,
...     num_inference_steps=50,
...     max_sequence_length=512,
...     generator=torch.Generator("cpu").manual_seed(0),
... ).images[0]
>>> image.save("flux_fill.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxKontextPipeline
classe diffusers.FluxKontextPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModelimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = None )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux Kontext para geração de imagem para imagem e texto para imagem.
Referência: https://bfl.ai/announcements/flux-1-kontext-dev
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneprompt: str | list[str] = Noneprompt_2: str | list[str] | None = Nonenegative_prompt: str | list[str] = Nonenegative_prompt_2: str | list[str] | None = Nonetrue_cfg_scale: float = 1.0height: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 3.5num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Nonenegative_ip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512max_area: int = 1048576_auto_resize: bool = True ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens a ser usado como ponto de partida. Para arrays numpy e tensors pytorch, o intervalo de valores esperado é entre[0, 1]Se for um tensor ou uma lista de tensors, a forma esperada deve ser(B, C, H, W)ou(C, H, W). Se for um array numpy ou uma lista de arrays, a forma esperada deve ser(B, H, W, C)ou(H, W, C)Também pode aceitar latentes de imagem comoimage, mas, se latentes forem passados diretamente, eles não são codificados novamente. - prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Se não for definido, é necessário passarnegative_prompt_embedsem vez disso. Ignorado quando não se usa orientação (ou seja, ignorado setrue_cfg_scalenão for maior que1). - negative_prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados paratokenizer_2etext_encoder_2. Se não definido,negative_prompté usado em todos os text-encoders. - true_cfg_scale (
float, opcional, padrão 1.0) — Quando > 1.0 e umnegative_prompté fornecido, habilita a orientação livre de classificador verdadeira. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 3,5) — A escala de orientação embutida é ativada ao definirguidance_scale> 1. Valores maiores deguidance_scaleincentivam o modelo a gerar imagens mais alinhadas ao prompt, em detrimento de uma menor qualidade de imagem.Modelos destilados por orientação aproximam a orientação livre de classificador verdadeira para
guidance_scale> 1. Consulte o artigo para saber mais. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - ip_adapter_image — (
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_ip_adapter_image —
(
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - negative_ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto negativas pré-geradas. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não for fornecido, negative_prompt_embeds será gerado a partir do argumento de entradanegative_prompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompt. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entradanegative_prompt. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt. - max_area (
int, padrão1024 ** 2) — A área máxima da imagem gerada em pixels. A altura e a largura serão ajustadas para caber nessa área, mantendo a proporção. - _auto_resize (
bool, opcional, padrãoTrue) — Se a imagem de entrada deve ser redimensionada automaticamente para as resoluções preferidas.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import FluxKontextPipeline
>>> from diffusers.utils import load_image

>>> pipe = FluxKontextPipeline.from_pretrained(
...     "black-forest-labs/FLUX.1-Kontext-dev", torch_dtype=torch.bfloat16
... )
>>> pipe.to("cuda")

>>> image = load_image(
...     "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/yarn-art-pikachu.png"
... ).convert("RGB")
>>> prompt = "Make Pikachu hold a sign that says 'Black Forest Labs is awesome', yarn art style, detailed, vibrant colors"
>>> image = pipe(
...     image=image,
...     prompt=prompt,
...     guidance_scale=2.5,
...     generator=torch.Generator().manual_seed(42),
... ).images[0]
>>> image.save("output.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.
FluxKontextInpaintPipeline
classe diffusers.FluxKontextInpaintPipeline
< source >( scheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModeltokenizer: CLIPTokenizertext_encoder_2: T5EncoderModeltokenizer_2: T5Tokenizertransformer: FluxTransformer2DModelimage_encoder: CLIPVisionModelWithProjection = Nonefeature_extractor: CLIPImageProcessorPil = None )
Parâmetros
- transformer (FluxTransformer2DModel) — Arquitetura de Transformer condicional (MMDiT) para desruidar os latentes da imagem codificada.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- text_encoder (
CLIPTextModel) — CLIP, especificamente a variante clip-vit-large-patch14. - text_encoder_2 (
T5EncoderModel) — T5, especificamente a variante google/t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - tokenizer_2 (
T5TokenizerFast) — Segundo Tokenizer da classe T5TokenizerFast.
O pipeline Flux Kontext para geração de imagens a partir de texto.
Referência: https://blackforestlabs.ai/announcing-black-forest-labs/
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneimage_reference: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Nonemask_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]] = Noneprompt: str | list[str] = Noneprompt_2: str | list[str] | None = Nonenegative_prompt: str | list[str] = Nonenegative_prompt_2: str | list[str] | None = Nonetrue_cfg_scale: float = 1.0height: int | None = Nonewidth: int | None = Nonestrength: float = 1.0padding_mask_crop: int | None = Nonenum_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 3.5num_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Nonenegative_ip_adapter_image_embeds: list[torch.Tensor] | None = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 512max_area: int = 1048576_auto_resize: bool = True ) → ~pipelines.flux.FluxPipelineOutput or tuple
Parâmetros
- image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens a ser inpaintado (quais partes da imagem devem ser mascaradas commask_imagee repintadas de acordo comprompteimage_reference). Para arrays numpy e tensors pytorch, o intervalo de valores esperado é entre[0, 1]Se for um tensor ou uma lista de tensors, a forma esperada deve ser(B, C, H, W)ou(C, H, W). Se for um array numpy ou uma lista de arrays, a forma esperada deve ser(B, H, W, C)ou(H, W, C)Também pode aceitar latentes de imagem comoimage, mas, se latentes forem passados diretamente, eles não são codificados novamente. - image_reference (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image], orlist[np.ndarray]) —Image, numpy array or tensor representing an image batch to be used as the starting point for the masked area. For both numpy array and pytorch tensor, the expected value range is between[0, 1]If it’s a tensor or a list or tensors, the expected shape should be(B, C, H, W)or(C, H, W)If it is a numpy array or a list of arrays, the expected shape should be(B, H, W, C)or(H, W, C)It can also accept image latents asimage, but if passing latents directly it is not encoded again. - mask_image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Image, array numpy ou tensor representando um lote de imagens para mascararimage. Os pixels brancos na máscara são repintados, enquanto os pixels pretos são preservados. Semask_imagefor uma imagem PIL, ela é convertida para um único canal (luminância) antes do uso. Se for um array numpy ou tensor pytorch, deve conter um único canal de cor (L) em vez de 3, portanto a forma esperada para um tensor pytorch seria(B, 1, H, W),(B, H, W),(1, H, W),(H, W). E para um array numpy seria(B, H, W, 1),(B, H, W),(H, W, 1)ou(H, W). - prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se não for definido, é necessário passarprompt_embedsem vez disso. - prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts a serem enviados paratokenizer_2etext_encoder_2. Se não definido,promptserá usado no lugar. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Se não for definido, é necessário passarnegative_prompt_embedsem vez disso. Ignorado quando não se usa orientação (ou seja, ignorado setrue_cfg_scalenão for maior que1). - negative_prompt_2 (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem a serem enviados paratokenizer_2etext_encoder_2. Se não definido,negative_prompté usado em todos os text-encoders. - true_cfg_scale (
float, opcional, padrão 1.0) — A orientação livre de classificador verdadeira (escala de orientação) é ativada quandotrue_cfg_scale> 1 enegative_prompté fornecido. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - strength (
float, opcional, padrão 1.0) — Indica o grau de transformação daimagede referência. Deve estar entre 0 e 1. Aimageé usada como ponto de partida e mais ruído é adicionado quanto maior for ostrength. O número de etapas de desruidamento depende da quantidade de ruído inicialmente adicionada. Quandostrengthé 1, o ruído adicionado é máximo e o processo de desruidamento é executado pelo número total de iterações especificado emnum_inference_steps. Um valor de 1 essencialmente ignora aimage. - padding_mask_crop (
int, opcional, padrãoNone) — O tamanho da margem no recorte a ser aplicado à imagem e à máscara. SeNone, nenhum recorte é aplicado à imagem e à mask_image. Sepadding_mask_cropnão forNone, primeiro será encontrada uma região retangular com a mesma proporção da imagem e que contenha toda a área mascarada, e então essa área será expandida com base empadding_mask_crop. A imagem e a mask_image serão então recortadas com base na área expandida antes do redimensionamento para o tamanho original da imagem para o inpainting. Isso é útil quando a área mascarada é pequena, enquanto a imagem é grande e contém informações irrelevantes para o inpainting, como o fundo. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar no processo de desruidamento com agendadores que suportam um argumentosigmasem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. - guidance_scale (
float, opcional, padrão 3,5) — A escala de orientação embutida é ativada ao definirguidance_scale> 1. Valores maiores deguidance_scaleincentivam o modelo a gerar imagens mais alinhadas com opromptem detrimento de uma menor qualidade de imagem.Modelos destilados por orientação aproximam a orientação livre de classificador verdadeira para
guidance_scale> 1. Consulte o artigo para saber mais. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - ip_adapter_image — (
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_ip_adapter_image —
(
PipelineImageInput, opcional): Entrada de imagem opcional para trabalhar com IP Adapters. - negative_ip_adapter_image_embeds (
list[torch.Tensor], opcional) — Incorporações de imagem pré-geradas para IP-Adapter. Deve ser uma lista com o mesmo comprimento que o número de IP-adapters. Cada elemento deve ser um tensor com a forma(batch_size, num_images, emb_dim). Se não for fornecido, as incorporações são calculadas a partir do argumento de entradaip_adapter_image. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto negativas pré-geradas. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não for fornecido, negative_prompt_embeds será gerado a partir do argumento de entradanegative_prompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto negativo pré-gerados. Pode ser usado para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompt. Se não for fornecido, os pooled negative_prompt_embeds serão gerados a partir do argumento de entradanegative_prompt. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - joint_attention_kwargs (
dict, opcional) — Um dicionário de kwargs que, se especificado, é passado aoAttentionProcessorconforme definido emself.processorem diffusers.models.attention_processor. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline. - max_sequence_length (
intpadrão 512) — Comprimento máximo da sequência a ser usado com oprompt. - max_area (
int, padrão1024 ** 2) — A área máxima da imagem gerada em pixels. A altura e a largura serão ajustadas para caber nessa área, mantendo a proporção. - _auto_resize (
bool, opcional, padrãoTrue) — Se a imagem de entrada deve ser redimensionada automaticamente para as resoluções preferidas.
Retorna
~pipelines.flux.FluxPipelineOutput ou tuple
~pipelines.flux.FluxPipelineOutput se return_dict
for True, caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
Inpainting apenas com texto
>>> import torch
>>> from diffusers import FluxKontextInpaintPipeline
>>> from diffusers.utils import load_image

>>> prompt = "Change the yellow dinosaur to green one"
>>> img_url = (
...     "https://github.com/ZenAI-Vietnam/Flux-Kontext-pipelines/blob/main/assets/dinosaur_input.jpeg?raw=true"
... )
>>> mask_url = (
...     "https://github.com/ZenAI-Vietnam/Flux-Kontext-pipelines/blob/main/assets/dinosaur_mask.png?raw=true"
... )

>>> source = load_image(img_url)
>>> mask = load_image(mask_url)

>>> pipe = FluxKontextInpaintPipeline.from_pretrained(
...     "black-forest-labs/FLUX.1-Kontext-dev", torch_dtype=torch.bfloat16
... )
>>> pipe.to("cuda")

>>> image = pipe(prompt=prompt, image=source, mask_image=mask, strength=1.0).images[0]
>>> image.save("kontext_inpainting_normal.png")
Inpainting com condicionamento por imagem
>>> import torch
>>> from diffusers import FluxKontextInpaintPipeline
>>> from diffusers.utils import load_image

>>> pipe = FluxKontextInpaintPipeline.from_pretrained(
...     "black-forest-labs/FLUX.1-Kontext-dev", torch_dtype=torch.bfloat16
... )
>>> pipe.to("cuda")

>>> prompt = "Replace this ball"
>>> img_url = "https://images.pexels.com/photos/39362/the-ball-stadion-football-the-pitch-39362.jpeg?auto=compress&cs=tinysrgb&dpr=1&w=500"
>>> mask_url = (
...     "https://github.com/ZenAI-Vietnam/Flux-Kontext-pipelines/blob/main/assets/ball_mask.png?raw=true"
... )
>>> image_reference_url = (
...     "https://encrypted-tbn0.gstatic.com/images?q=tbn:ANd9GcTah3x6OL_ECMBaZ5ZlJJhNsyC-OSMLWAI-xw&s"
... )

>>> source = load_image(img_url)
>>> mask = load_image(mask_url)
>>> image_reference = load_image(image_reference_url)

>>> mask = pipe.mask_processor.blur(mask, blur_factor=12)
>>> image = pipe(
...     prompt=prompt, image=source, mask_image=mask, image_reference=image_reference, strength=1.0
... ).images[0]
>>> image.save("kontext_inpainting_ref.png")
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str] | None = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonemax_sequence_length: int = 512lora_scale: float | None = None )
Parâmetros
- prompt (
stroulist[str], opcional) — prompt a ser codificado - prompt_2 (
stroulist[str], opcional) — O prompt ou prompts a serem enviados para otokenizer_2e otext_encoder_2. Se não definido,prompté usado em todos os text-encoders - device — (
torch.device): dispositivo torch - num_images_per_prompt (
int) — número de imagens que devem ser geradas por prompt - prompt_embeds (
torch.FloatTensor, opcional) — Incorporações de texto pré-geradas. Podem ser usadas para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não forem fornecidas, as incorporações de texto serão geradas a partir do argumento de entradaprompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Embeddings de texto agrupados pré-gerados. Podem ser usados para ajustar facilmente as entradas de texto, por exemplo, ponderação de prompts. Se não fornecidos, os embeddings de texto agrupados serão gerados a partir do argumento de entradaprompt. - lora_scale (
float, opcional) — Uma escala LoRA que será aplicada a todas as camadas LoRA do codificador de texto, caso as camadas LoRA sejam carregadas.