
Diffusers documentation
PixArt-Σ
PixArt-Σ
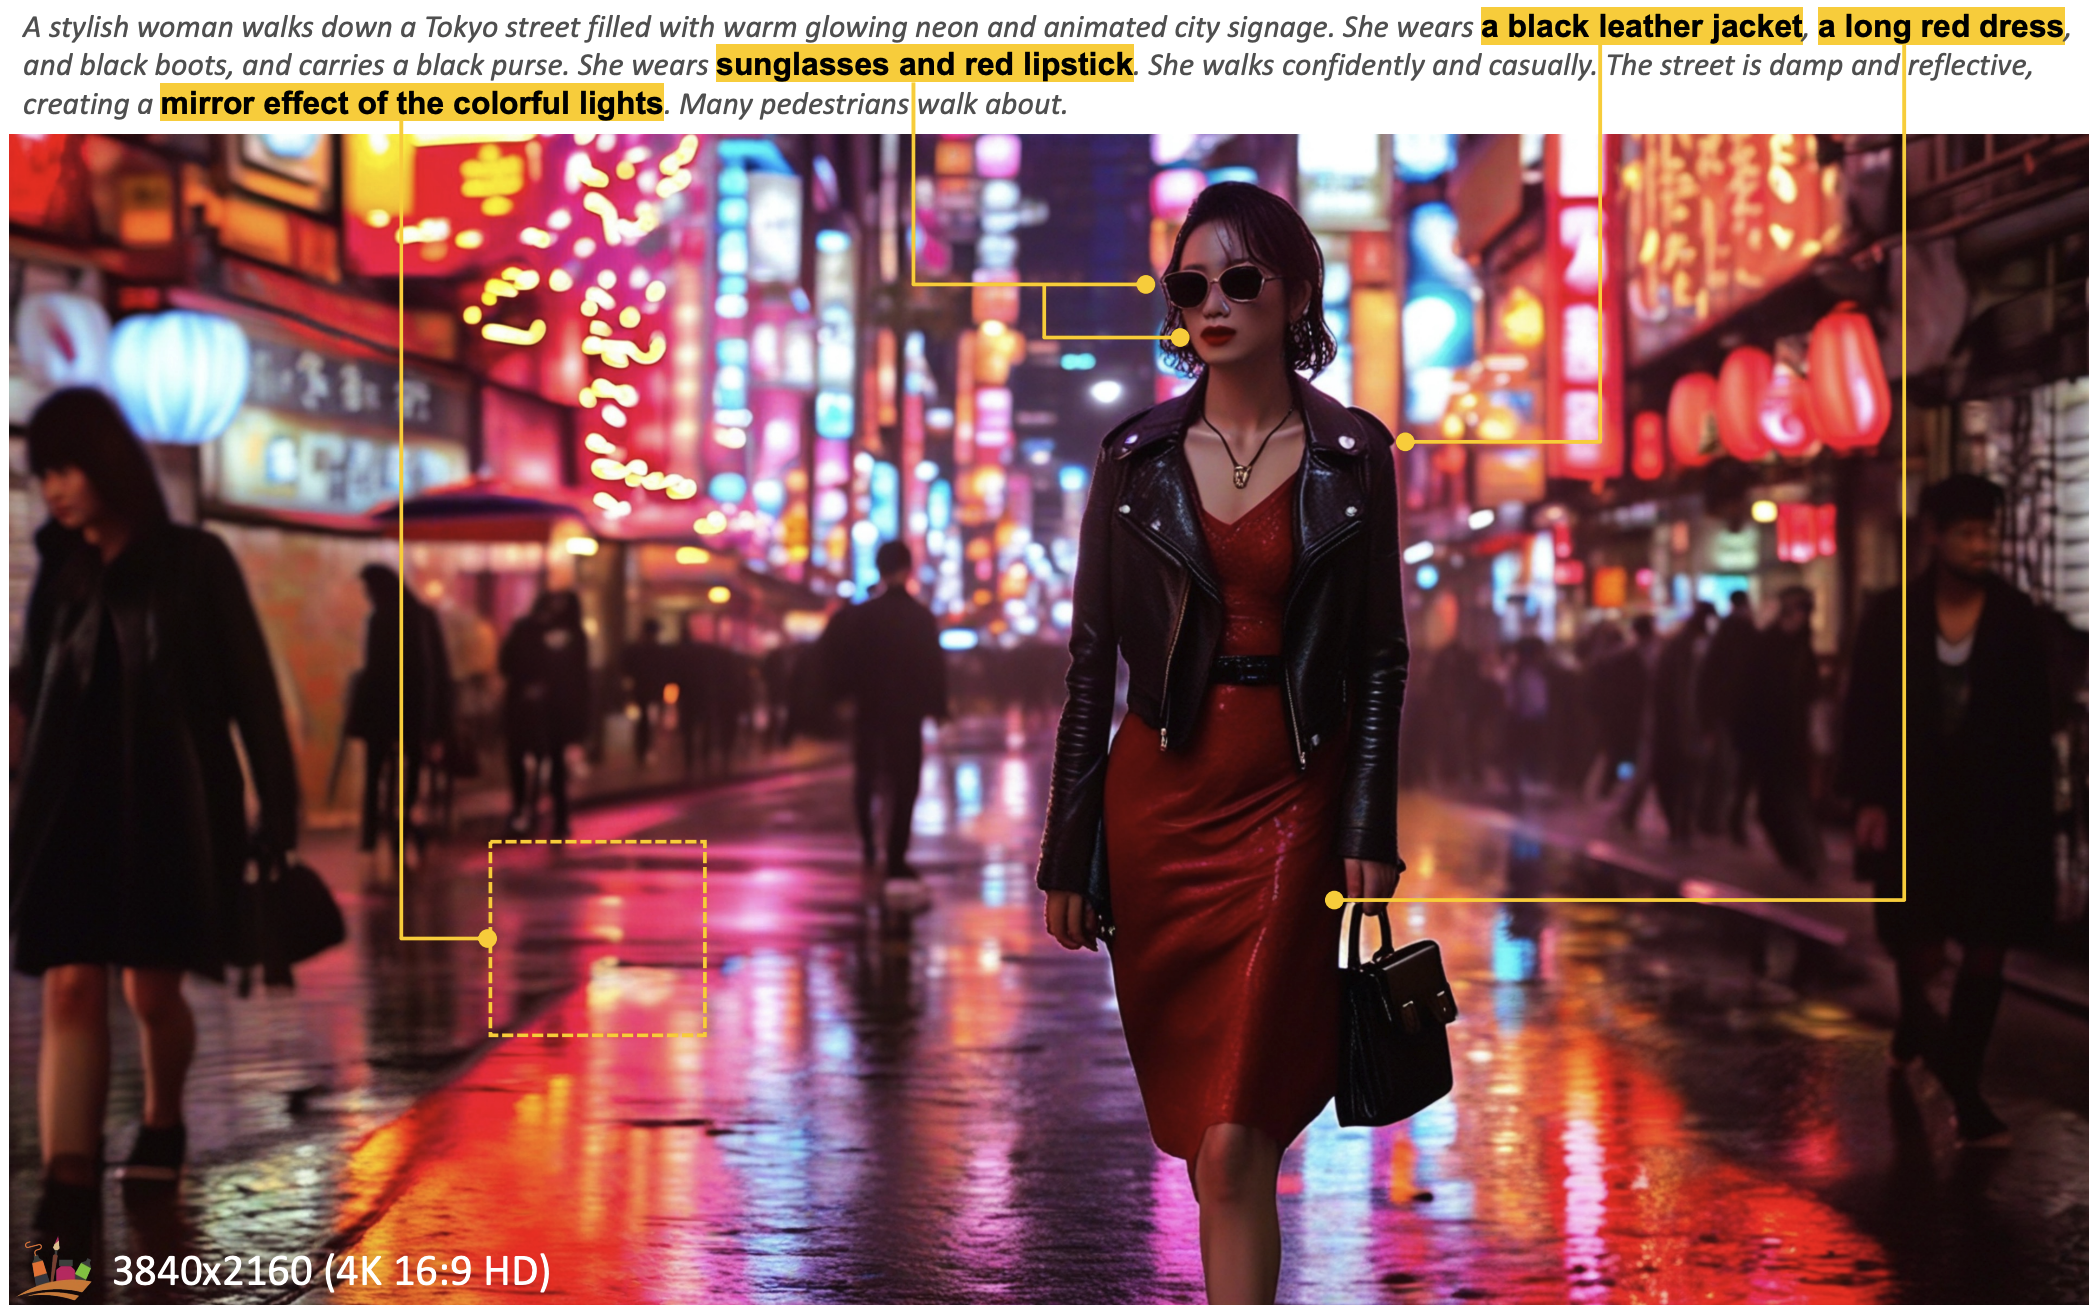
PixArt-Σ: Weak-to-Strong Training of Diffusion Transformer for 4K Text-to-Image Generation adalah karya Junsong Chen, Jincheng Yu, Chongjian Ge, Lewei Yao, Enze Xie, Yue Wu, Zhongdao Wang, James Kwok, Ping Luo, Huchuan Lu, dan Zhenguo Li.
Abstrak dari makalah tersebut adalah:
Dalam makalah ini, kami memperkenalkan PixArt-Σ, sebuah model Diffusion Transformer (DiT) yang mampu menghasilkan gambar langsung pada resolusi 4K. PixArt-Σ merupakan kemajuan signifikan dibandingkan pendahulunya, PixArt-α, dengan menawarkan gambar yang memiliki fidelitas jauh lebih tinggi dan keselarasan yang lebih baik dengan prompt teks. Salah satu fitur utama PixArt-Σ adalah efisiensi pelatihannya. Dengan memanfaatkan pra-pelatihan dasar dari PixArt-α, model ini berkembang dari baseline yang ‘lebih lemah’ menjadi model yang ‘lebih kuat’ melalui penggabungan data berkualitas lebih tinggi, sebuah proses yang kami sebut “weak-to-strong training”. Kemajuan pada PixArt-Σ bersifat dua arah: (1) Data Pelatihan Berkualitas Tinggi: PixArt-Σ mengintegrasikan data gambar dengan kualitas yang lebih unggul, yang dipasangkan dengan caption gambar yang lebih presisi dan detail. (2) Kompresi Token yang Efisien: kami mengusulkan modul perhatian baru dalam kerangka DiT yang mengompresi baik keys maupun values, sehingga secara signifikan meningkatkan efisiensi dan memfasilitasi generasi gambar beresolusi ultra-tinggi. Berkat peningkatan-peningkatan ini, PixArt-Σ mencapai kualitas gambar dan kemampuan kepatuhan terhadap prompt pengguna yang lebih unggul dengan ukuran model yang jauh lebih kecil (0,6B parameter) dibandingkan model difusi teks-ke-gambar yang ada, seperti SDXL (2,6B parameter) dan SD Cascade (5,1B parameter). Selain itu, kemampuan PixArt-Σ untuk menghasilkan gambar 4K mendukung pembuatan poster dan wallpaper beresolusi tinggi, yang secara efisien memperkuat produksi konten visual berkualitas tinggi di industri seperti film dan game.
Anda dapat menemukan basis kode asli di PixArt-alpha/PixArt-sigma dan semua checkpoint yang tersedia di PixArt-alpha.
Beberapa catatan tentang pipeline ini:
- Model ini menggunakan tulang punggung Transformer (bukan UNet) untuk denoising. Dengan demikian, arsitekturnya serupa dengan DiT.
- Model ini dilatih menggunakan kondisi teks yang dihitung dari T5. Aspek ini membuat pipeline lebih baik dalam mengikuti prompt teks kompleks dengan detail yang rumit.
- Model ini sangat baik dalam menghasilkan gambar resolusi tinggi dengan berbagai rasio aspek. Untuk mendapatkan hasil terbaik, para penulis merekomendasikan beberapa rentang ukuran yang dapat ditemukan di sini.
- Kualitasnya menyaingi sistem generasi teks-ke-gambar terkini (per penulisan ini) seperti PixArt-α, Stable Diffusion XL, Playground V2.0, dan DALL-E 3, sekaligus lebih efisien daripada sistem-sistem tersebut.
- Hal ini menunjukkan kemampuannya untuk menghasilkan gambar dengan resolusi sangat tinggi, seperti 2048px atau bahkan 4K.
- Hal ini menunjukkan bahwa model teks-ke-gambar dapat berkembang dari model yang lemah menjadi model yang lebih kuat melalui beberapa peningkatan (VAE, dataset, dan sebagainya.)
Pastikan untuk melihat panduan Schedulers untuk mempelajari cara mengeksplorasi tradeoff antara kecepatan dan kualitas scheduler, serta lihat bagian reuse components across pipelines untuk mempelajari cara memuat komponen yang sama secara efisien ke dalam beberapa pipeline.
Anda dapat meningkatkan kualitas generasi lebih lanjut dengan meneruskan gambar yang dihasilkan dari PixArtSigmaPipeline ke model SDXL refiner.
Inferensi dengan VRAM GPU di bawah 8GB
Jalankan PixArtSigmaPipeline dengan VRAM GPU di bawah 8GB dengan memuat text encoder dalam presisi 8-bit. Mari kita lihat contoh lengkap.
Pertama, instal pustaka bitsandbytes:
pip install -U bitsandbytes
Lalu muat text encoder dalam 8-bit:
from transformers import T5EncoderModel
from diffusers import PixArtSigmaPipeline
import torch

text_encoder = T5EncoderModel.from_pretrained(
    "PixArt-alpha/PixArt-Sigma-XL-2-1024-MS",
    subfolder="text_encoder",
    load_in_8bit=True,
    device_map="auto",
)
pipe = PixArtSigmaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-Sigma-XL-2-1024-MS",
    text_encoder=text_encoder,
    transformer=None,
    device_map="balanced"
)
Sekarang, gunakan pipe untuk mengkodekan prompt:
with torch.no_grad():
    prompt = "cute cat"
    prompt_embeds, prompt_attention_mask, negative_embeds, negative_prompt_attention_mask = pipe.encode_prompt(prompt)
Karena embedding teks telah dihitung, hapus text_encoder dan pipe dari memori, dan bebaskan sebagian VRAM GPU:
import gc

def flush():
    gc.collect()
    torch.cuda.empty_cache()

del text_encoder
del pipe
flush()
Lalu hitung latents dengan prompt embeddings sebagai input:
pipe = PixArtSigmaPipeline.from_pretrained(
    "PixArt-alpha/PixArt-Sigma-XL-2-1024-MS",
    text_encoder=None,
    dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"

latents = pipe(
    negative_prompt=None,
    prompt_embeds=prompt_embeds,
    negative_prompt_embeds=negative_embeds,
    prompt_attention_mask=prompt_attention_mask,
    negative_prompt_attention_mask=negative_prompt_attention_mask,
    num_images_per_prompt=1,
    output_type="latent",
).images

del pipe.transformer
flush()
Perhatikan bahwa saat menginisialisasi
pipe, Anda mengaturtext_encodermenjadiNoneagar tidak dimuat.
Setelah latents dihitung, teruskan ke VAE untuk didekode menjadi gambar nyata:
with torch.no_grad():
    image = pipe.vae.decode(latents / pipe.vae.config.scaling_factor, return_dict=False)[0]
image = pipe.image_processor.postprocess(image, output_type="pil")[0]
image.save("cat.png")
Dengan menghapus komponen yang tidak Anda gunakan dan mengosongkan VRAM GPU, Anda seharusnya dapat menjalankan PixArtSigmaPipeline dengan VRAM GPU di bawah 8GB.
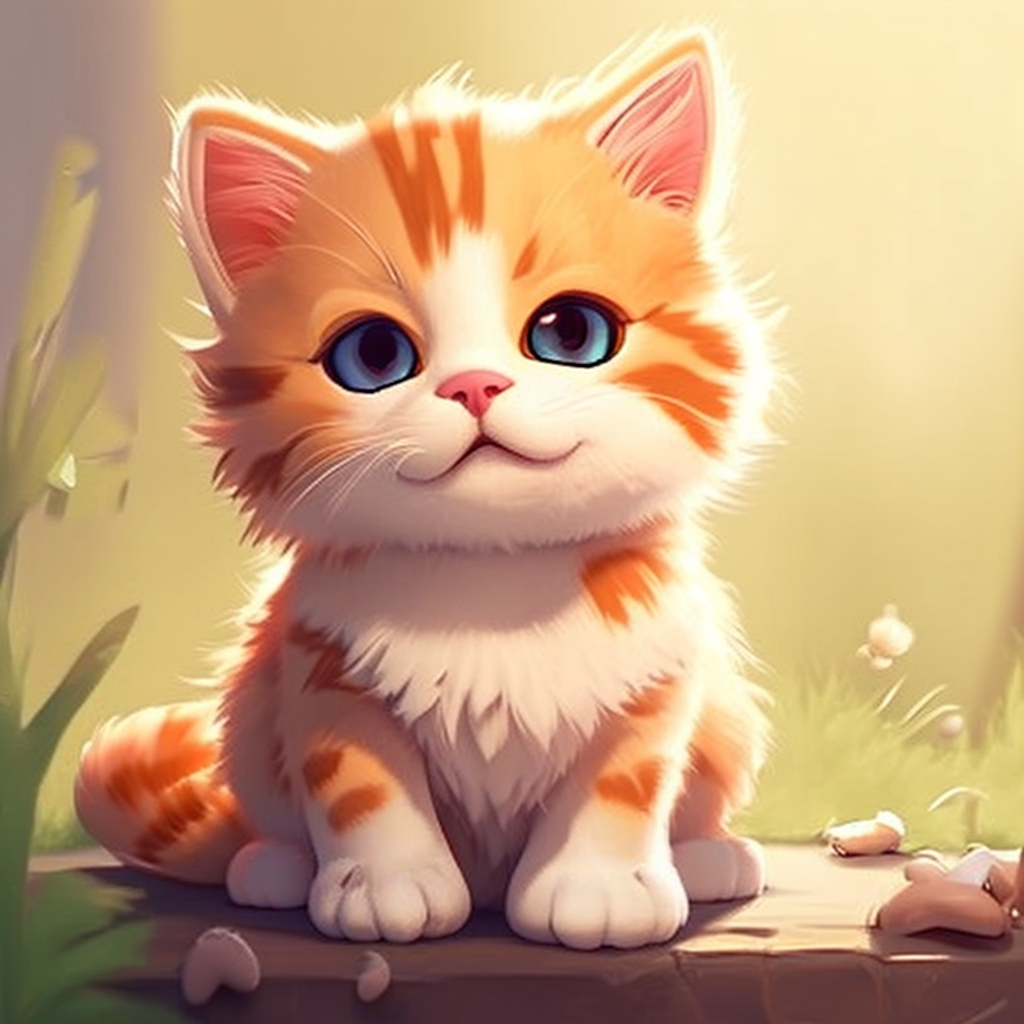
Jika Anda ingin laporan penggunaan memori, jalankan skrip ini.
Embedding teks yang dihitung dalam 8-bit dapat memengaruhi kualitas gambar yang dihasilkan karena hilangnya informasi di ruang representasi yang disebabkan oleh presisi yang lebih rendah. Disarankan untuk membandingkan output dengan dan tanpa 8-bit.
Saat memuat text_encoder, Anda mengatur load_in_8bit ke True. Anda juga dapat menentukan load_in_4bit untuk menurunkan kebutuhan memori Anda lebih jauh hingga di bawah 7GB.
PixArtSigmaPipeline
kelas diffusers.PixArtSigmaPipeline
< source >( tokenizer: T5Tokenizertext_encoder: T5EncoderModelvae: AutoencoderKLtransformer: PixArtTransformer2DModelscheduler: KarrasDiffusionSchedulers )
Parameter
- vae (AutoencoderKL) — Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
- text_encoder (
T5EncoderModel) — Text-encoder yang dibekukan. PixArt-Alpha menggunakan T5, khususnya varian t5-v1_1-xxl. - tokenizer (
T5Tokenizer) — Tokenizer dari kelas T5Tokenizer. - transformer (PixArtTransformer2DModel) —
PixArtTransformer2DModelyang dikondisikan teks untuk mendenois latens gambar yang terenkod. Awalnya dipublikasikan sebagaiTransformer2DModeldi config, tetapi ketidakcocokan ini dapat diabaikan. - scheduler (SchedulerMixin) —
Scheduler yang digunakan bersama
transformeruntuk menghilangkan noise pada latens gambar yang telah dikodekan.
Pipeline untuk generasi teks-ke-gambar menggunakan PixArt-Sigma.
Model ini mewarisi dari DiffusionPipeline. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua pipeline (seperti mengunduh atau menyimpan, menjalankan pada perangkat tertentu, dll.)
__call__
< source >( prompt: str | list[str] = Nonenegative_prompt: str = ''num_inference_steps: int = 20timesteps: list = Nonesigmas: list = Noneguidance_scale: float = 4.5num_images_per_prompt: int | None = 1height: int | None = Nonewidth: int | None = Noneeta: float = 0.0generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1clean_caption: bool = Trueuse_resolution_binning: bool = Truemax_sequence_length: int = 300**kwargs ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt untuk mengarahkan generasi gambar. Jika tidak didefinisikan, Anda harus meneruskanprompt_embedssebagai gantinya. - negative_prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt yang tidak digunakan untuk mengarahkan generasi gambar. Jika tidak didefinisikan, Anda harus meneruskannegative_prompt_embedssebagai gantinya. Diabaikan jika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). - num_inference_steps (
int, opsional, default 100) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - timesteps (
list[int], opsional) — Timesteps kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumentimestepsdi metodeset_timestepsmereka. Jika tidak didefinisikan, perilaku default saatnum_inference_stepsdilewatkan akan digunakan. Harus dalam urutan menurun. - sigmas (
list[float], opsional) — Sigmas kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumensigmasdalam metodeset_timestepsmereka. Jika tidak didefinisikan, perilaku default saatnum_inference_stepsditeruskan akan digunakan. - guidance_scale (
float, opsional, default 4.5) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - height (
int, opsional, defaultnya self.unet.config.sample_size) — Tinggi gambar yang dihasilkan dalam piksel. - width (
int, opsional, defaultnya self.unet.config.sample_size) — Lebar gambar yang dihasilkan dalam piksel. - eta (
float, opsional, default 0.0) — Bersesuaian dengan parameter eta (η) dalam paper DDIM: https://huggingface.co/papers/2010.02502. Hanya berlaku untuk schedulers.DDIMScheduler, akan diabaikan untuk yang lain. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - prompt_embeds (
torch.Tensor, opsional) — Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, misalnya pembobotan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen inputprompt. - prompt_attention_mask (
torch.Tensor, opsional) — Mask attention yang telah dibuat sebelumnya untuk embedding teks. - negative_prompt_embeds (
torch.Tensor, opsional) — Embedding teks negatif yang telah dibuat sebelumnya. Untuk PixArt-Sigma, prompt negatif ini harus berupa "". Jika tidak disediakan, negative_prompt_embeds akan dibuat dari argumen inputnegative_prompt. - negative_prompt_attention_mask (
torch.Tensor, opsional) — Attention mask yang telah dibuat sebelumnya untuk embedding teks negatif. - output_type (
str, opsional, defaultnya"pil") — Format output dari generate image. Pilih antara PIL:PIL.Image.Imageataunp.array. - return_dict (
bool, opsional, defaultTrue) — Apakah akan mengembalikan~pipelines.stable_diffusion.IFPipelineOutputalih-alih tuple biasa. - callback (
Callable, opsional) — Fungsi yang akan dipanggil setiapcallback_stepslangkah selama inferensi. Fungsi ini akan dipanggil dengan argumen berikut:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opsional, default 1) — Frekuensi pemanggilan fungsicallback. Jika tidak ditentukan, callback akan dipanggil di setiap langkah. - clean_caption (
bool, opsional, defaultTrue) — Apakah caption akan dibersihkan sebelum membuat embeddings. Memerlukanbeautifulsoup4danftfyuntuk diinstal. Jika dependensi tidak diinstal, embeddings akan dibuat dari prompt mentah. - use_resolution_binning (
booldefaultnyaTrue) — Jika diset keTrue, tinggi dan lebar yang diminta pertama kali dipetakan ke resolusi terdekat menggunakanASPECT_RATIO_1024_BIN. Setelah latents yang dihasilkan didekode menjadi gambar, ukuran gambar dikembalikan ke resolusi yang diminta. Berguna untuk menghasilkan gambar yang tidak persegi. - max_sequence_length (
intdefaultnya 300) — Panjang maksimum urutan yang digunakan denganprompt.
Mengembalikan
ImagePipelineOutput atau tuple
Jika return_dict adalah True, ImagePipelineOutput dikembalikan, selain itu sebuah tuple dikembalikan di mana elemen pertama adalah daftar dengan gambar yang dihasilkan
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
>>> import torch
>>> from diffusers import PixArtSigmaPipeline

>>> # You can replace the checkpoint id with "PixArt-alpha/PixArt-Sigma-XL-2-512-MS" too.
>>> pipe = PixArtSigmaPipeline.from_pretrained(
...     "PixArt-alpha/PixArt-Sigma-XL-2-1024-MS", torch_dtype=torch.float16
... )
>>> # Enable memory optimizations.
>>> # pipe.enable_model_cpu_offload()

>>> prompt = "A small cactus with a happy face in the Sahara desert."
>>> image = pipe(prompt).images[0]
encode_prompt
< source >( prompt: str | list[str]do_classifier_free_guidance: bool = Truenegative_prompt: str = ''num_images_per_prompt: int = 1device: typing.Optional[torch.device] = Noneprompt_embeds: typing.Optional[torch.Tensor] = Nonenegative_prompt_embeds: typing.Optional[torch.Tensor] = Noneprompt_attention_mask: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Noneclean_caption: bool = Falsemax_sequence_length: int = 300**kwargs )
Parameter
- prompt (
strataulist[str], opsional) — prompt yang akan dienkod - negative_prompt (
strataulist[str], opsional) — Prompt yang tidak digunakan untuk mengarahkan generasi gambar. Jika tidak didefinisikan, Anda harus meneruskannegative_prompt_embedssebagai gantinya. Diabaikan jika tidak menggunakan guidance (yaitu, diabaikan jikaguidance_scalekurang dari1). Untuk PixArt-Alpha, ini harus berupa "". - do_classifier_free_guidance (
bool, opsional, defaultTrue) — apakah akan menggunakan classifier free guidance atau tidak - num_images_per_prompt (
int, opsional, default 1) — jumlah gambar yang harus dihasilkan per prompt - device — (
torch.device, opsional): perangkat torch untuk menempatkan embedding hasil - prompt_embeds (
torch.Tensor, opsional) — Embedding teks yang sudah dibuat sebelumnya. Dapat digunakan untuk dengan mudah menyesuaikan input teks, misalnya pembobotan prompt. Jika tidak disediakan, embedding teks akan dihasilkan dari argumen inputprompt. - negative_prompt_embeds (
torch.Tensor, opsional) — Embedding teks negatif yang telah dibuat sebelumnya. Untuk PixArt-Alpha, ini seharusnya berupa embedding dari string "". - clean_caption (
bool, defaultnyaFalse) — JikaTrue, fungsi akan memproses pra dan membersihkan caption yang diberikan sebelum encoding. - max_sequence_length (
int, defaultnya 300) — Panjang maksimum urutan yang digunakan untuk prompt.
Mengkodekan prompt menjadi hidden states dari text encoder.