Diffusers documentation
IP-Adapter
IP-Adapter
IP-Adapter guide un modèle de diffusion préentraîné à l’aide d’une image de référence tout en conservant un prompt texte. Il fige le modèle de base et ajoute un petit ensemble de couches d’attention croisée image, ce qui le rend pratique pour correspondre à un sujet ou à un style issu d’une photo sans avoir à effectuer de fine-tuning.
text prompt                         reference image
    |                                     |
 text encoder                        image encoder
    |                                     |
    v                                     v
 text cross-attn  (frozen)          IP-Adapter cross-attn
    \                                     /
     \                                   /
      +-------->  denoiser  <-----------+
                  (frozen base)
Les points de contrôle IP-Adapter font généralement ~100 Mo car ils stockent les poids de l'adaptateur, et non un modèle complet. Chargez d'abord un pipeline de base, puis chargez l'adaptateur avec load_ip_adapter().
Les IP-Adapters sont disponibles pour de nombreux modèles tels que Flux et Stable Diffusion 3, entre autres. Les exemples de ce guide utilisent Stable Diffusion et Stable Diffusion XL.
Utilisez set_ip_adapter_scale() pour contrôler l'intensité avec laquelle l'IP-Adapter oriente la génération. 1.0 applique l'adaptateur à pleine intensité ; 0.5 équilibre généralement les invites texte et image.
Les exemples ci-dessous montrent IP-Adapter sur des tâches courantes.
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.8)
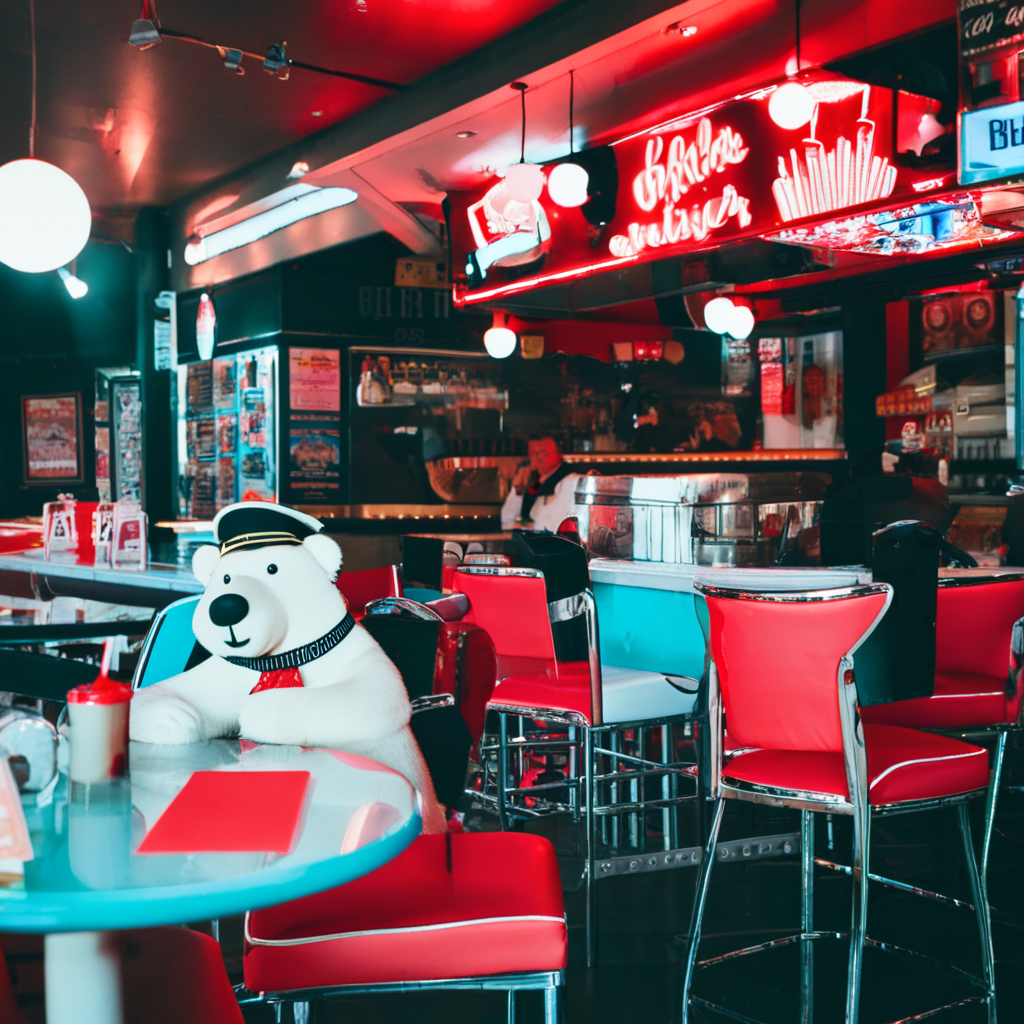
Passez une image à ip_adapter_image avec un prompt texte pour générer une image.
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_diner.png")
pipeline(
    prompt="a polar bear sitting in a chair drinking a milkshake",
    ip_adapter_image=image,
    negative_prompt="deformed, ugly, wrong proportion, low res, bad anatomy, worst quality, low quality",
).images[0]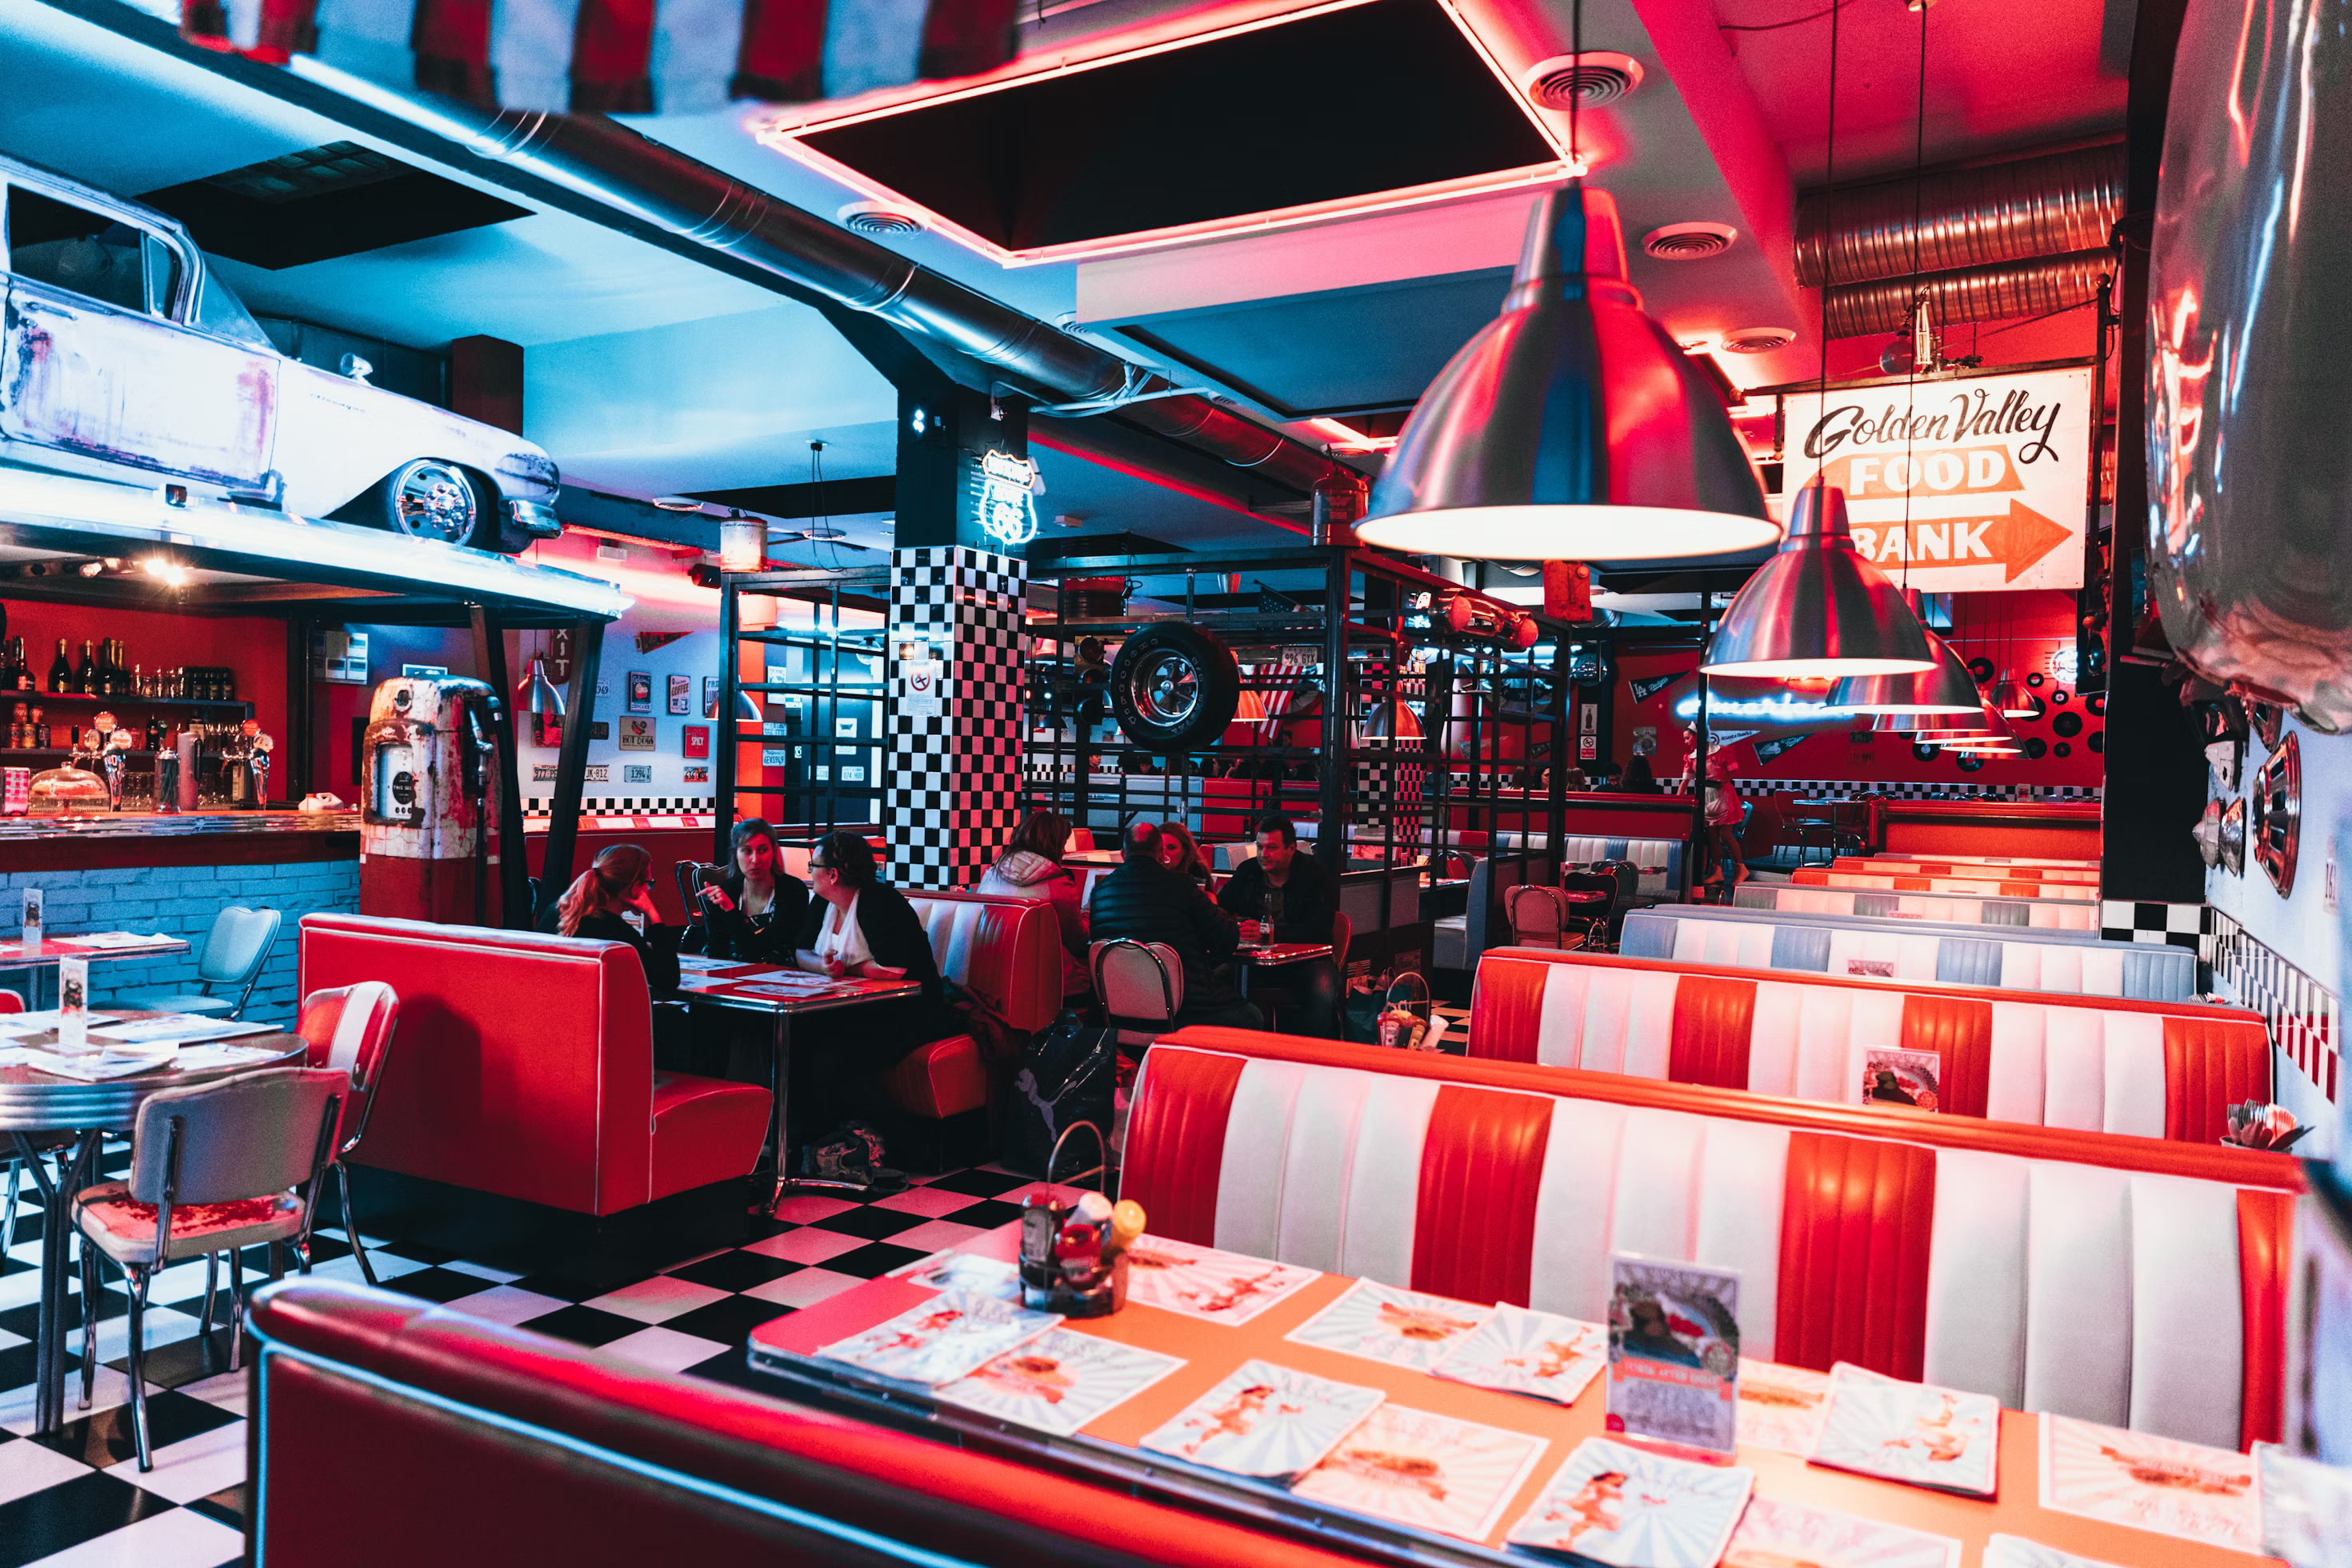
import torch
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForImage2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.8)

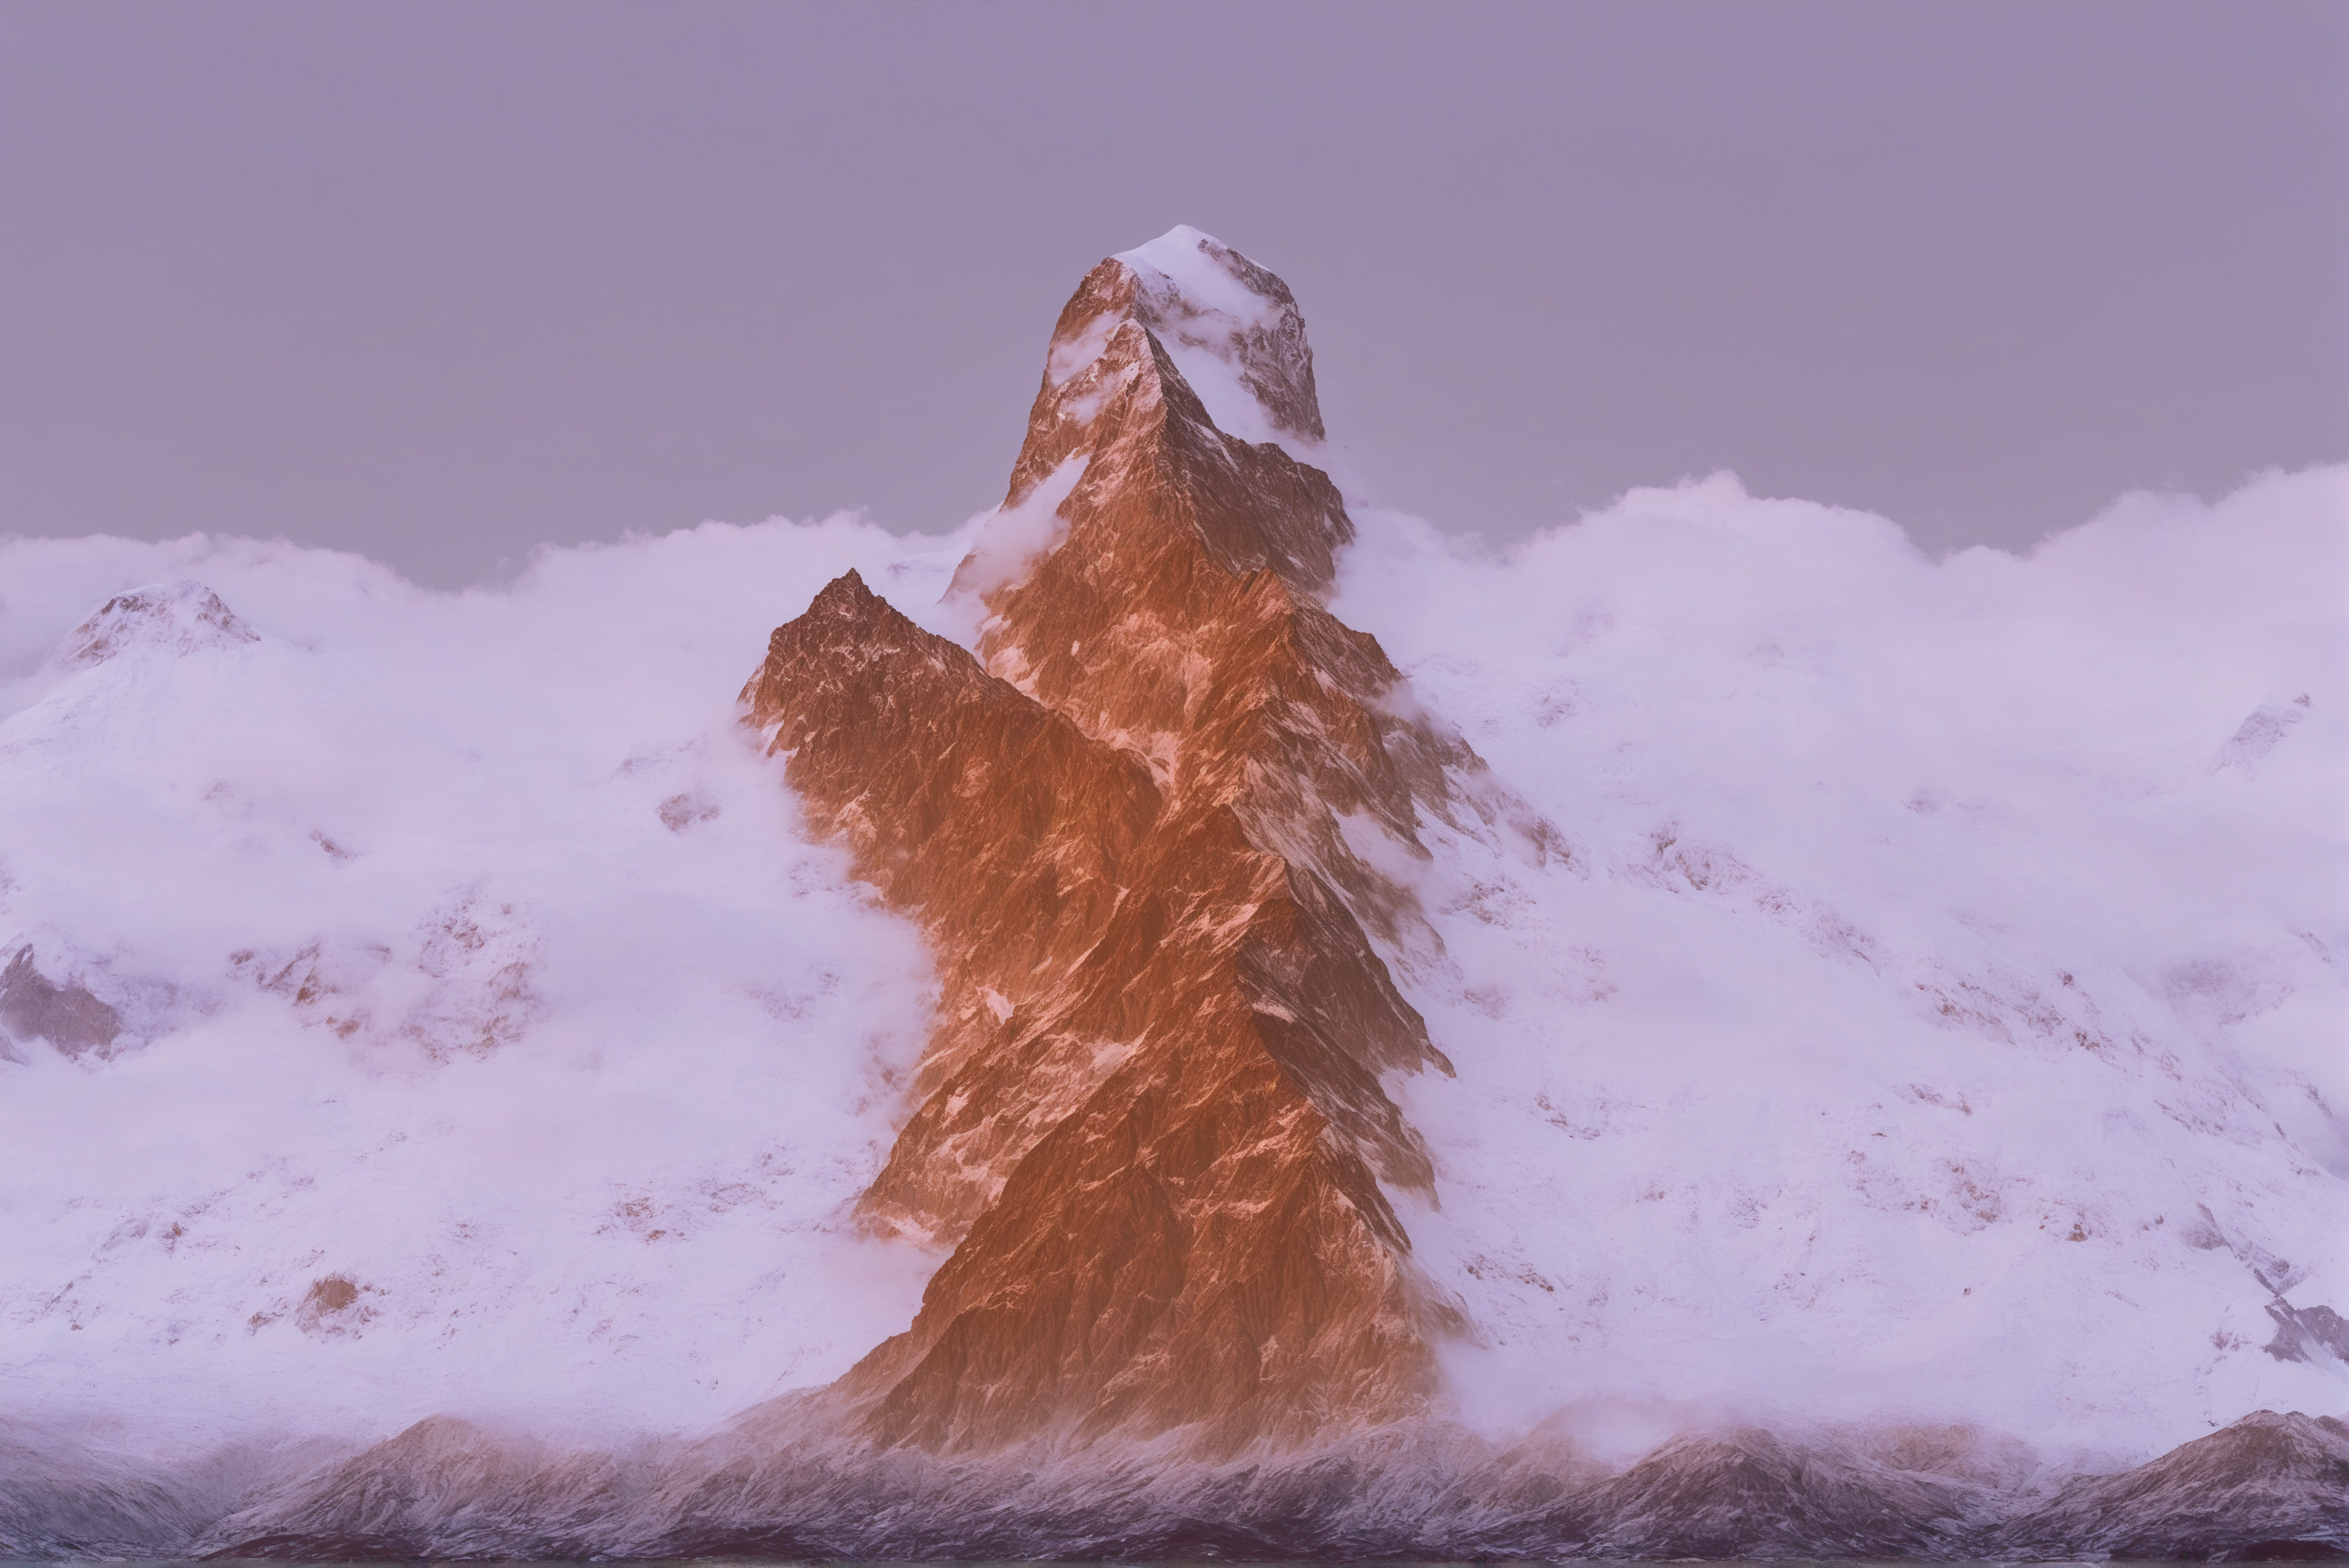
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_bear_1.png")
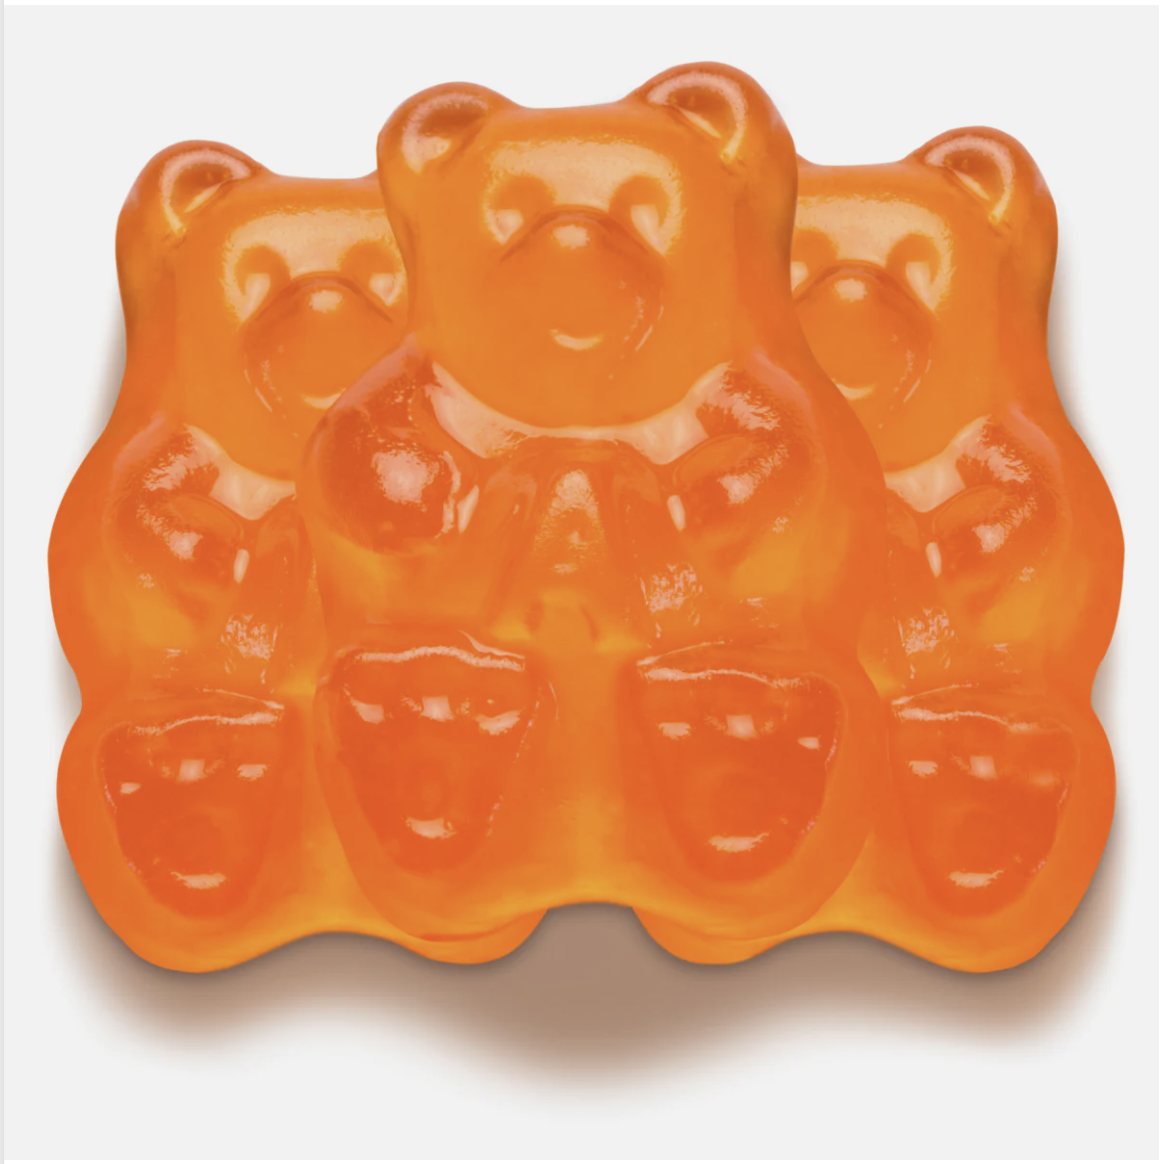
ip_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_gummy.png")
pipeline(
    prompt="best quality, high quality",
    image=image,
    ip_adapter_image=ip_image,
    strength=0.5,
).images[0]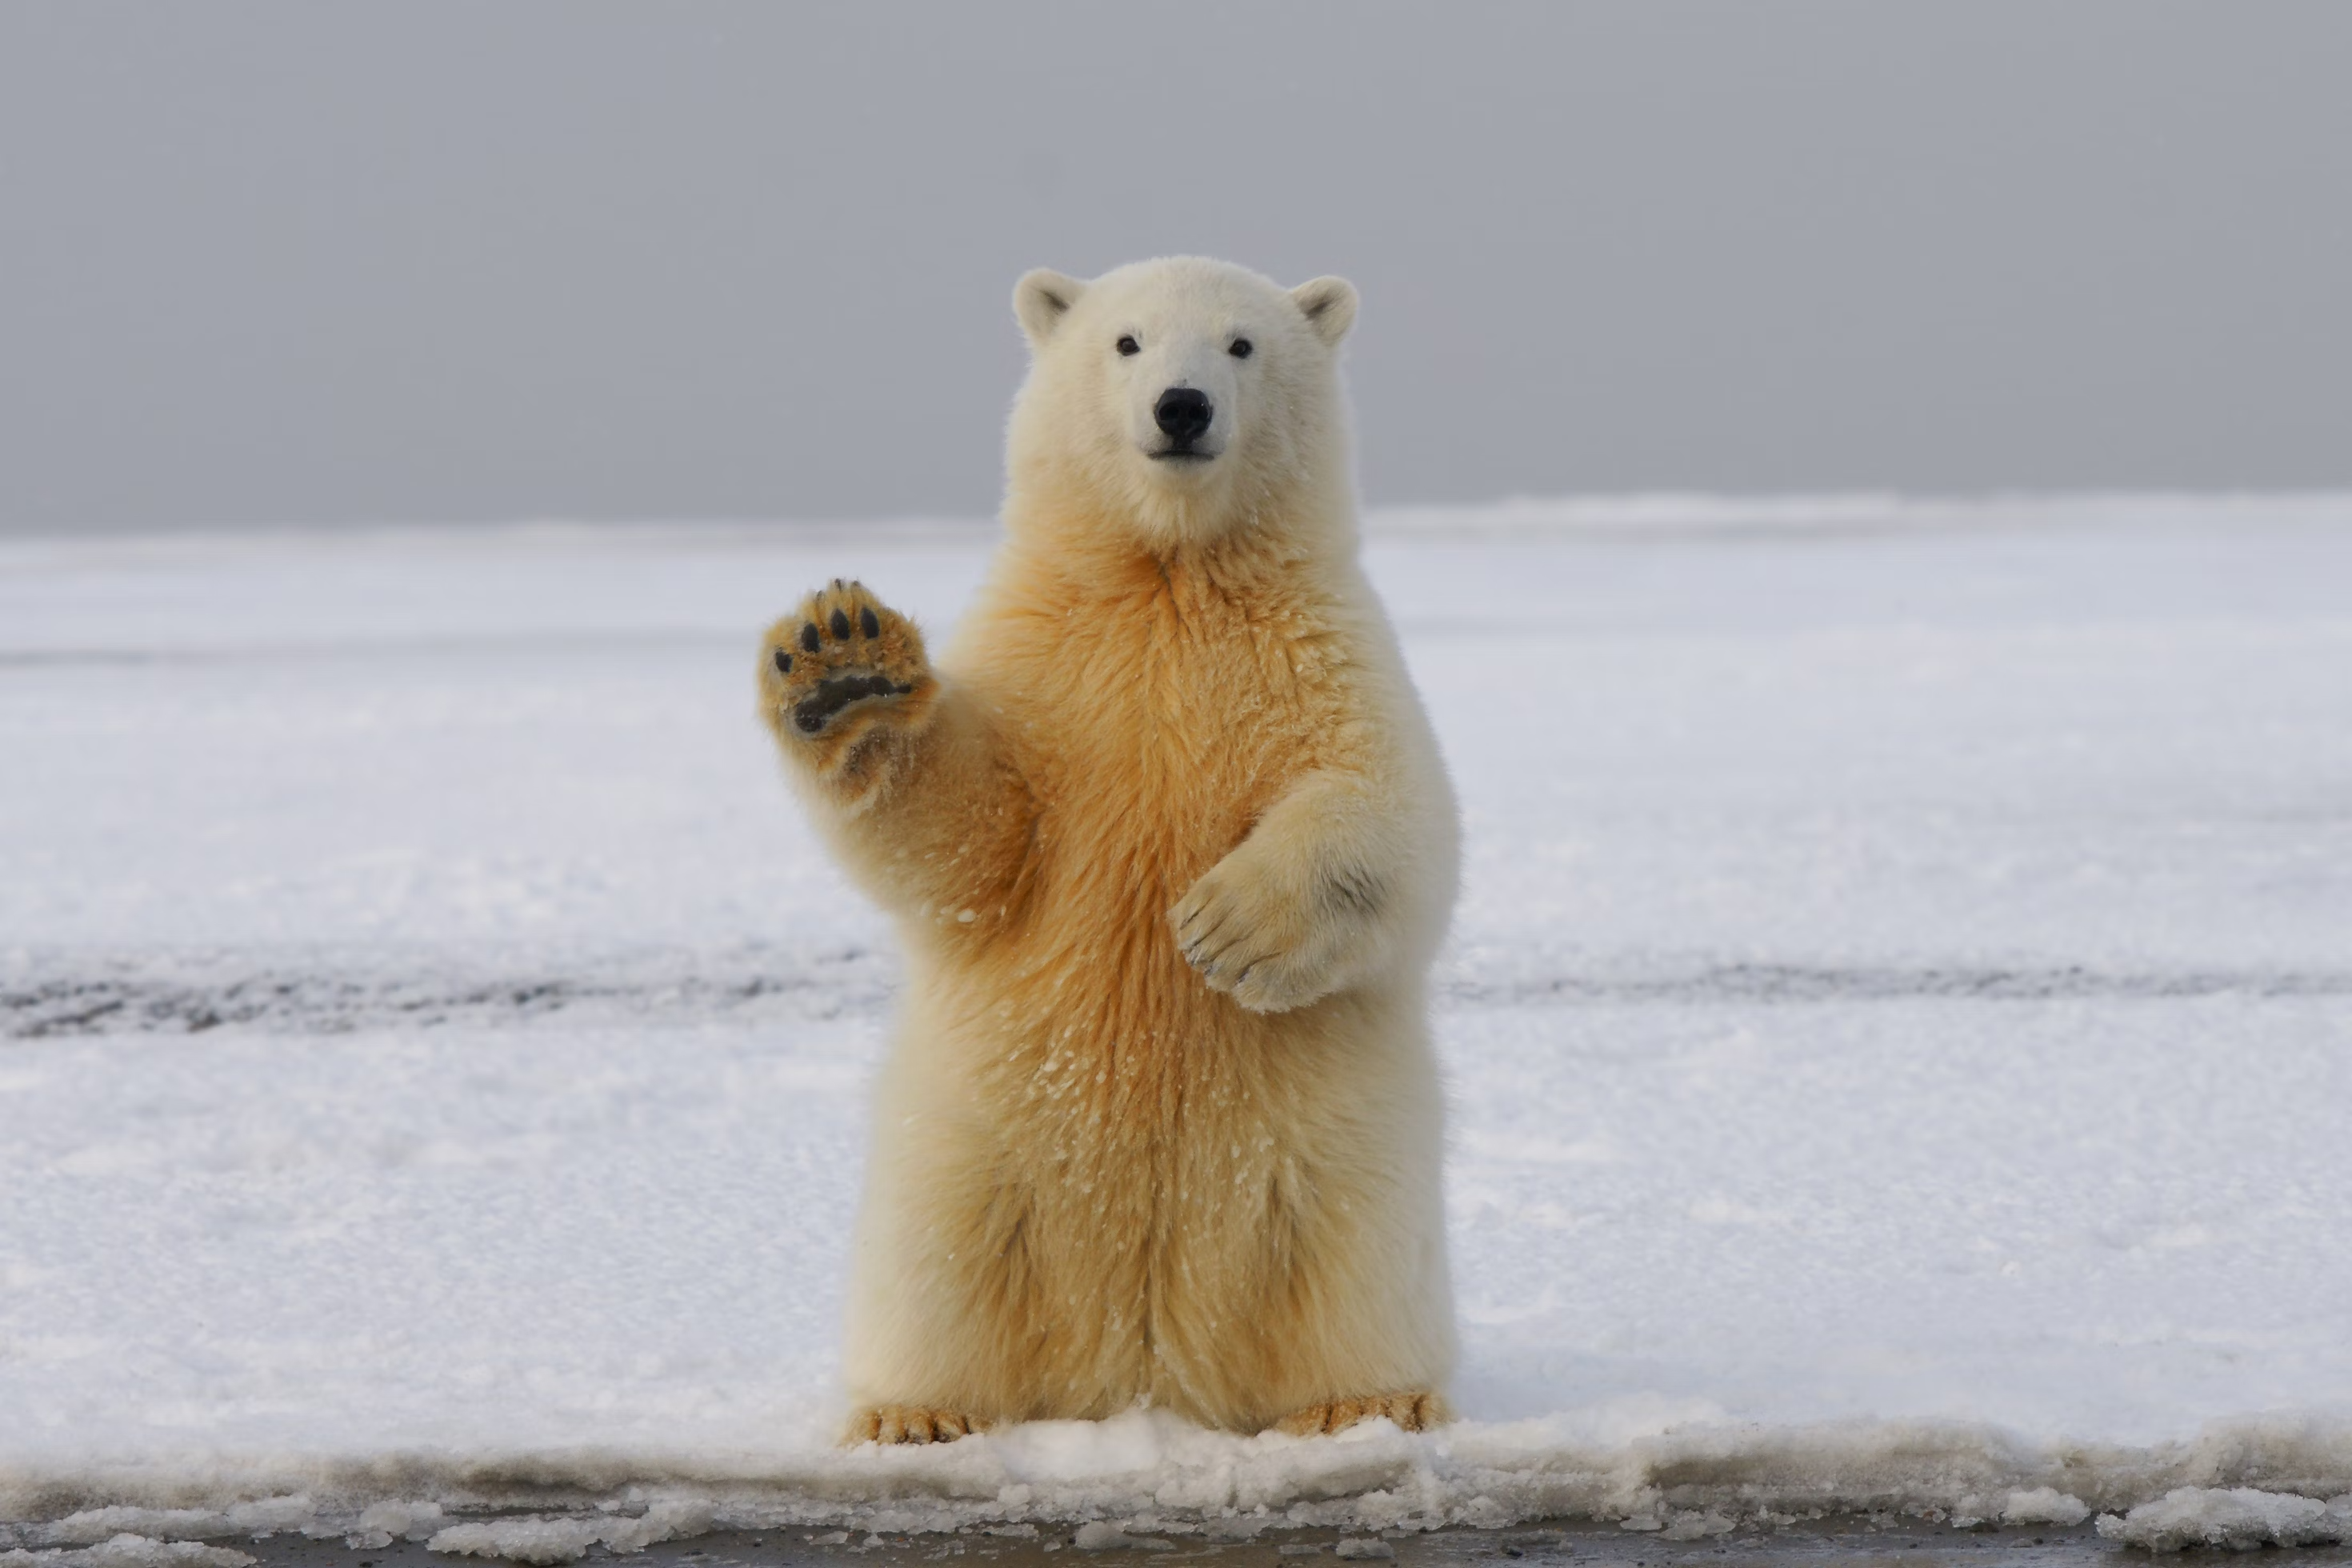
import torch
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image

pipeline = AutoPipelineForInpainting.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.6)

mask_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_mask.png")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_bear_1.png")
ip_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_gummy.png")
pipeline(
    prompt="a cute gummy bear waving",
    image=image,
    mask_image=mask_image,
    ip_adapter_image=ip_image,
).images[0] 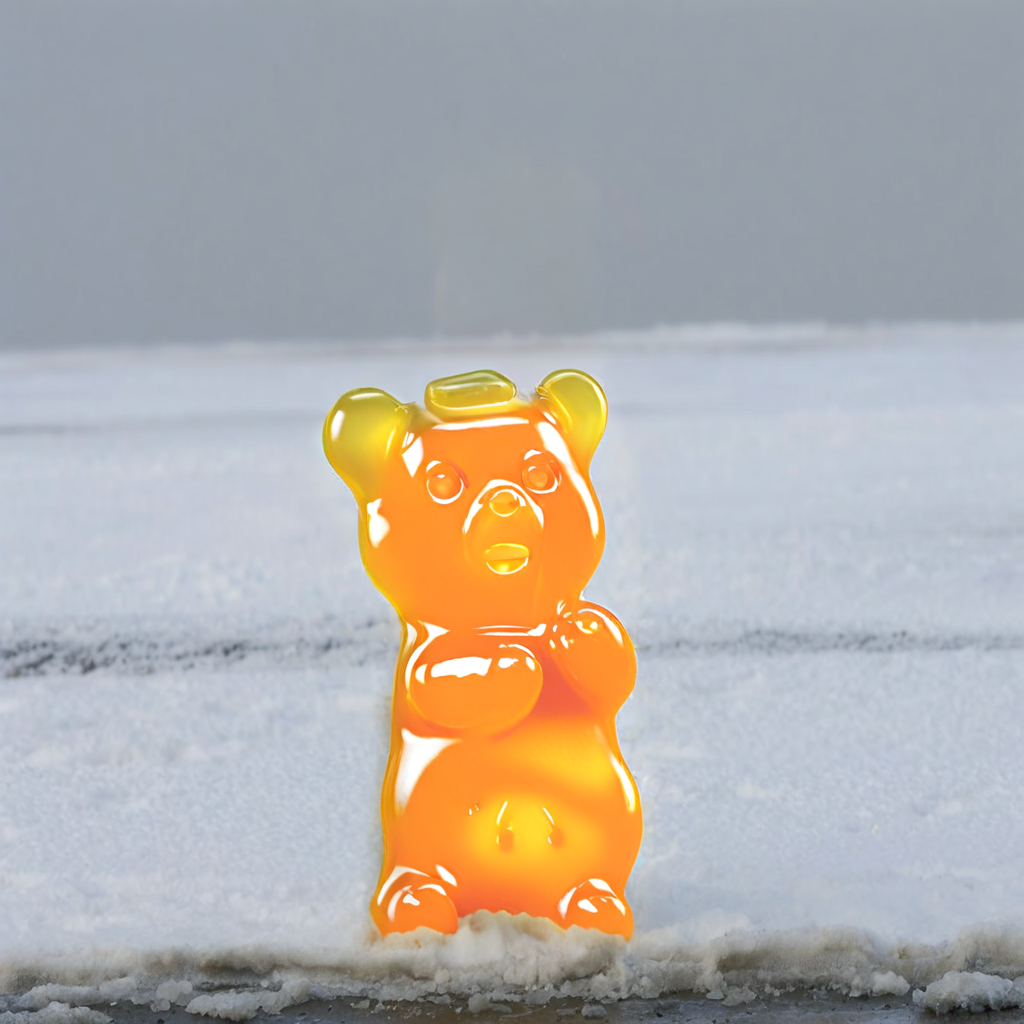
La méthode enable_model_cpu_offload() est utile pour réduire la mémoire et doit être activée après le chargement de l’IP-Adapter. Sinon, l’encodeur d’images de l’IP-Adapter est également déchargé sur le CPU et renvoie une erreur.
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from diffusers.utils import load_image

adapter = MotionAdapter.from_pretrained(
  "guoyww/animatediff-motion-adapter-v1-5-2",
  dtype=torch.float16
)
pipeline = AnimateDiffPipeline.from_pretrained(
  "emilianJR/epiCRealism",
  motion_adapter=adapter,
  dtype=torch.float16
)
scheduler = DDIMScheduler.from_pretrained(
    "emilianJR/epiCRealism",
    subfolder="scheduler",
    clip_sample=False,
    timestep_spacing="linspace",
    beta_schedule="linear",
    steps_offset=1,
)
pipeline.scheduler = scheduler
pipeline.vae.enable_slicing()
pipeline.load_ip_adapter("h94/IP-Adapter", subfolder="models", weight_name="ip-adapter_sd15.bin")
pipeline.enable_model_cpu_offload()

ip_adapter_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_inpaint.png")
pipeline(
    prompt="A cute gummy bear waving",
    negative_prompt="bad quality, worse quality, low resolution",
    ip_adapter_image=ip_adapter_image,
    num_frames=16,
    guidance_scale=7.5,
    num_inference_steps=50,
).frames[0] 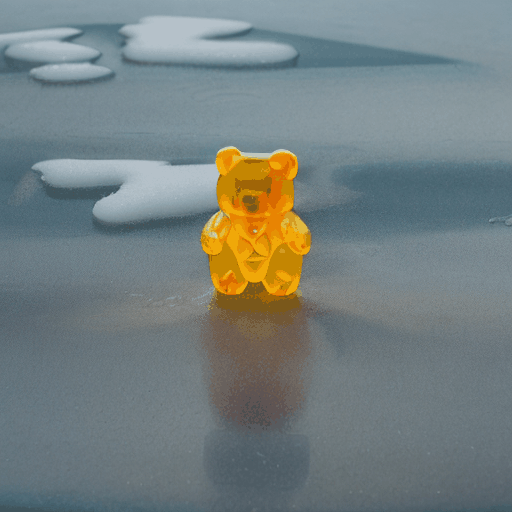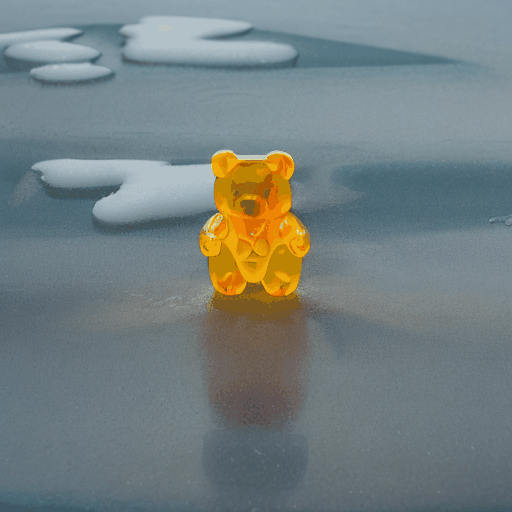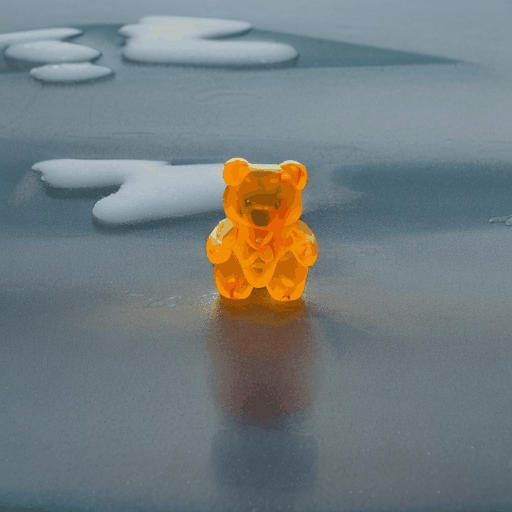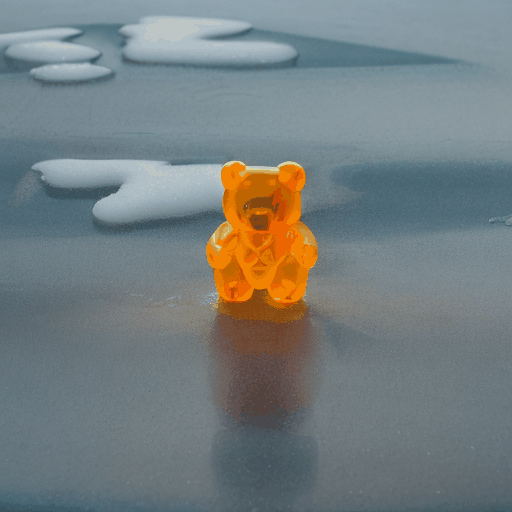
Variantes de points de contrôle
Chargez Plus lorsque les détails de l’image de référence sont les plus importants. Chargez FaceID lorsque vous avez besoin des embeddings d’identité InsightFace plutôt que des embeddings d’image CLIP.
import torch
from transformers import CLIPVisionModelWithProjection
from diffusers import AutoPipelineForText2Image

image_encoder = CLIPVisionModelWithProjection.from_pretrained(
    "h94/IP-Adapter",
    subfolder="models/image_encoder",
    dtype=torch.float16
)

pipeline = AutoPipelineForText2Image.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    image_encoder=image_encoder,
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter-plus_sdxl_vit-h.safetensors"
)
Les points de contrôle FaceID utilisent des embeddings de visage issus de InsightFace au lieu des embeddings d'images CLIP. Utilisez le DDIMScheduler ou le EulerDiscreteScheduler pour les modèles FaceID. Extraites les embeddings de visage et passez-les sous forme de liste de tenseurs à ip_adapter_image_embeds.
# pip install insightface
import cv2
import numpy as np
import torch
from diffusers import StableDiffusionPipeline, DDIMScheduler
from diffusers.utils import load_image
from insightface.app import FaceAnalysis

pipeline = StableDiffusionPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    dtype=torch.float16,
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.scheduler = DDIMScheduler.from_config(pipeline.scheduler.config)
pipeline.load_ip_adapter(
  "h94/IP-Adapter-FaceID",
  subfolder=None,
  weight_name="ip-adapter-faceid_sd15.bin",
  image_encoder_folder=None
)
pipeline.set_ip_adapter_scale(0.6)

image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl1.png")

ref_images_embeds = []
app = FaceAnalysis(name="buffalo_l", providers=['CUDAExecutionProvider', 'CPUExecutionProvider'])
app.prepare(ctx_id=0, det_size=(640, 640))
image = cv2.cvtColor(np.asarray(image), cv2.COLOR_RGB2BGR)
faces = app.get(image)
image = torch.from_numpy(faces[0].normed_embedding)
ref_images_embeds.append(image.unsqueeze(0))
ref_images_embeds = torch.stack(ref_images_embeds, dim=0).unsqueeze(0)
neg_ref_images_embeds = torch.zeros_like(ref_images_embeds)
id_embeds = torch.cat([neg_ref_images_embeds, ref_images_embeds]).to(dtype=torch.float16, device="cuda")

pipeline(
    prompt="A photo of a girl",
    ip_adapter_image_embeds=[id_embeds],
    negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
).images[0]
Pour FaceID Plus, chargez CLIPVisionModelWithProjection comme encodeur d'images.
import torch
from transformers import CLIPVisionModelWithProjection
from diffusers import AutoPipelineForText2Image

image_encoder = CLIPVisionModelWithProjection.from_pretrained(
    "laion/CLIP-ViT-H-14-laion2B-s32B-b79K",
    dtype=torch.float16,
)

pipeline = AutoPipelineForText2Image.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    image_encoder=image_encoder,
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline.load_ip_adapter(
  "h94/IP-Adapter-FaceID",
  subfolder=None,
  weight_name="ip-adapter-faceid-plus_sd15.bin"
)
FaceID Plus et Plus v2 nécessitent également des embeddings d’images CLIP en plus des embeddings InsightFace. Après avoir préparé les embeddings de visage, encodez l’image de référence et affectez les embeddings CLIP à la couche de projection d’image.
import torch
from diffusers.utils import load_image

ip_adapter_images = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl1.png")
num_images = 1
clip_embeds = pipeline.prepare_ip_adapter_image_embeds(
    ip_adapter_image=[ip_adapter_images],
    ip_adapter_image_embeds=None,
    device=torch.device("cuda"),
    num_images_per_prompt=num_images,
    do_classifier_free_guidance=True,
)[0]

pipeline.unet.encoder_hid_proj.image_projection_layers[0].clip_embeds = clip_embeds.to(dtype=torch.float16)
# set to True if using IP-Adapter FaceID Plus v2
pipeline.unet.encoder_hid_proj.image_projection_layers[0].shortcut = False
Embeddings d'images
prepare_ip_adapter_image_embeds() encode les images IP-Adapter en embeddings que vous pouvez enregistrer et réutiliser. Précalculez-les une seule fois plutôt que de charger et d’encoder les mêmes images à chaque exécution du pipeline.
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)

image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_adapter_bear_1.png")
image_embeds = pipeline.prepare_ip_adapter_image_embeds(
    ip_adapter_image=image,
    ip_adapter_image_embeds=None,
    device="cuda",
    num_images_per_prompt=1,
    do_classifier_free_guidance=True,
)

torch.save(image_embeds, "image_embeds.ipadpt")
Rechargez les embeddings d’image en les passant au paramètre ip_adapter_image_embeds. Définissez image_encoder_folder sur None car vous n’avez plus besoin de l’encodeur d’image pour générer les embeddings d’image.
Vous pouvez également charger des embeddings d’images à partir d’autres sources, telles que ComfyUI.
pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  image_encoder_folder=None,
  weight_name="ip-adapter_sdxl.bin"
)
pipeline.set_ip_adapter_scale(0.8)
image_embeds = torch.load("image_embeds.ipadpt")
pipeline(
    prompt="a polar bear sitting in a chair drinking a milkshake",
    ip_adapter_image_embeds=image_embeds,
    negative_prompt="deformed, ugly, wrong proportion, low res, bad anatomy, worst quality, low quality",
    num_inference_steps=100,
).images[0]
Masquage
Le masquage binaire permet d’assigner une image IP-Adapter à une zone spécifique de l’image de sortie, ce qui est utile pour composer plusieurs images IP-Adapter. Chaque image IP-Adapter nécessite un masque binaire.
Chargez le IPAdapterMaskProcessor pour prétraiter les masques d’image. Pour de meilleurs résultats, fournissez la height et la width de sortie afin de garantir que les masques aux rapports d’aspect différents soient dimensionnés correctement. Si les masques d’entrée correspondent déjà au rapport d’aspect de l’image générée, vous n’avez pas besoin de définir la height et la width.
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.image_processor import IPAdapterMaskProcessor
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

mask1 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_mask1.png")
mask2 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_mask2.png")

processor = IPAdapterMaskProcessor()
masks = processor.preprocess([mask1, mask2], height=1024, width=1024)

Fournissez à la fois les images IP-Adapter et leurs échelles sous forme de liste. Transmettez les masques prétraités à cross_attention_kwargs dans le pipeline.
face_image1 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl1.png")
face_image2 = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/ip_mask_girl2.png")

pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name=["ip-adapter-plus-face_sdxl_vit-h.safetensors"]
)
pipeline.set_ip_adapter_scale([[0.7, 0.7]])

ip_images = [[face_image1, face_image2]]
masks = [masks.reshape(1, masks.shape[0], masks.shape[2], masks.shape[3])]

pipeline(
  prompt="2 girls",
  ip_adapter_image=ip_images,
  negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
  cross_attention_kwargs={"ip_adapter_masks": masks}
).images[0]


Recettes
Associez IP-Adapter à d’autres adaptateurs ou pipelines, comme plusieurs adaptateurs, ControlNet, InstantStyle ou LCM en peu d’étapes, lorsqu’une seule image de référence ne suffit pas.
Plusieurs IP-Adapters
Combinez plusieurs IP-Adapter pour générer des images dans des styles plus variés. Par exemple, vous pouvez utiliser IP-Adapter Face pour générer des visages et des personnages cohérents, et IP-Adapter Plus pour générer ces visages dans des styles spécifiques.
Charger un encodeur d’images avec CLIPVisionModelWithProjection.
import torch
from diffusers import AutoPipelineForText2Image, DDIMScheduler
from transformers import CLIPVisionModelWithProjection
from diffusers.utils import load_image

image_encoder = CLIPVisionModelWithProjection.from_pretrained(
    "h94/IP-Adapter",
    subfolder="models/image_encoder",
    dtype=torch.float16,
)
Chargez un modèle de base, un planificateur et les adaptateurs IP suivants.
- ip-adapter-plus_sdxl_vit-h utilise des embeddings de patch et un encodeur d’images ViT-H
- ip-adapter-plus-face_sdxl_vit-h utilise des embeddings de patch et un encodeur d’images ViT-H, mais il est conditionné sur des images de visages recadrés
pipeline = AutoPipelineForText2Image.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    dtype=torch.float16,
    image_encoder=image_encoder,
)
pipeline.scheduler = DDIMScheduler.from_config(pipeline.scheduler.config)
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name=["ip-adapter-plus_sdxl_vit-h.safetensors", "ip-adapter-plus-face_sdxl_vit-h.safetensors"]
)
pipeline.set_ip_adapter_scale([0.7, 0.3])
# enable_model_cpu_offload to reduce memory usage
pipeline.enable_model_cpu_offload()
Chargez une image et un dossier contenant des images d'un style particulier à appliquer.
face_image = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/women_input.png")
style_folder = "https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/style_ziggy"
style_images = [load_image(f"{style_folder}/img{i}.png") for i in range(10)]

Passez les images de style et de visage sous forme de liste à ip_adapter_image.
generator = torch.Generator(device="cpu").manual_seed(0)

pipeline(
    prompt="wonderwoman",
    ip_adapter_image=[style_images, face_image],
    negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
).images[0]
Contrôle structurel
Pour un contrôle structurel, combinez IP-Adapter avec ControlNet conditionné sur des cartes de profondeur, des cartes de contours, des estimations de pose, et plus encore.
L'exemple ci-dessous charge un point de contrôle ControlNetModel conditionné sur des cartes de profondeur et le combine avec un IP-Adapter.
import torch
from diffusers.utils import load_image
from diffusers import StableDiffusionControlNetPipeline, ControlNetModel

controlnet = ControlNetModel.from_pretrained(
  "lllyasviel/control_v11f1p_sd15_depth",
  dtype=torch.float16
)

pipeline = StableDiffusionControlNetPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    controlnet=controlnet,
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="models",
  weight_name="ip-adapter_sd15.bin"
)
Transmettez la carte de profondeur et l'image IP-Adapter au pipeline.
depth_map = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/depth.png")
ip_adapter_image = load_image("https://huggingface.co/datasets/YiYiXu/testing-images/resolve/main/statue.png")
pipeline(
  prompt="best quality, high quality",
  image=depth_map,
  ip_adapter_image=ip_adapter_image,
  negative_prompt="monochrome, lowres, bad anatomy, worst quality, low quality",
).images[0]


Contrôle du style et de la mise en page
Pour contrôler le style et la mise en page, combinez IP-Adapter avec InstantStyle. InstantStyle sépare le style (couleur, texture, ambiance générale) du contenu et applique le style uniquement dans les blocs spécifiques au style, afin que les zones de contenu restent intactes. Cela offre une meilleure cohérence du style et un contrôle plus précis de la mise en page.
Activez l’IP-Adapter uniquement dans des couches sélectionnées à l’aide de set_ip_adapter_scale(). L’exemple ci-dessous l’active dans le bloc block_2 descendant (layout) et le bloc block_0 montant (style) du modèle.
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.utils import load_image

pipeline = AutoPipelineForText2Image.from_pretrained(
  "stabilityai/stable-diffusion-xl-base-1.0",
  dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="sdxl_models",
  weight_name="ip-adapter_sdxl.bin"
)

scale = {
    "down": {"block_2": [0.0, 1.0]},
    "up": {"block_0": [0.0, 1.0, 0.0]},
}
pipeline.set_ip_adapter_scale(scale)
Chargez l’image de style et générez une image.
style_image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/0052a70beed5bf71b92610a43a52df6d286cd5f3/diffusers/rabbit.jpg")

pipeline(
    prompt="a cat, masterpiece, best quality, high quality",
    ip_adapter_image=style_image,
    negative_prompt="text, watermark, lowres, low quality, worst quality, deformed, glitch, low contrast, noisy, saturation, blurry",
    guidance_scale=5,
).images[0]

Les figures ci-dessous comparent l’activation style-only d’InstantStyle (jusqu’au block_0) avec l’activation de l’IP-Adapter sur toutes les couches. L’activation sur toutes les couches suit généralement le prompt d’image plus fortement et peut réduire la diversité. Préférez l’échelle style-only lorsque vous souhaitez le comportement de préservation de la mise en page d’InstantStyle.
Vous n’avez pas besoin de spécifier toutes les couches dans le dictionnaire
scale. Les couches non incluses sont définies à 0, ce qui signifie que l’IP-Adapter est désactivé.
scale = {
    "up": {"block_0": [0.0, 1.0, 0.0]},
}
pipeline.set_ip_adapter_scale(scale)

pipeline(
    prompt="a cat, masterpiece, best quality, high quality",
    ip_adapter_image=style_image,
    negative_prompt="text, watermark, lowres, low quality, worst quality, deformed, glitch, low contrast, noisy, saturation, blurry",
    guidance_scale=5,
).images[0]

Génération instantanée
Associez IP-Adapter à un LoRA LCM pour une génération en peu d'étapes.
import torch
from diffusers import DiffusionPipeline, LCMScheduler
from diffusers.utils import load_image

pipeline = DiffusionPipeline.from_pretrained(
  "sd-dreambooth-library/herge-style",
  dtype=torch.float16
)
pipeline.load_ip_adapter(
  "h94/IP-Adapter",
  subfolder="models",
  weight_name="ip-adapter_sd15.bin"
)
pipeline.load_lora_weights("latent-consistency/lcm-lora-sdv1-5")
pipeline.scheduler = LCMScheduler.from_config(pipeline.scheduler.config)
pipeline.enable_model_cpu_offload()

pipeline.set_ip_adapter_scale(0.4)
ip_adapter_image = load_image("https://user-images.githubusercontent.com/24734142/266492875-2d50d223-8475-44f0-a7c6-08b51cb53572.png")
pipeline(
    prompt="herge_style woman in armor, best quality, high quality",
    ip_adapter_image=ip_adapter_image,
    num_inference_steps=4,
    guidance_scale=1,
).images[0]