
Diffusers documentation
Stable Diffusion 3
Stable Diffusion 3


Stable Diffusion 3 (SD3) fue propuesto en Scaling Rectified Flow Transformers for High-Resolution Image Synthesis por Patrick Esser, Sumith Kulal, Andreas Blattmann, Rahim Entezari, Jonas Muller, Harry Saini, Yam Levi, Dominik Lorenz, Axel Sauer, Frederic Boesel, Dustin Podell, Tim Dockhorn, Zion English, Kyle Lacey, Alex Goodwin, Yannik Marek y Robin Rombach.
El resumen del artículo es:
Los modelos de difusión crean datos a partir de ruido invirtiendo las trayectorias hacia adelante de los datos hacia el ruido y se han consolidado como una técnica poderosa de modelado generativo para datos perceptuales de alta dimensión, como imágenes y videos. El flujo rectificado es una formulación reciente de modelos generativos que conecta los datos y el ruido mediante una línea recta. A pesar de sus mejores propiedades teóricas y su simplicidad conceptual, aún no se ha establecido de manera decisiva como práctica estándar. En este trabajo, mejoramos las técnicas existentes de muestreo de ruido para el entrenamiento de modelos de flujo rectificado sesgándolas hacia escalas perceptualmente relevantes. A través de un estudio a gran escala, demostramos el rendimiento superior de este enfoque en comparación con las formulaciones de difusión establecidas para la síntesis de texto a imagen de alta resolución. Además, presentamos una nueva arquitectura basada en transformers para la generación de texto a imagen que utiliza pesos separados para las dos modalidades y permite un flujo bidireccional de información entre los tokens de imagen y de texto, mejorando la comprensión del texto, la tipografía y las calificaciones de preferencia humana. Demostramos que esta arquitectura sigue tendencias de escalado predecibles y que una menor pérdida de validación se correlaciona con una mejor síntesis de texto a imagen, medida mediante diversas métricas y evaluaciones humanas.
Ejemplo de uso
Como el modelo está restringido, antes de usarlo con diffusers primero debes ir a la página de Stable Diffusion 3 Medium en Hugging Face, completar el formulario y aceptar la restricción. Una vez dentro, necesitas iniciar sesión para que tu sistema sepa que has aceptado la restricción.
Use el siguiente comando para iniciar sesión:
hf auth login
El pipeline de SD3 utiliza tres codificadores de texto para generar una imagen. Es necesario el descargado de modelos para que funcione en la mayoría de los equipos de consumo. Utilice el tipo de datos
torch.float16para ahorrar aún más memoria.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained("stabilityai/stable-diffusion-3-medium-diffusers", dtype=torch.float16)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world.png")
Nota: Stable Diffusion 3.5 también se puede ejecutar usando el pipeline de SD3, y todas las optimizaciones y técnicas mencionadas se aplican a él también. En total, hay tres modelos oficiales en la familia SD3:
stabilityai/stable-diffusion-3-medium-diffusersstabilityai/stable-diffusion-3.5-largestabilityai/stable-diffusion-3.5-large-turbo
Prompting de imágenes con IP-Adapters
Un IP-Adapter te permite usar imágenes como prompt para SD3, además del prompt de texto. Esto resulta especialmente útil al describir conceptos complejos que son difíciles de articular solo con texto y dispones de imágenes de referencia. Para cargar y usar un IP-Adapter, necesitas:
image_encoder: Modelo de visión preentrenado utilizado para obtener características de imagen, generalmente un codificador de imágenes de CLIP.feature_extractor: Procesador de imágenes que prepara la imagen de entrada para elimage_encoderelegido.ip_adapter_id: Punto de control que contiene los parámetros de las capas de atención cruzada de imagen y la proyección de imagen.
Los IP-Adapters se entrenan para una arquitectura de modelo específica, por lo que también funcionan en variaciones afinadas del modelo base. Puede usar la función ~SD3IPAdapterMixin.set_ip_adapter_scale para ajustar la fuerza con la que la salida se alinea con el prompt de imagen. A mayor valor, más de cerca el modelo sigue el prompt de imagen. Un valor predeterminado de 0.5 suele ser un buen equilibrio, asegurando que el modelo considere por igual tanto el prompt de texto como el de imagen.
import torch
from PIL import Image

from diffusers import StableDiffusion3Pipeline
from transformers import SiglipVisionModel, SiglipImageProcessor

image_encoder_id = "google/siglip-so400m-patch14-384"
ip_adapter_id = "InstantX/SD3.5-Large-IP-Adapter"

feature_extractor = SiglipImageProcessor.from_pretrained(
    image_encoder_id,
    dtype=torch.float16
)
image_encoder = SiglipVisionModel.from_pretrained(
    image_encoder_id,
    dtype=torch.float16
).to( "cuda")  # or "mps", "xpu", "cpu"

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    dtype=torch.float16,
    feature_extractor=feature_extractor,
    image_encoder=image_encoder,
).to("cuda")

pipe.load_ip_adapter(ip_adapter_id)
pipe.set_ip_adapter_scale(0.6)

ref_img = Image.open("image.jpg").convert('RGB')

image = pipe(
    width=1024,
    height=1024,
    prompt="a cat",
    negative_prompt="lowres, low quality, worst quality",
    num_inference_steps=24,
    guidance_scale=5.0,
    ip_adapter_image=ref_img
).images[0]

image.save("result.jpg")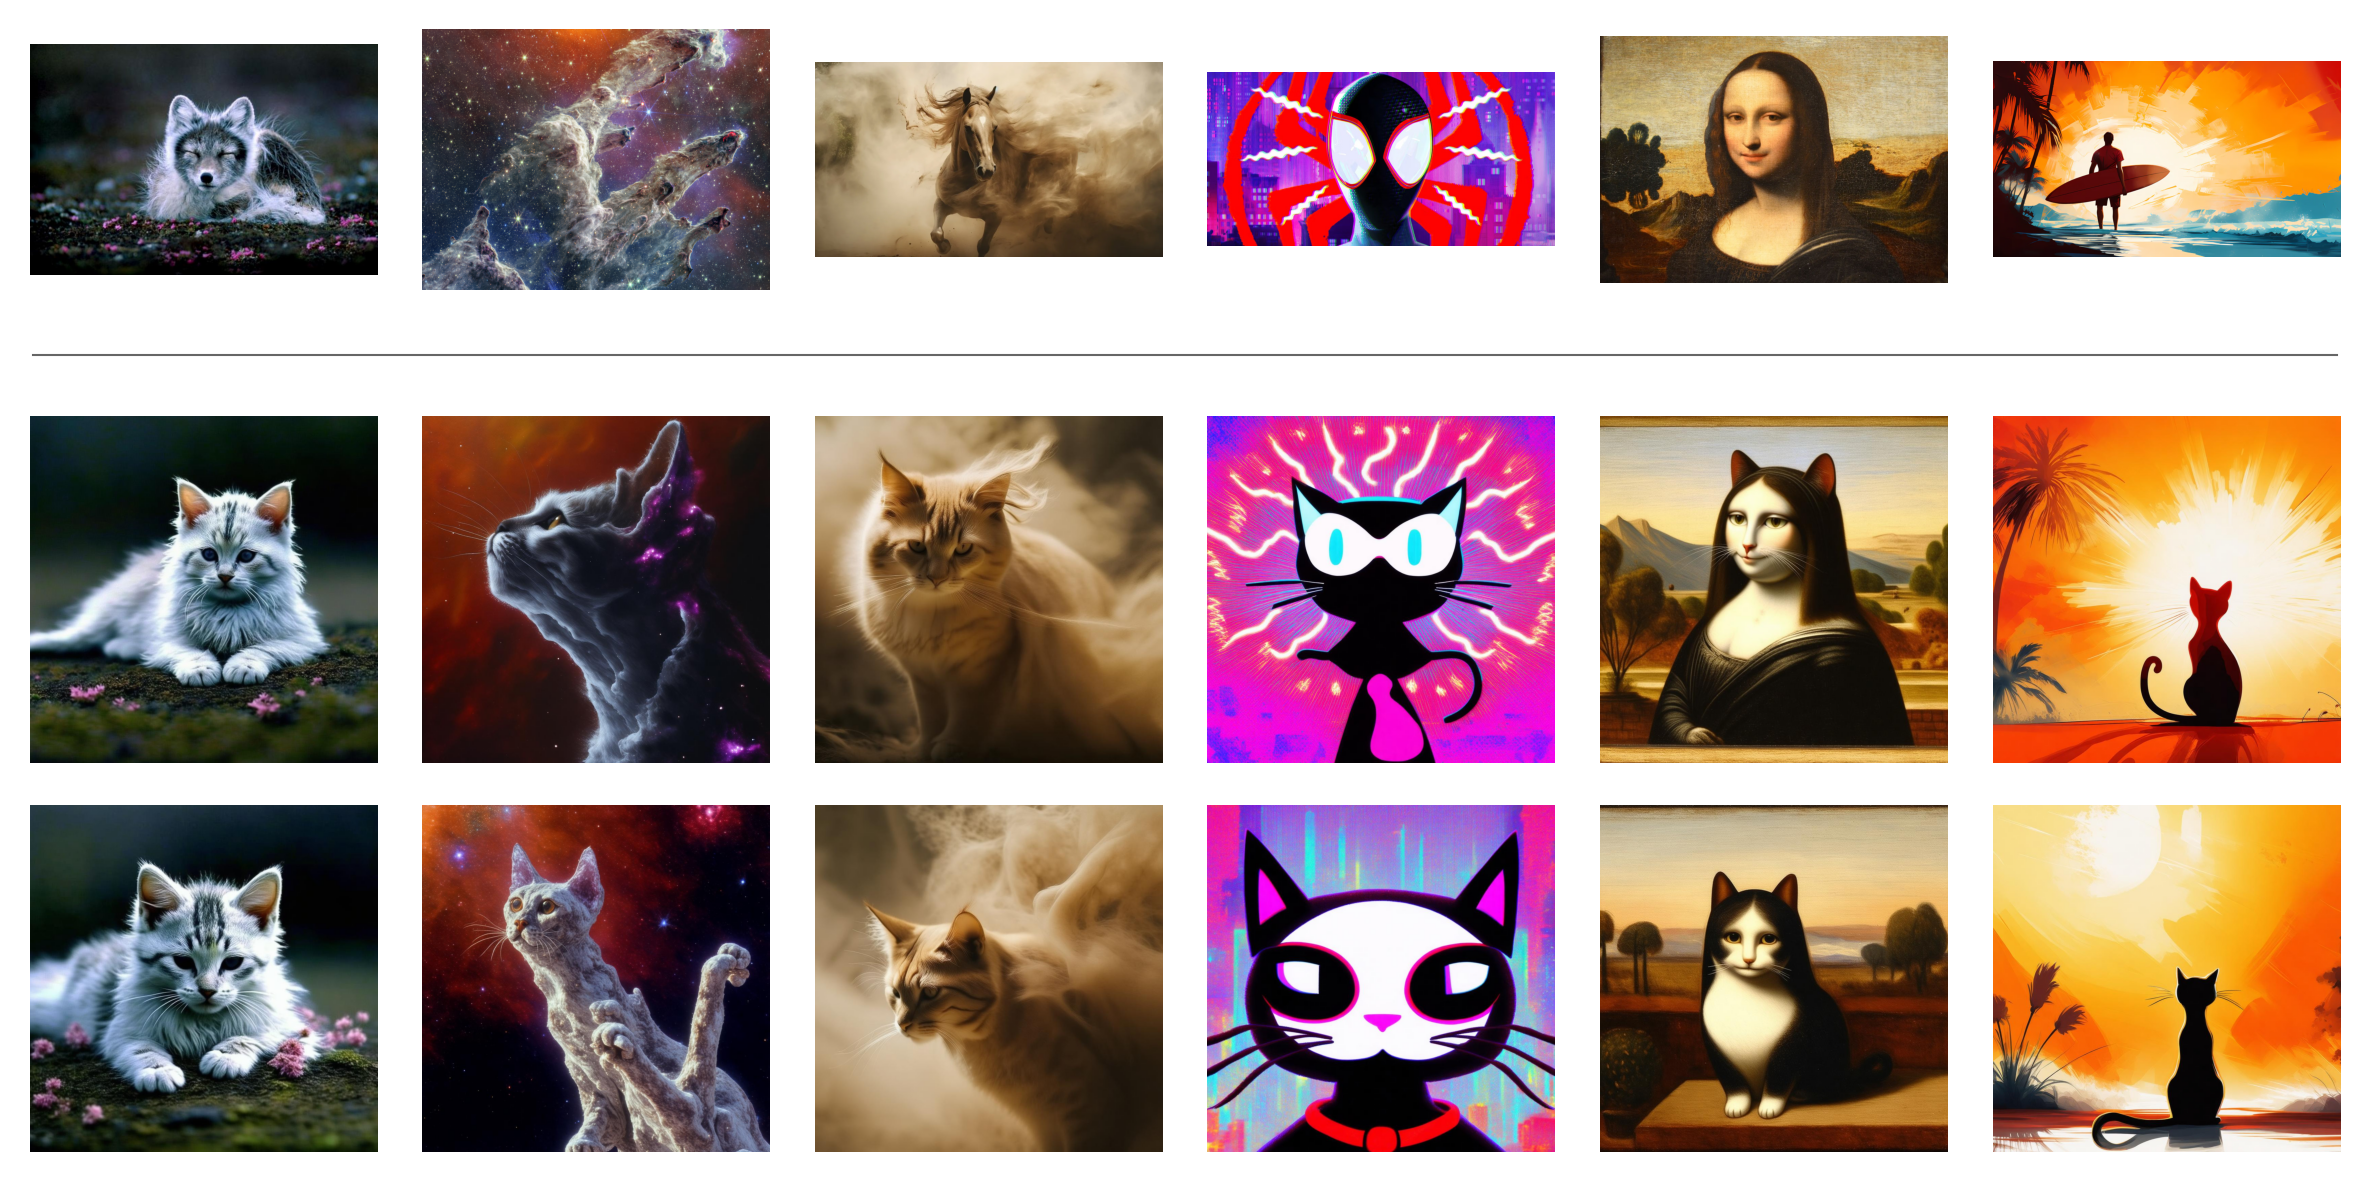
Consulte IP-Adapter para obtener más información sobre cómo funcionan los IP-Adapters.
Optimizaciones de memoria para SD3
SD3 utiliza tres codificadores de texto, uno de los cuales es el modelo T5-XXL, de gran tamaño. Esto dificulta la ejecución del modelo en GPUs con menos de 24 GB de VRAM, incluso al usar precisión fp16. La siguiente sección describe algunas optimizaciones de memoria en Diffusers que facilitan la ejecución de SD3 en hardware con recursos limitados.
Ejecución de inferencia con descarga de modelos
La optimización de memoria más básica disponible en Diffusers permite descargar los componentes del modelo a la CPU durante la inferencia para ahorrar memoria, aunque con un ligero aumento en la latencia de inferencia. El offloading del modelo solo moverá un componente del modelo a la GPU cuando necesite ejecutarse, manteniendo los componentes restantes en la CPU.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained("stabilityai/stable-diffusion-3-medium-diffusers", dtype=torch.float16)
pipe.enable_model_cpu_offload()

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world.png")
Descartar el codificador de texto T5 durante la inferencia
Eliminar el codificador de texto T5-XXL de 4,7 mil millones de parámetros, que consume mucha memoria, durante la inferencia puede reducir significativamente los requisitos de memoria para SD3 con solo una ligera pérdida de rendimiento.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3-medium-diffusers",
    text_encoder_3=None,
    tokenizer_3=None,
    dtype=torch.float16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world-no-T5.png")
Uso de una versión cuantizada del codificador de texto T5
Podemos aprovechar la biblioteca bitsandbytes para cargar y cuantizar el codificador de texto T5-XXL a una precisión de 8 bits. Esto permite seguir utilizando los tres codificadores de texto con un impacto mínimo en el rendimiento.
Primero, instala la biblioteca bitsandbytes.
pip install bitsandbytes
Luego, cargue el modelo T5-XXL usando BitsAndBytesConfig.
import torch
from diffusers import StableDiffusion3Pipeline
from transformers import T5EncoderModel, BitsAndBytesConfig

quantization_config = BitsAndBytesConfig(load_in_8bit=True)

model_id = "stabilityai/stable-diffusion-3-medium-diffusers"
text_encoder = T5EncoderModel.from_pretrained(
    model_id,
    subfolder="text_encoder_3",
    quantization_config=quantization_config,
)
pipe = StableDiffusion3Pipeline.from_pretrained(
    model_id,
    text_encoder_3=text_encoder,
    device_map="balanced",
    dtype=torch.float16
)

image = pipe(
    prompt="a photo of a cat holding a sign that says hello world",
    negative_prompt="",
    num_inference_steps=28,
    height=1024,
    width=1024,
    guidance_scale=7.0,
).images[0]

image.save("sd3_hello_world-8bit-T5.png")
Puedes encontrar el script de extremo a extremo aquí.
Optimizaciones de rendimiento para SD3
Usar Torch Compile para acelerar la inferencia
El uso de componentes compilados en el pipeline de SD3 puede acelerar la inferencia hasta 4 veces. El siguiente fragmento de código demuestra cómo compilar los componentes Transformer y VAE del pipeline de SD3.
import torch
from diffusers import StableDiffusion3Pipeline

torch.set_float32_matmul_precision("high")

torch._inductor.config.conv_1x1_as_mm = True
torch._inductor.config.coordinate_descent_tuning = True
torch._inductor.config.epilogue_fusion = False
torch._inductor.config.coordinate_descent_check_all_directions = True

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3-medium-diffusers",
    dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"
pipe.set_progress_bar_config(disable=True)

pipe.transformer.to(memory_format=torch.channels_last)
pipe.vae.to(memory_format=torch.channels_last)

pipe.transformer = torch.compile(pipe.transformer, mode="max-autotune", fullgraph=True)
pipe.vae.decode = torch.compile(pipe.vae.decode, mode="max-autotune", fullgraph=True)

# Warm Up
prompt = "a photo of a cat holding a sign that says hello world"
for _ in range(3):
    _ = pipe(prompt=prompt, generator=torch.manual_seed(1))

# Run Inference
image = pipe(prompt=prompt, generator=torch.manual_seed(1)).images[0]
image.save("sd3_hello_world.png")
Puedes ver el script completo aquí.
Cuantización
La cuantización ayuda a reducir los requisitos de memoria de los modelos muy grandes almacenando los pesos del modelo en un tipo de datos de menor precisión. Sin embargo, la cuantización puede tener un impacto variable en la calidad del vídeo dependiendo del modelo de vídeo.
Consulte el resumen de Quantization para obtener más información sobre los backends de cuantización admitidos y la selección de un backend de cuantización que admita su caso de uso. El siguiente ejemplo demuestra cómo cargar un StableDiffusion3Pipeline cuantizado para inferencia con bitsandbytes.
import torch
from diffusers import BitsAndBytesConfig as DiffusersBitsAndBytesConfig, SD3Transformer2DModel, StableDiffusion3Pipeline
from transformers import BitsAndBytesConfig as BitsAndBytesConfig, T5EncoderModel

quant_config = BitsAndBytesConfig(load_in_8bit=True)
text_encoder_8bit = T5EncoderModel.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    subfolder="text_encoder_3",
    quantization_config=quant_config,
    dtype=torch.float16,
)

quant_config = DiffusersBitsAndBytesConfig(load_in_8bit=True)
transformer_8bit = SD3Transformer2DModel.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    subfolder="transformer",
    quantization_config=quant_config,
    dtype=torch.float16,
)

pipeline = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    text_encoder=text_encoder_8bit,
    transformer=transformer_8bit,
    dtype=torch.float16,
    device_map="balanced",
)

prompt = "a tiny astronaut hatching from an egg on the moon"
image = pipeline(prompt, num_inference_steps=28, guidance_scale=7.0).images[0]
image.save("sd3.png")
Uso de prompts largos con el codificador de texto T5
Por defecto, el prompt del codificador de texto T5 utiliza una longitud de secuencia máxima de 256. Esto se puede ajustar estableciendo max_sequence_length para aceptar menos o más tokens. Tenga en cuenta que las secuencias más largas requieren recursos adicionales y resultan en tiempos de generación más largos, como durante la inferencia por lotes.
prompt = "A whimsical and creative image depicting a hybrid creature that is a mix of a waffle and a hippopotamus, basking in a river of melted butter amidst a breakfast-themed landscape. It features the distinctive, bulky body shape of a hippo. However, instead of the usual grey skin, the creature’s body resembles a golden-brown, crispy waffle fresh off the griddle. The skin is textured with the familiar grid pattern of a waffle, each square filled with a glistening sheen of syrup. The environment combines the natural habitat of a hippo with elements of a breakfast table setting, a river of warm, melted butter, with oversized utensils or plates peeking out from the lush, pancake-like foliage in the background, a towering pepper mill standing in for a tree.  As the sun rises in this fantastical world, it casts a warm, buttery glow over the scene. The creature, content in its butter river, lets out a yawn. Nearby, a flock of birds take flight"

image = pipe(
    prompt=prompt,
    negative_prompt="",
    num_inference_steps=28,
    guidance_scale=4.5,
    max_sequence_length=512,
).images[0]
Enviar un prompt diferente al codificador de texto T5
Puede enviar un prompt diferente a los CLIP Text Encoders y al T5 Text Encoder para evitar que el prompt se trunque por los CLIP Text Encoders y mejorar la generación.
El prompt con los codificadores de texto de CLIP sigue truncado al límite de 77 tokens.
prompt = "A whimsical and creative image depicting a hybrid creature that is a mix of a waffle and a hippopotamus, basking in a river of melted butter amidst a breakfast-themed landscape. A river of warm, melted butter, pancake-like foliage in the background, a towering pepper mill standing in for a tree."

prompt_3 = "A whimsical and creative image depicting a hybrid creature that is a mix of a waffle and a hippopotamus, basking in a river of melted butter amidst a breakfast-themed landscape. It features the distinctive, bulky body shape of a hippo. However, instead of the usual grey skin, the creature’s body resembles a golden-brown, crispy waffle fresh off the griddle. The skin is textured with the familiar grid pattern of a waffle, each square filled with a glistening sheen of syrup. The environment combines the natural habitat of a hippo with elements of a breakfast table setting, a river of warm, melted butter, with oversized utensils or plates peeking out from the lush, pancake-like foliage in the background, a towering pepper mill standing in for a tree.  As the sun rises in this fantastical world, it casts a warm, buttery glow over the scene. The creature, content in its butter river, lets out a yawn. Nearby, a flock of birds take flight"

image = pipe(
    prompt=prompt,
    prompt_3=prompt_3,
    negative_prompt="",
    num_inference_steps=28,
    guidance_scale=4.5,
    max_sequence_length=512,
).images[0]
Tiny AutoEncoder para Stable Diffusion 3
Tiny AutoEncoder for Stable Diffusion (TAESD3) es una versión destilada y compacta del VAE de Stable Diffusion 3, creada por Ollin Boer Bohan, que puede decodificar los latentes de StableDiffusion3Pipeline casi al instante.
Para usar con Stable Diffusion 3:
import torch
from diffusers import StableDiffusion3Pipeline, AutoencoderTiny

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3-medium-diffusers", dtype=torch.float16
)
pipe.vae = AutoencoderTiny.from_pretrained("madebyollin/taesd3", dtype=torch.float16)
pipe = pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "slice of delicious New York-style berry cheesecake"
image = pipe(prompt, num_inference_steps=25).images[0]
image.save("cheesecake.png")
Cargar los puntos de control originales mediante from_single_file
Las clases SD3Transformer2DModel y StableDiffusion3Pipeline admiten la carga de los puntos de control originales mediante el método from_single_file. Este método permite cargar los archivos de punto de control originales que se utilizaron para entrenar los modelos.
Carga de los puntos de control originales para el SD3Transformer2DModel
from diffusers import SD3Transformer2DModel

model = SD3Transformer2DModel.from_single_file("https://huggingface.co/stabilityai/stable-diffusion-3-medium/blob/main/sd3_medium.safetensors")
Carga del único punto de control para StableDiffusion3Pipeline
Carga del punto de control de archivo único sin T5
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-3-medium/blob/main/sd3_medium_incl_clips.safetensors",
    dtype=torch.float16,
    text_encoder_3=None
)
pipe.enable_model_cpu_offload()

image = pipe("a picture of a cat holding a sign that says hello world").images[0]
image.save('sd3-single-file.png')
Carga del punto de control de archivo único con T5
El siguiente ejemplo carga un punto de control almacenado en un formato de punto flotante de 8 bits, que requiere PyTorch 2.3 o posterior.
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-3-medium/blob/main/sd3_medium_incl_clips_t5xxlfp8.safetensors",
    dtype=torch.float16,
)
pipe.enable_model_cpu_offload()

image = pipe("a picture of a cat holding a sign that says hello world").images[0]
image.save('sd3-single-file-t5-fp8.png')
Carga del punto de control de archivo único para el modelo Transformer de Stable Diffusion 3.5
import torch
from diffusers import SD3Transformer2DModel, StableDiffusion3Pipeline

transformer = SD3Transformer2DModel.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-3.5-large-turbo/blob/main/sd3.5_large.safetensors",
    dtype=torch.bfloat16,
)
pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-large",
    transformer=transformer,
    dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()
image = pipe("a cat holding a sign that says hello world").images[0]
image.save("sd35.png")
StableDiffusion3Pipeline
clase diffusers.StableDiffusion3Pipeline
< source >( transformer: SD3Transformer2DModelscheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizertext_encoder_2: CLIPTextModelWithProjectiontokenizer_2: CLIPTokenizertext_encoder_3: T5EncoderModeltokenizer_3: T5Tokenizerimage_encoder: SiglipVisionModel = Nonefeature_extractor: SiglipImageProcessorPil = None )
Parámetros
- transformer (SD3Transformer2DModel) — Arquitectura Conditional Transformer (MMDiT) para desruidar los latentes de imagen codificados.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Un scheduler para usar en combinación con
transformerpara desruidar los latentes de imagen codificados. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes a partir de y hacia representaciones latentes.
- text_encoder (
CLIPTextModelWithProjection) — CLIP, específicamente la variante clip-vit-large-patch14, con una capa de proyección adicional que se inicializa con una matriz diagonal de dimensiónhidden_size. - text_encoder_2 (
CLIPTextModelWithProjection) — CLIP, específicamente la variante laion/CLIP-ViT-bigG-14-laion2B-39B-b160k. - text_encoder_3 (
T5EncoderModel) — Codificador de texto congelado. Stable Diffusion 3 utiliza T5, específicamente la variante t5-v1_1-xxl. - tokenizer (
CLIPTokenizer) — Tokenizer de la clase CLIPTokenizer. - tokenizer_2 (
CLIPTokenizer) — Segundo Tokenizador de la clase CLIPTokenizer. - tokenizer_3 (
T5TokenizerFast) — Tokenizador de la clase T5Tokenizer. - image_encoder (
SiglipVisionModel, opcional) — Modelo de visión preentrenado para IP Adapter. - feature_extractor (
SiglipImageProcessor, opcional) — Procesador de imágenes para IP Adapter.
__call__
< source >( prompt: str | list[str] = Noneprompt_2: str | list[str] | None = Noneprompt_3: str | list[str] | None = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 28sigmas: list[float] | None = Noneguidance_scale: float = 7.0negative_prompt: str | list[str] | None = Nonenegative_prompt_2: str | list[str] | None = Nonenegative_prompt_3: str | list[str] | None = Nonenum_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.FloatTensor] = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truejoint_attention_kwargs: dict[str, typing.Any] | None = Noneclip_skip: int | None = Nonecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents']max_sequence_length: int = 256skip_guidance_layers: list = Noneskip_layer_guidance_scale: float = 2.8skip_layer_guidance_stop: float = 0.2skip_layer_guidance_start: float = 0.01mu: float | None = None ) → ~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutput or tuple
Parámetros
- prompt (
strolist[str], opcional) — El prompt o los prompts para guiar la generación de la imagen. Si no se define, hay que pasarprompt_embedsen su lugar. - prompt_2 (
strolist[str], opcional) — El prompt o prompts que se enviarán atokenizer_2ytext_encoder_2. Si no está definido, se utilizaráprompten su lugar - prompt_3 (
strolist[str], opcional) — El prompt o los prompts que se enviarán atokenizer_3ytext_encoder_3. Si no está definido, se utilizaráprompten su lugar - height (
int, opcional, por defecto self.unet.config.sample_size * self.vae_scale_factor) — La altura en píxeles de la imagen generada. Por defecto, se establece en 1024 para obtener los mejores resultados. - width (
int, opcional, valor predeterminado self.unet.config.sample_size * self.vae_scale_factor) — El ancho en píxeles de la imagen generada. Por defecto, se establece en 1024 para obtener los mejores resultados. - num_inference_steps (
int, opcional, valor predeterminado 50) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - sigmas (
list[float], opcional) — Sigmas personalizados para usar en el proceso de desruido con programadores que admiten un argumentosigmasen su métodoset_timesteps. Si no se define, se usará el comportamiento predeterminado cuando se pasenum_inference_steps. - guidance_scale (
float, opcional, valor predeterminado 7.0) — Escala de guía definida en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 del Imagen Paper. La escala de guía se habilita estableciendoguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - negative_prompt (
strolist[str], opcional) — El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasarnegative_prompt_embedsen su lugar. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - negative_prompt_2 (
strolist[str], opcional) — El prompt o prompts que no deben guiar la generación de la imagen y que se enviarán atokenizer_2ytext_encoder_2. Si no se define, se utilizanegative_prompten su lugar - negative_prompt_3 (
strolist[str], opcional) — El prompt o prompts que no deben guiar la generación de la imagen y que se enviarán atokenizer_3ytext_encoder_3. Si no se define, se utilizanegative_prompten su lugar - num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.FloatTensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. ponderación de prompts. Si no se proporcionan, las incrustaciones de texto se generarán a partir del argumento de entradaprompt. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto negativo pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. el ponderado del prompt. Si no se proporciona, negative_prompt_embeds se generará a partir del argumento de entradanegative_prompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto agrupadas pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. ponderación de prompts. Si no se proporciona, las incrustaciones de texto agrupadas se generarán a partir del argumento de entradaprompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto negativo agrupadas pregeneradas. Se pueden utilizar para ajustar fácilmente las entradas de texto, p. ej. el ponderado del prompt. Si no se proporciona, se generarán pooled negative_prompt_embeds a partir del argumento de entradanegative_prompt. - ip_adapter_image (
PipelineImageInput, opcional) — Entrada de imagen opcional para trabajar con IP Adapters. - ip_adapter_image_embeds (
torch.Tensor, opcional) — Incrustaciones de imagen pregeneradas para IP-Adapter. Debe ser un tensor de forma(batch_size, num_images, emb_dim). Debe contener la incrustación de imagen negativa sido_classifier_free_guidanceestá establecido enTrue. Si no se proporciona, las incrustaciones se calculan a partir del argumento de entradaip_adapter_image. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre PIL:PIL.Image.Imageonp.array. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutputen lugar de una tupla simple. - joint_attention_kwargs (
dict, opcional) — Un diccionario de kwargs que, si se especifica, se pasa alAttentionProcessordefinido enself.processordentro de diffusers.models.attention_processor. - clip_skip (
int, opcional) — Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la penúltima capa para calcular los embeddings del prompt. - callback_on_step_end (
Callable, opcional) — Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá una lista de todos los tensores especificados porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — La lista de entradas de tensor para la funcióncallback_on_step_end. Los tensores especificados en la lista se pasarán como argumentocallback_kwargs. Solo podrás incluir variables listadas en el atributo._callback_tensor_inputsde tu clase de pipeline. - max_sequence_length (
intpor defecto 256) — Longitud máxima de secuencia para usar con elprompt. - skip_guidance_layers (
list[int], opcional) — Una lista de enteros que especifica las capas que se deben omitir durante la guía. Si no se proporciona, se utilizarán todas las capas para la guía. Si se proporciona, la guía solo se aplicará a las capas especificadas en la lista. El valor recomendado por StabiltyAI para Stable Diffusion 3.5 Medium es [7, 8, 9]. - skip_layer_guidance_scale (
int, opcional) — La escala de la guía para las capas especificadas enskip_guidance_layers. La guía se aplicará a las capas especificadas enskip_guidance_layerscon una escala deskip_layer_guidance_scale. La guía se aplicará al resto de las capas con una escala de1. - skip_layer_guidance_stop (
int, opcional) — El paso en el que se detendrá la guía para las capas especificadas enskip_guidance_layers. La guía se aplicará a las capas especificadas enskip_guidance_layershasta la fracción especificada enskip_layer_guidance_stop. El valor recomendado por StabiltyAI para Stable Diffusion 3.5 Medium es 0.2. - skip_layer_guidance_start (
int, opcional) — El paso en el que comenzará la guía para las capas especificadas enskip_guidance_layers. La guía se aplicará a las capas especificadas enskip_guidance_layersa partir de la fracción especificada enskip_layer_guidance_start. El valor recomendado por StabiltyAI para Stable Diffusion 3.5 Medium es 0.01. - mu (
float, opcional) — valor demuutilizado paradynamic_shifting.
Devuelve
~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutput o tuple
~pipelines.stable_diffusion_3.StableDiffusion3PipelineOutput si return_dict es True, de lo contrario una
tuple. Al devolver una tupla, el primer elemento es una lista con las imágenes generadas.
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
>>> import torch
>>> from diffusers import StableDiffusion3Pipeline

>>> pipe = StableDiffusion3Pipeline.from_pretrained(
...     "stabilityai/stable-diffusion-3-medium-diffusers", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")
>>> prompt = "A cat holding a sign that says hello world"
>>> image = pipe(prompt).images[0]
>>> image.save("sd3.png")
encode_image
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]device: device ) → torch.Tensor
Codifica la imagen dada en una representación de características utilizando un codificador de imágenes preentrenado.
encode_prompt
< source >( prompt: str | list[str]prompt_2: str | list[str]prompt_3: str | list[str]device: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1do_classifier_free_guidance: bool = Truenegative_prompt: str | list[str] | None = Nonenegative_prompt_2: str | list[str] | None = Nonenegative_prompt_3: str | list[str] | None = Noneprompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonepooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Nonenegative_pooled_prompt_embeds: typing.Optional[torch.FloatTensor] = Noneclip_skip: int | None = Nonemax_sequence_length: int = 256lora_scale: float | None = None )
Parámetros
- prompt (
strolist[str], opcional) — prompt a codificar - prompt_2 (
strolist[str], opcional) — El prompt o prompts que se enviarán altokenizer_2y altext_encoder_2. Si no se define, se utilizaprompten todos los text-encoders - prompt_3 (
strolist[str], opcional) — El prompt o prompts que se enviarán altokenizer_3y altext_encoder_3. Si no se define, se utilizaprompten todos los text-encoders - device — (
torch.device): dispositivo de torch - num_images_per_prompt (
int) — número de imágenes que deben generarse por prompt - do_classifier_free_guidance (
bool) — si se debe usar classifier free guidance o no - negative_prompt (
strolist[str], opcional) — El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasarnegative_prompt_embedsen su lugar. Se ignora cuando no se usa guía (es decir, se ignora siguidance_scalees menor que1). - negative_prompt_2 (
strolist[str], opcional) — El prompt o prompts que no deben guiar la generación de la imagen y que se enviarán atokenizer_2ytext_encoder_2. Si no se define, se utilizanegative_prompten todos los text-encoders. - negative_prompt_3 (
strolist[str], opcional) — El prompt o prompts que no deben guiar la generación de la imagen y que se enviarán atokenizer_3ytext_encoder_3. Si no se define, se utilizanegative_prompten todos los text-encoders. - prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. ponderación de prompts. Si no se proporcionan, las incrustaciones de texto se generarán a partir del argumento de entradaprompt. - negative_prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto negativo pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. el ponderado del prompt. Si no se proporciona, negative_prompt_embeds se generará a partir del argumento de entradanegative_prompt. - pooled_prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto agrupadas pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto, p. ej. ponderación de prompts. Si no se proporciona, las incrustaciones de texto agrupadas se generarán a partir del argumento de entradaprompt. - negative_pooled_prompt_embeds (
torch.FloatTensor, opcional) — Incrustaciones de texto negativo agrupadas pregeneradas. Se pueden utilizar para ajustar fácilmente las entradas de texto, p. ej. el ponderado del prompt. Si no se proporciona, se generarán pooled negative_prompt_embeds a partir del argumento de entradanegative_prompt. - clip_skip (
int, opcional) — Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la penúltima capa para calcular los embeddings del prompt. - lora_scale (
float, opcional) — Una escala LoRA que se aplicará a todas las capas LoRA del codificador de texto si se cargan capas LoRA.
prepare_ip_adapter_image_embeds
< source >( ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = Noneip_adapter_image_embeds: typing.Optional[torch.Tensor] = Nonedevice: typing.Optional[torch.device] = Nonenum_images_per_prompt: int = 1do_classifier_free_guidance: bool = True )
Parámetros
- ip_adapter_image (
PipelineImageInput, opcional) — La imagen de entrada de la que se extraerán las características para IP-Adapter. - ip_adapter_image_embeds (
torch.Tensor, opcional) — Incrustaciones de imagen precalculadas. - device — (
torch.device, opcional): Dispositivo de Torch. - num_images_per_prompt (
int, por defecto 1) — Número de imágenes que deben generarse por prompt. - do_classifier_free_guidance (
bool, por defecto True) — Si se debe usar classifier free guidance o no.
Prepara los embeddings de imagen para su uso en el IP-Adapter.
Se debe pasar ip_adapter_image o ip_adapter_image_embeds.