# Nougat
## Tổng quan
Mô hình Nougat được đề xuất trong [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418) bởi Lukas Blecher, Guillem Cucurull, Thomas Scialom, Robert Stojnic. Nougat sử dụng cùng kiến trúc với [Donut](donut), bao gồm một bộ mã hóa Transformer cho ảnh và một bộ giải mã Transformer tự hồi quy cho văn bản, nhằm chuyển đổi các PDF khoa học sang định dạng markdown, giúp việc truy cập chúng trở nên dễ dàng hơn.
Tóm tắt từ bài báo như sau:
*Tri thức khoa học chủ yếu được lưu trữ trong sách và các tạp chí khoa học, thường ở định dạng PDF. Tuy nhiên, định dạng PDF dẫn đến việc mất thông tin ngữ nghĩa, đặc biệt là đối với các biểu thức toán học. Chúng tôi đề xuất Nougat (Neural Optical Understanding for Academic Documents), một mô hình Visual Transformer thực hiện tác vụ Nhận dạng ký tự quang học (OCR) để xử lý các tài liệu khoa học thành một ngôn ngữ đánh dấu, và chứng minh hiệu quả của mô hình trên một bộ dữ liệu mới gồm các tài liệu khoa học. Phương pháp đề xuất mang đến một giải pháp đầy hứa hẹn nhằm nâng cao khả năng tiếp cận tri thức khoa học trong kỷ nguyên số, bằng cách thu hẹp khoảng cách giữa các tài liệu con người có thể đọc được và văn bản máy có thể đọc được. Chúng tôi công bố các mô hình và mã nguồn để thúc đẩy các nghiên cứu tiếp theo về nhận dạng văn bản khoa học.*
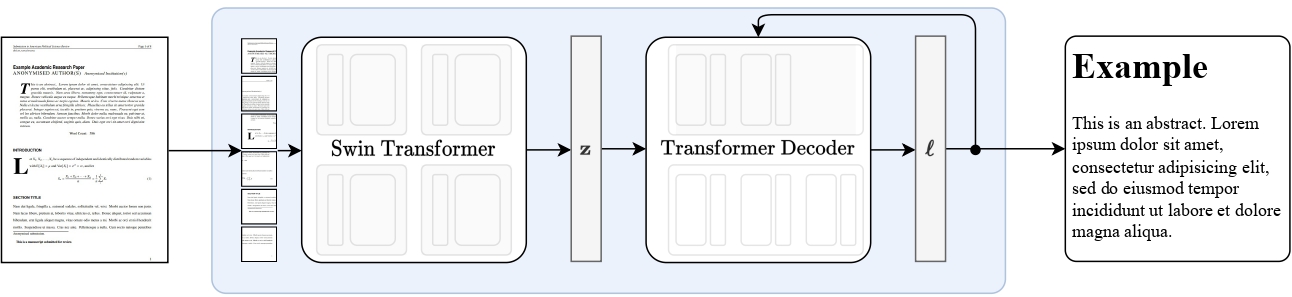 Tổng quan cấp cao của Nougat. Được trích từ bài báo gốc.
Mô hình này được đóng góp bởi [nielsr](https://huggingface.co/nielsr). Mã gốc có thể được tìm thấy [tại đây](https://github.com/facebookresearch/nougat).
## Mẹo sử dụng
- Cách nhanh nhất để bắt đầu với Nougat là xem các [notebook hướng dẫn](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat), trong đó cho thấy cách sử dụng mô hình ở thời điểm suy luận cũng như tinh chỉnh trên dữ liệu tùy chỉnh.
- Nougat luôn được sử dụng trong khuôn khổ [VisionEncoderDecoder](vision-encoder-decoder). Về kiến trúc, mô hình này giống hệt với [Donut](donut).
## Suy luận
Mô hình `VisionEncoderDecoder` của Nougat nhận ảnh làm đầu vào và sử dụng [generate()](/docs/transformers/v5.23.0/vi/main_classes/text_generation#transformers.GenerationMixin.generate) để tự hồi quy tạo ra văn bản dựa trên ảnh đầu vào.
Lớp [NougatImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatImageProcessor) chịu trách nhiệm tiền xử lý ảnh đầu vào và [NougatTokenizerFast](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatTokenizer) giải mã các token đích được tạo ra thành chuỗi đích. Lớp [NougatProcessor](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatProcessor) đóng gói các lớp [NougatImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatImageProcessor) và [NougatTokenizerFast](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatTokenizer) thành một instance duy nhất để vừa trích xuất các đặc trưng đầu vào vừa giải mã các id token dự đoán.
- Chuyển đổi văn bản từ PDF từng bước
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Xem [model hub](https://huggingface.co/models?filter=nougat) để tìm các checkpoint của Nougat.
Mô hình có kiến trúc giống hệt với [Donut](donut).
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L28)
**Tham số:**
is_encoder_decoder (`bool`, *tùy chọn*, mặc định là `True`) : Xác định xem mô hình có được sử dụng như một bộ mã hóa/giải mã hay không.
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Đối tượng config hoặc từ điển của bộ khung encoder.
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Đối tượng config hoặc từ điển của bộ khung giải mã (decoder backbone).
Đây là lớp cấu hình để lưu trữ cấu hình của một NougatModel. Nó được sử dụng để khởi tạo một mô hình Nougat theo các đối số được chỉ định, xác định kiến trúc mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [facebook/nougat-base](https://huggingface.co/facebook/nougat-base)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/v5.23.0/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/v5.23.0/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L52)
**Trả về:** [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/vi/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
Một đối tượng cấu hình
Tạo một [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/vi/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig) (hoặc một lớp kế thừa) từ cấu hình mô hình encoder và cấu hình mô hình decoder đã được huấn luyện trước.
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L57)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 896, 'width': 672}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `2`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.485, 0.456, 0.406]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.229, 0.224, 0.225]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_crop_margin (`bool`, *kwargs*, *optional*, mặc định là `self.do_crop_margin`) : Có nên cắt bỏ các phần lề của hình ảnh hay không.
do_thumbnail (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `self.do_thumbnail`) : Có nên điều chỉnh kích thước ảnh bằng phương thức thumbnail hay không.
do_align_long_axis (`bool`, *kwargs*, *optional*, mặc định là `self.do_align_long_axis`) : Có nên căn trục dài của hình ảnh với trục dài của `size` bằng cách xoay 90 độ hay không.
Tạo một bộ xử lý ảnh NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L74)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_crop_margin (`bool`, *kwargs*, *optional*, mặc định là `self.do_crop_margin`) : Có nên cắt bỏ các phần lề của hình ảnh hay không.
do_thumbnail (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `self.do_thumbnail`) : Có nên điều chỉnh kích thước ảnh bằng phương thức thumbnail hay không.
do_align_long_axis (`bool`, *kwargs*, *optional*, mặc định là `self.do_align_long_axis`) : Có nên căn trục dài của hình ảnh với trục dài của `size` bằng cách xoay 90 độ hay không.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 896, 'width': 672}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `2`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.485, 0.456, 0.406]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.229, 0.224, 0.225]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_crop_margin (`bool`, *kwargs*, *optional*, mặc định là `self.do_crop_margin`) : Có nên cắt bỏ các phần lề của hình ảnh hay không.
do_thumbnail (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `self.do_thumbnail`) : Có nên điều chỉnh kích thước ảnh bằng phương thức thumbnail hay không.
do_align_long_axis (`bool`, *kwargs*, *optional*, mặc định là `self.do_align_long_axis`) : Có nên căn trục dài của hình ảnh với trục dài của `size` bằng cách xoay 90 độ hay không.
Tạo một bộ xử lý ảnh NougatImageProcessor.
#### preprocess[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_crop_margin (`bool`, *kwargs*, *optional*, mặc định là `self.do_crop_margin`) : Có nên cắt bỏ các phần lề của hình ảnh hay không.
do_thumbnail (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `self.do_thumbnail`) : Có nên điều chỉnh kích thước ảnh bằng phương thức thumbnail hay không.
do_align_long_axis (`bool`, *kwargs*, *optional*, mặc định là `self.do_align_long_axis`) : Có nên căn trục dài của hình ảnh với trục dài của `size` bằng cách xoay 90 độ hay không.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L347)
**Tham số:**
vocab_file (`str`, *tùy chọn*) : Đường dẫn đến tệp từ vựng.
merges_file (`str`, *tùy chọn*) : Đường dẫn đến tệp merges.
tokenizer_file (`str`, *tùy chọn*) : tệp [tokenizers](https://github.com/huggingface/tokenizers) (thường có phần mở rộng .json) chứa mọi thứ cần thiết để nạp tokenizer.
clean_up_tokenization_spaces (`str`, *tùy chọn*, mặc định là `False`) : Có dọn dẹp khoảng trắng sau khi giải mã hay không, việc dọn dẹp bao gồm việc loại bỏ các sản phẩm phụ tiềm ẩn như khoảng trắng thừa.
unk_token (`str`, *tùy chọn*, mặc định là `""`) : Token không xác định. Một token không có trong từ vựng sẽ không thể được chuyển đổi thành ID và sẽ được gán thành token này thay thế.
bos_token (`str`, *tùy chọn*, mặc định là `""`) : Token bắt đầu chuỗi được sử dụng trong quá trình tiền huấn luyện. Có thể được dùng làm token phân loại chuỗi.
eos_token (`str`, *tùy chọn*, mặc định là `""`) : Token kết thúc chuỗi.
pad_token (`str`, *tùy chọn*, mặc định là `""`) : Token được sử dụng để đệm, chẳng hạn khi xử lý các lô (batch) các chuỗi có độ dài khác nhau.
vocab (`str`, `dict` hoặc `list`, *tùy chọn*) : Từ điển từ vựng tùy chỉnh. Nếu không được cung cấp, từ vựng sẽ được tải từ vocab_file.
merges (`str` hoặc `list`, *tùy chọn*) : Danh sách gộp tùy chỉnh. Nếu không được cung cấp, các gộp sẽ được tải từ merges_file.
Tokenizer cho Nougat (dựa trên thư viện HuggingFace tokenizers).
Tokenizer này kế thừa từ [TokenizersBackend](/docs/transformers/v5.23.0/vi/main_classes/tokenizer#transformers.TokenizersBackend), lớp chứa hầu hết các phương thức chính. Người dùng nên tham khảo siêu lớp này để biết thêm thông tin về các phương thức đó. Lớp này chủ yếu bổ sung các phương thức đặc thù của Nougat để xử lý hậu kỳ văn bản đã tạo.
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L493)
**Tham số:**
generation (str) : Văn bản được tạo ra để xử lý hậu kỳ.
**Trả về:** `str`
Văn bản đã được xử lý hậu kỳ.
Nhận một chuỗi đã được tạo và sửa các bảng/dạng bảng để chúng khớp với định dạng markdown cần thiết.
Ví dụ:
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L623)
**Tham số:**
generation (Union[str, list[str]]) : Văn bản được tạo ra hoặc một danh sách các văn bản được tạo ra.
fix_markdown (`bool`, *tùy chọn*, mặc định là `True`) : Có thực hiện các sửa lỗi định dạng Markdown hay không.
num_workers (`int`, *optional*) : Số lượng worker tùy chọn để truyền vào nhằm tận dụng đa tiến trình (tiền xử lý nhiều văn bản song song).
**Trả về:** Union[str, list[str]]
Văn bản đã được xử lý hậu kỳ hoặc danh sách các văn bản đã được xử lý hậu kỳ.
Xử lý hậu một văn bản đã tạo hoặc một danh sách các văn bản đã tạo.
Hàm này có thể được sử dụng để thực hiện xử lý hậu kỳ trên văn bản đã tạo, chẳng hạn như sửa định dạng Markdown.
Postprocessing khá chậm nên khuyến nghị sử dụng multiprocessing để tăng tốc quá trình.
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L528)
**Tham số:**
generation (str) : Văn bản được tạo ra để xử lý hậu kỳ.
fix_markdown (bool, optional) : Có thực hiện các sửa lỗi định dạng Markdown hay không. Mặc định là True.
**Trả về:** `str`
Văn bản đã được xử lý hậu kỳ.
Xử lý hậu kỳ một văn bản được tạo duy nhất. Các biểu thức chính quy được sử dụng ở đây được lấy trực tiếp từ các tác giả của bài viết Nougat. Các biểu thức này được chú thích để rõ ràng và được kiểm thử đầu-cuối trong hầu hết các trường hợp.
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L463)
**Tham số:**
text (`str`) : Văn bản đầu vào chứa các tham chiếu.
**Trả về:** `str`
Văn bản đã được loại bỏ các tham chiếu bị ảo giác.
Loại bỏ các tham chiếu bị ảo tưởng hoặc thiếu sót khỏi văn bản.
Hàm này xác định và loại bỏ các tham chiếu được đánh dấu là thiếu hoặc bị ảo giác khỏi văn bản đầu vào.
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L24)
**Tham số:**
image_processor (`NougatImageProcessor`) : Bộ xử lý ảnh là một đầu vào bắt buộc.
tokenizer (`NougatTokenizer`) : Tokenizer là một đầu vào bắt buộc.
Tạo một NougatProcessor đóng gói một bộ xử lý ảnh và một tokenizer thành một bộ xử lý duy nhất.
[NougatProcessor](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatProcessor) cung cấp đầy đủ các chức năng của [NougatImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatImageProcessor) và [NougatTokenizer](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatTokenizer). Xem [~NougatImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatImageProcessor) và [~NougatTokenizer](/docs/transformers/v5.23.0/vi/model_doc/nougat#transformers.NougatTokenizer) để biết thêm thông tin.
#### __call__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L32)
**Tham số:**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
return_tensors (`str` hoặc [TensorType](/docs/transformers/v5.23.0/vi/internal/file_utils#transformers.TensorType), *optional*) : Nếu được đặt, sẽ trả về các tensor của một framework cụ thể. Các giá trị chấp nhận được là: - `'pt'`: Trả về các đối tượng `torch.Tensor` của PyTorch. - `'np'`: Trả về các đối tượng `np.ndarray` của NumPy.
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1799)
**Tham số:**
pretrained_model_name_or_path (`str` hoặc `os.PathLike`) : Có thể là một trong các trường hợp sau: - một chuỗi, *model id* của một feature_extractor được huấn luyện trước và lưu trữ trong kho model trên huggingface.co. - đường dẫn đến một *thư mục* chứa tệp feature extractor đã được lưu bằng phương thức [save_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained), ví dụ: `./my_model_directory/`. - đường dẫn đến tệp JSON *file* của feature extractor đã lưu, ví dụ: `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : Các đối số từ khóa bổ sung được truyền đến cả [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) và `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`.
Tạo một processor liên kết với một model được huấn luyện trước.
Phương thức lớp này đơn giản là gọi phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) của bộ trích xuất đặc trưng, [ImageProcessingMixin](/docs/transformers/v5.23.0/vi/internal/image_processing_utils#transformers.ImageProcessingMixin) của bộ xử lý ảnh và `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` của bộ phân từ. Vui lòng tham khảo các docstring của các phương thức ở trên để biết thêm thông tin.
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1182)
**Tham số:**
save_directory (`str` hoặc `os.PathLike`) : Thư mục nơi tệp JSON của feature extractor và các tệp tokenizer sẽ được lưu (thư mục sẽ được tạo nếu chưa tồn tại).
push_to_hub (`bool`, *tùy chọn*, mặc định là `False`) : Có đẩy mô hình của bạn lên Hugging Face model hub sau khi lưu hay không. Bạn có thể chỉ định kho lưu trữ muốn đẩy đến bằng `repo_id` (mặc định sẽ là tên của `save_directory` trong namespace của bạn).
kwargs (`dict[str, Any]`, *tùy chọn*) : Các đối số từ khóa bổ sung được truyền đến phương thức [push_to_hub()](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub).
Lưu các thuộc tính của bộ xử lý này (bộ trích xuất đặc trưng, bộ phân từ...) vào thư mục được chỉ định để có thể tải lại bằng phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained).
Phương thức lớp này đơn giản chỉ gọi [save_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) và [save_pretrained()](/docs/transformers/v5.23.0/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained). Vui lòng tham khảo docstring của các phương thức ở trên để biết thêm thông tin.
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2054)
Phương pháp này chuyển tiếp tất cả các đối số của nó đến [batch_decode()](/docs/transformers/v5.23.0/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) của PreTrainedTokenizer. Vui lòng tham khảo docstring của phương pháp này để biết thêm thông tin.
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2063)
Phương pháp này chuyển tiếp tất cả các đối số của nó đến [decode()](/docs/transformers/v5.23.0/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) của PreTrainedTokenizer. Vui lòng tham khảo docstring của phương pháp này để biết thêm thông tin.
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L40)
Phương pháp này chuyển tiếp tất cả các đối số của nó đến `~PreTrainedTokenizer.post_process_generation` của NougatTokenizer. Vui lòng tham khảo docstring của phương pháp này để biết thêm thông tin.